EdgeSpeak:端侧语音 AI 一应俱全——转录、播报、对齐、翻译、音乐、LLM
转录、播报、对齐、音乐生成、翻译,再加上说话人分离和实时语音对话,EdgeSpeak 把整套语音 AI 都放在端侧。一段 26 分钟、4 人轮流发言的发布会录音,在 Apple M5 上 33 秒完成转录、内存峰值约 1.0 GB。
能力不止于转录:346 种语言的强制对齐,38 种语言的本机翻译,11 款播报模型,YuE2 按歌词生成带人声和伴奏的完整歌曲;13 个 MCP 工具让 Claude Code 这类 Agent 直接调用。macOS(Apple Silicon)和 Windows 都有桌面版和 CLI,Linux 提供 CLI,音视频和转录稿都留在你的电脑上。
识别准、速度快、占用低
我们做了大量优化,让本地模型在普通电脑上也能跑得快、识别准:把模型压缩量化到适合端侧的大小;推理引擎分别针对 Apple Silicon 的 Metal、NVIDIA 显卡的 CUDA 和通用的 Vulkan 做了加速,没有独立显卡的电脑也能用 CPU 运行。
开头那段 26 分钟的发布会录音,在 Apple M5 上的完整实测:
| 项目 | 结果 |
|---|---|
| 识别准确率 | 词错误率(WER)6.6% |
| 转录速度 | 33 秒转完,约 48 倍实时 |
| 对齐速度 | 已有文稿对到音频,8.8 秒完成 |
| 内存占用 | 转录进程峰值约 1.0 GB |
在 Windows 上,用 NVIDIA RTX 3060 显卡转录,实时率约 0.04,相当于约 25 倍实时。配置较低的电脑可以选更轻的 Lattice-2 Lite。不同电脑上的耗时会不同。
模型阵容
| 能力 | 模型 |
|---|---|
| 语音识别 | Lattice-2 Lite / Flash / Pro,三档按电脑配置和精度需求选 |
| 强制对齐 | Lattice-2,覆盖 346 种语言 |
| 本机翻译 | Lattice-2 Lite / Flash / Pro 翻译模型,支持 38 种目标语言,提供翻译 API |
| 语音对话 | 内置 Qwen 与 Gemma 0.6B–27B 多个模型,也可以导入兼容的 GGUF 模型 |
| 播报 | 11 款:Qwen3-TTS(0.6B / 1.7B 的 Base、CustomVoice,以及 1.7B VoiceDesign)、FireRedTTS3(Instruct、Base)、OmniVoice、IndexTTS-2.5、VoxCPM2、Breeze-TTS-2,支持流式播报、音色克隆和按描述设计声音 |
| 音乐生成 | YuE2,把歌词生成为带人声和伴奏的完整歌曲,免费使用 |
模型在应用里按需下载,下载后离线可用。
多语言
EdgeSpeak 的模型从一开始就是多语言的,不只服务中文和英文:
| 能力 | 语言覆盖 |
|---|---|
| 转录 | 40 多种语言,包括中文、粤语、英语、日语、韩语、阿拉伯语、印地语、泰语、越南语和主要欧洲语言 |
| 强制对齐 | 346 种语言,同一段文本里混着几种语言也能对齐 |
| 翻译 | 38 种目标语言,包括繁体中文和维吾尔语 |
| 播报 | OmniVoice 覆盖语言目录中的全部语言并接受更多 ISO 639 语言;FireRedTTS3 支持 24 种语言和四川话等 21 种汉语方言;Qwen3-TTS 支持 10 种语言 |
每种语言具体支持哪些能力,见语言指南。
语音识别
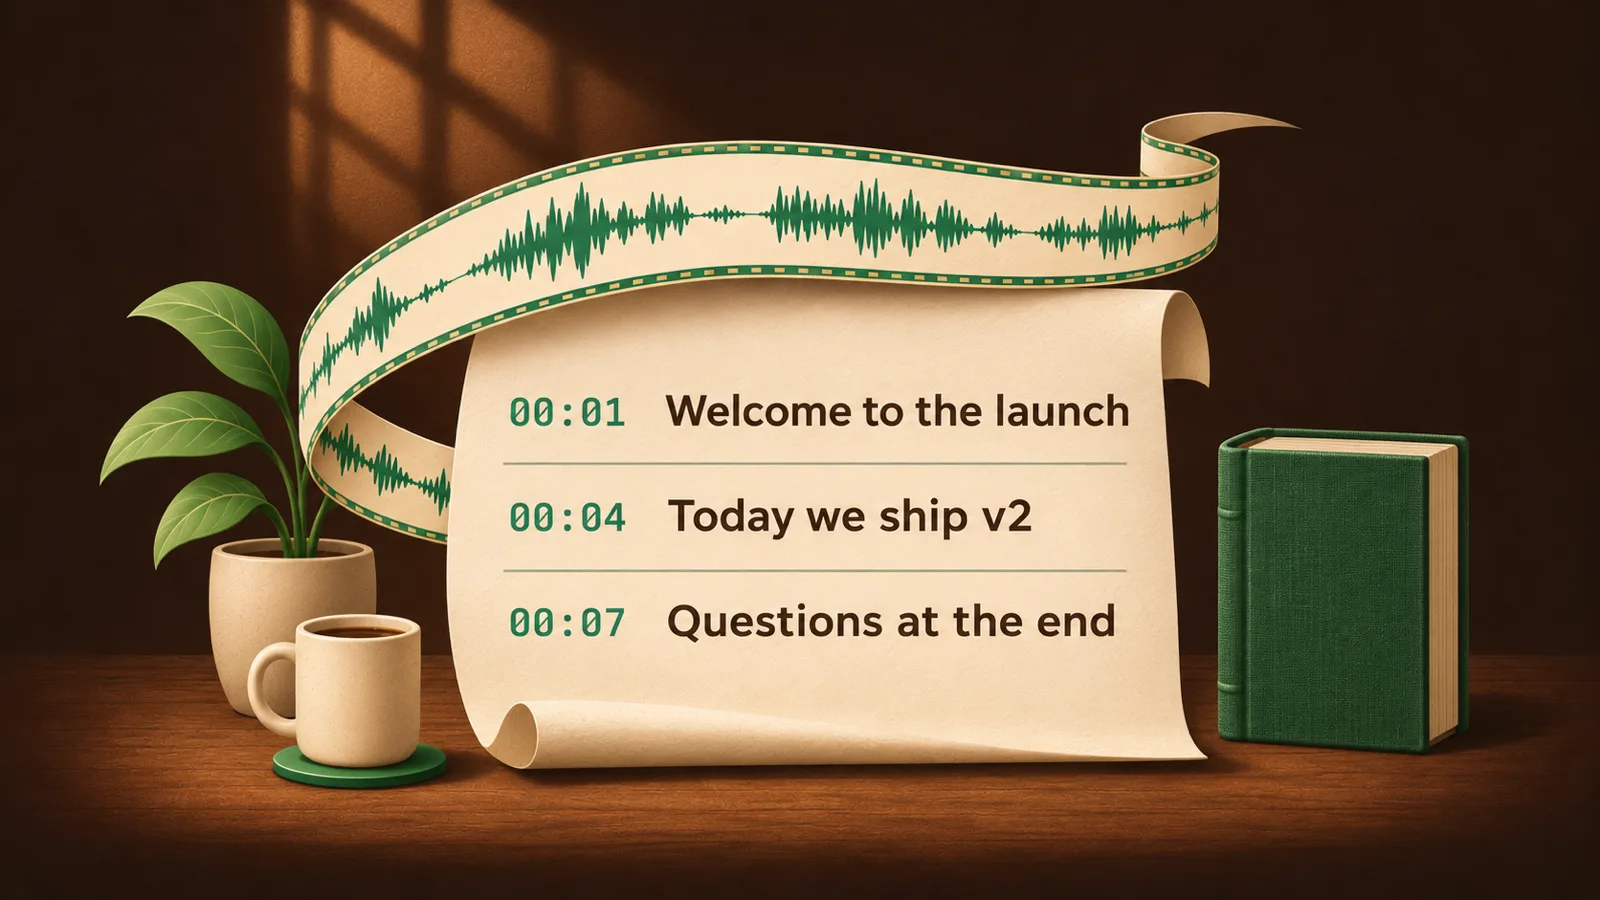
导入音频或视频,转成带时间的文字稿,支持 40 多种语言,具体范围见语言指南。可以导出纯文本、SRT、VTT 字幕或 JSON。人名、产品名和术语加进词典,转录时更容易识别对,翻译时按你设的写法输出。Lattice-2 分 Lite、Flash、Pro 三档:Lite 占用最少,适合轻薄本;Flash 是默认档,速度和准确率兼顾;Pro 准确率更高。111.7 秒的英文录音,Flash 约 2.6 秒转完。详见语音转文字。
强制对齐
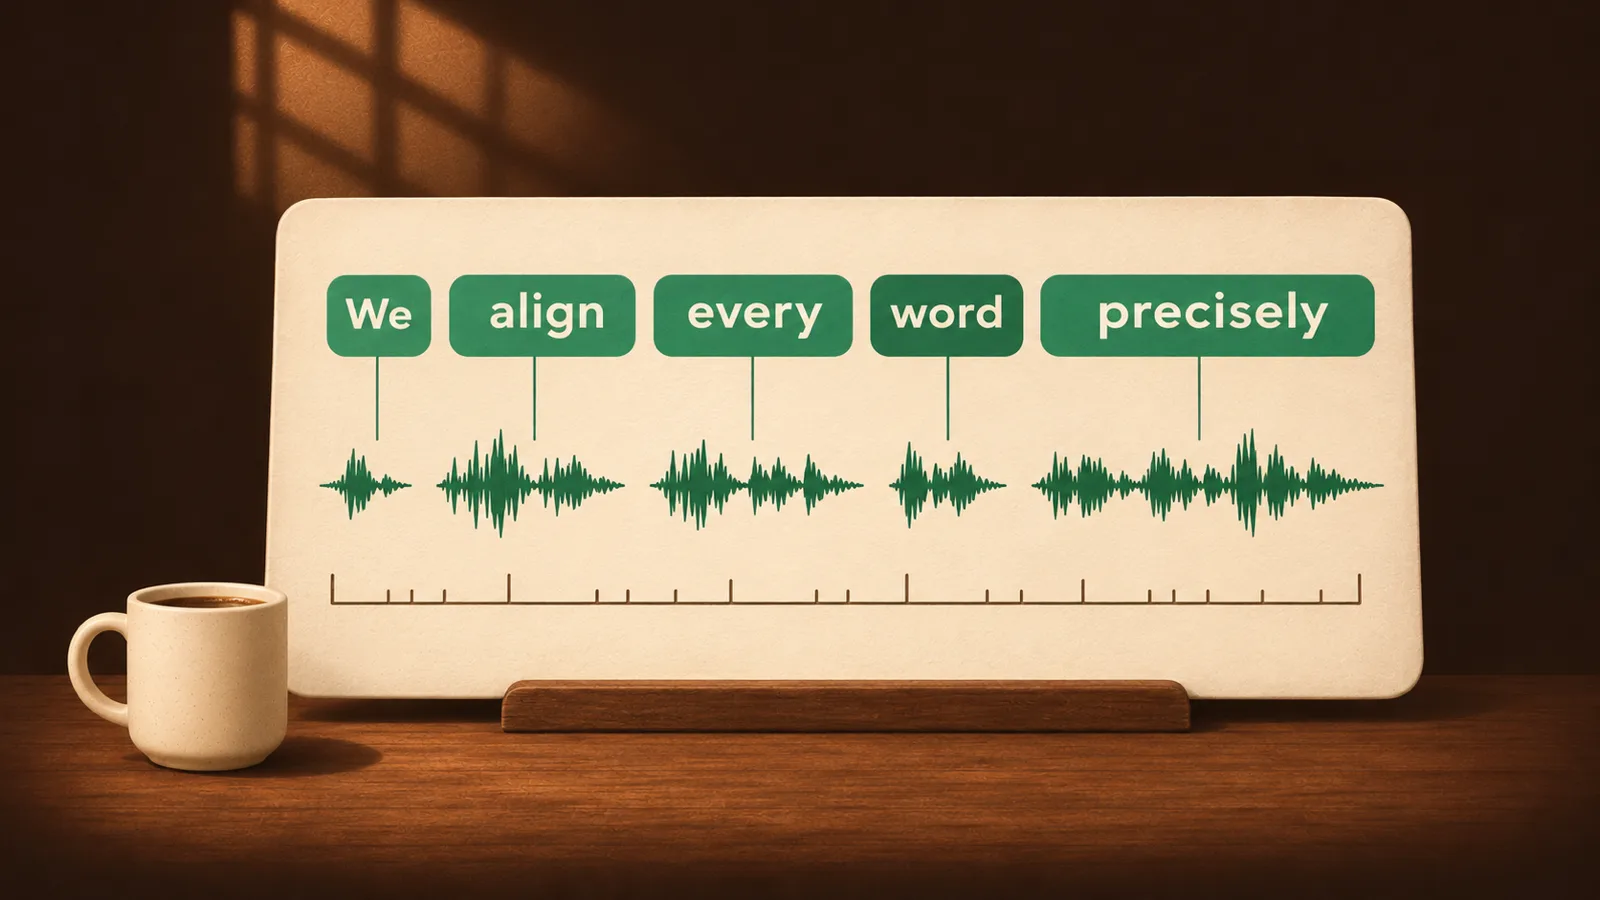
已经有台词稿、讲稿或歌词时,不用重新识别,直接把文本对到音频上,得到每个词、每句话的起止时间。对齐覆盖 346 种语言,中文、英文、日语、韩语、欧洲各主要语言以及许多小语种都能用。对齐的用途很多:给视频配上时间精准的字幕;把逐词时间做成卡拉 OK 字幕,每个词随声音高亮,适合歌词视频和语言学习;给有声书、播客和课程录音配上可以点句跳转的文稿;剪辑、配音时快速找到每句话在哪。对齐支持数小时长的音频和文本,整场会议、整本有声书也能直接对上。
对齐比重新识别快得多:20 秒左右的英文或中文录音,逐词对齐约 0.16 秒完成;26 分钟的发布会录音,374 句全部对上,用时 8.8 秒,起点误差的中位数是 40 毫秒。详见强制对齐。短句、60 分钟长音频和中文上的边界误差,以及与 MFA、ElevenLabs、Qwen3-ForcedAligner 的对比,见强制对齐与逐词时间戳评测。
用在视频剪辑里
转录和对齐给出的逐词时间,正好是视频剪辑需要的数据。口播、访谈、课程和播客视频可以按文字稿剪:在稿子里找到要删的口误、重复和长停顿,就知道该剪掉哪一段画面;挑出金句,按起止时间切成短视频。导出的 SRT 字幕可以直接导入 Premiere Pro、Final Cut Pro、DaVinci Resolve 等剪辑软件,不用逐句手动打轴。
说话人分离
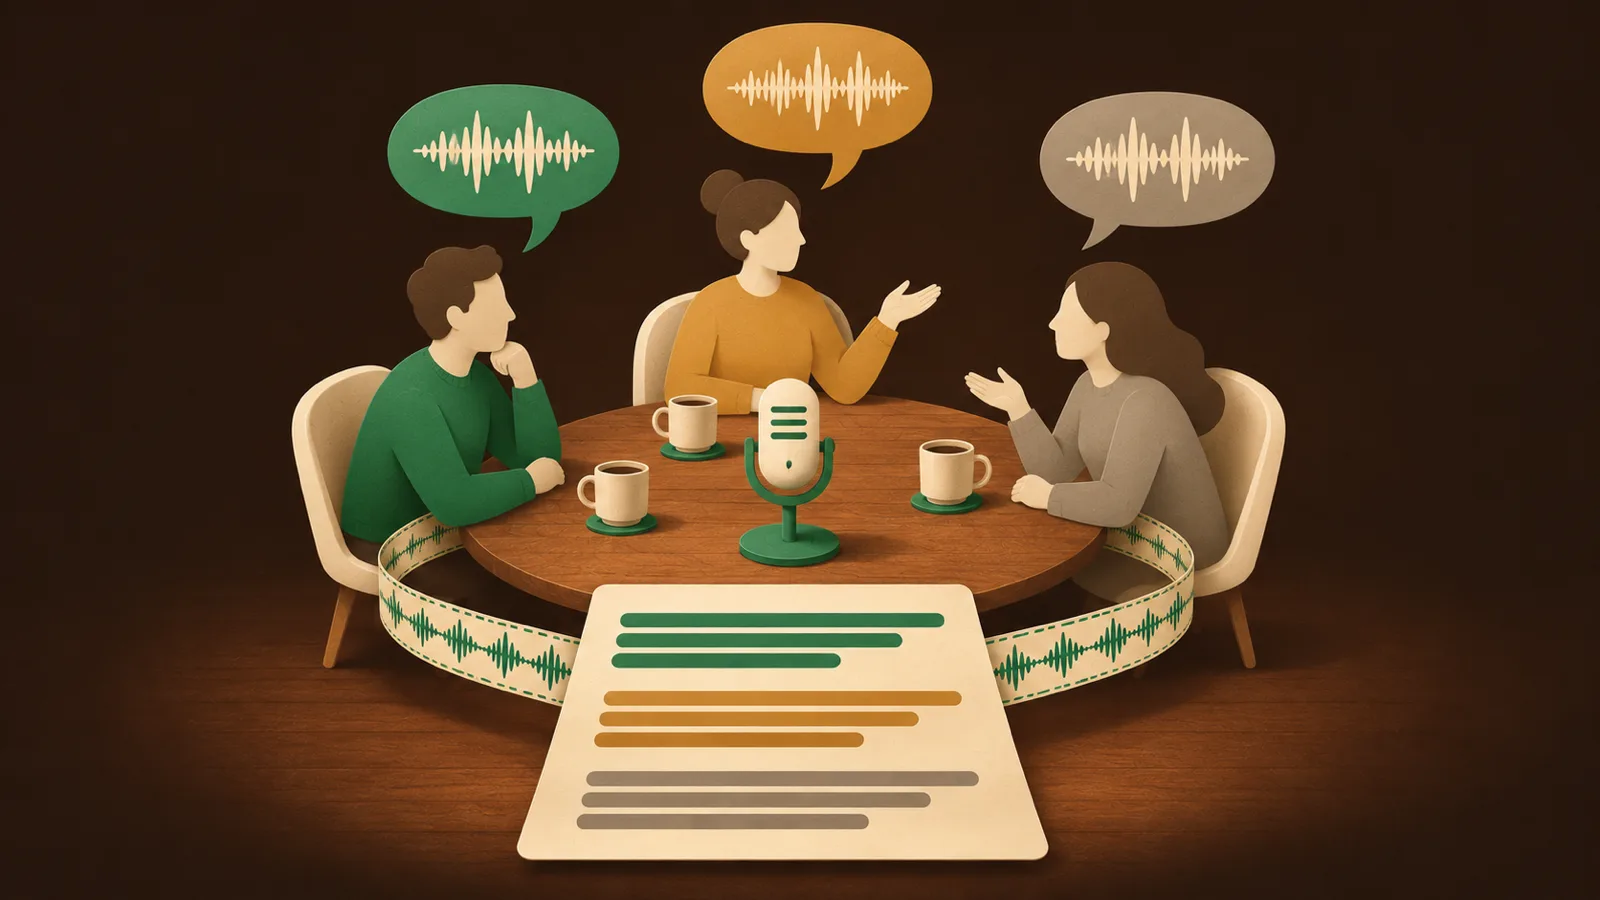
会议、访谈和播客里,转录稿会标出每句话是哪位说话人说的,方便整理成对话稿。说话人分离和转录在同一次请求里完成,几乎不增加等待:111.7 秒的录音,加上说话人标注只比单纯转录多约 0.2 秒。详见说话人分离。
翻译
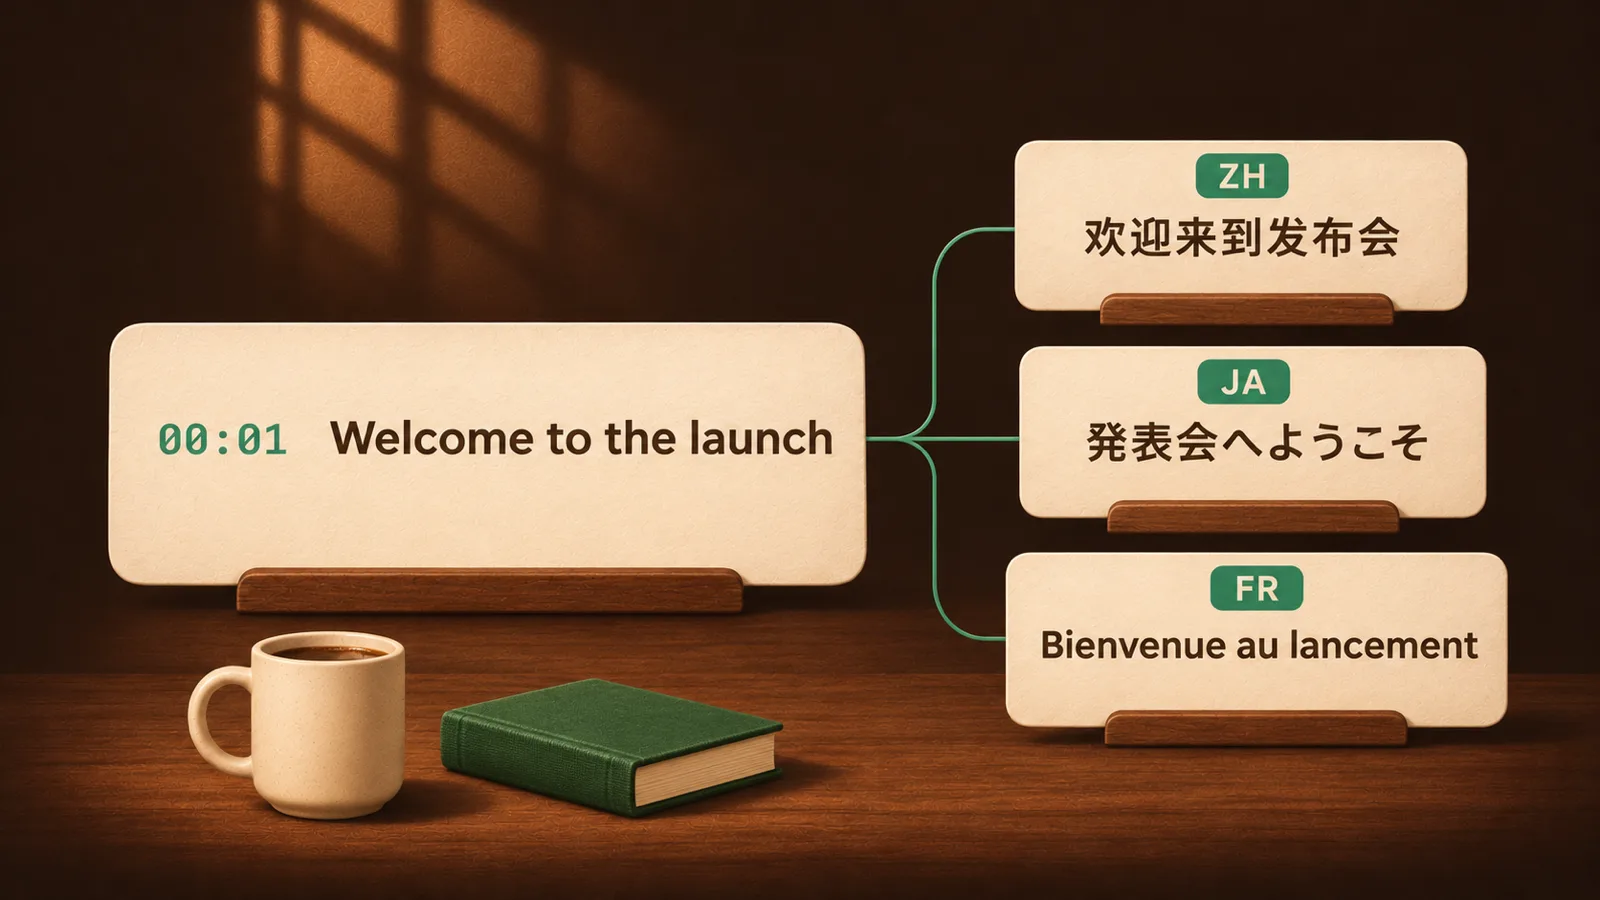
转录和对齐的结果可以直接在本机翻译,支持 38 种目标语言,包括繁体中文。翻译用的是专门训练的本机翻译模型 Lattice-2 Lite / Flash / Pro,下载后离线可用;它只做翻译,不改写、不总结。译文保留原文的时间轴,可以在原文、对照、译文三种视图间切换,导出时选择原文和译文的排布方式。常见用途:把外语视频、课程做成中文或双语字幕;会议和访谈稿翻给不同语言的同事;外语播客、发布会转录后翻成母语来读。翻译前可以用一两句话说明录音讲什么,选择自然、口语或忠实的翻译风格;词典里的人名、产品名按你设的写法译出。需要纠错、润色时,也可以换成你自己配置的商业模型服务。详见本地翻译转录稿和翻译要求怎么写。
本地网关同样提供翻译 API:在 Chat Completions 或 Responses 请求里加上 translation 参数,写明目标语言和翻译风格,就会调用本机翻译模型。MCP 工具和 Realtime 同声传译使用同一种写法。详见翻译 API 文档。
{
  "model": "EdgeSpeak/Lattice-2-Flash",
  "input": "欢迎来到今天的发布会。",
  "translation": { "target_language": "ja", "style": "natural" }
}
语音理解与对话
对着麦克风说话,AI 模型听懂后用语音回答。可以选语言陪练、角色扮演等人设,比如选语言陪练后说:「请扮演咖啡店店员,用英语和我练习点单。」切到同声传译,说一种语言,听到另一种语言。
开发者也可以用同样的能力做自己的语音应用:本地网关提供 Realtime API(WebSocket),支持实时语音对话和插话打断,也可以只做实时转录。对话里的语言模型可以从 0.6B 到 27B 按电脑配置选,在 Windows 的 RTX 3060 上用 Vulkan 运行,生成速度约每秒 173 个 token。详见语音对话和 Realtime API 文档。
播报与音乐生成
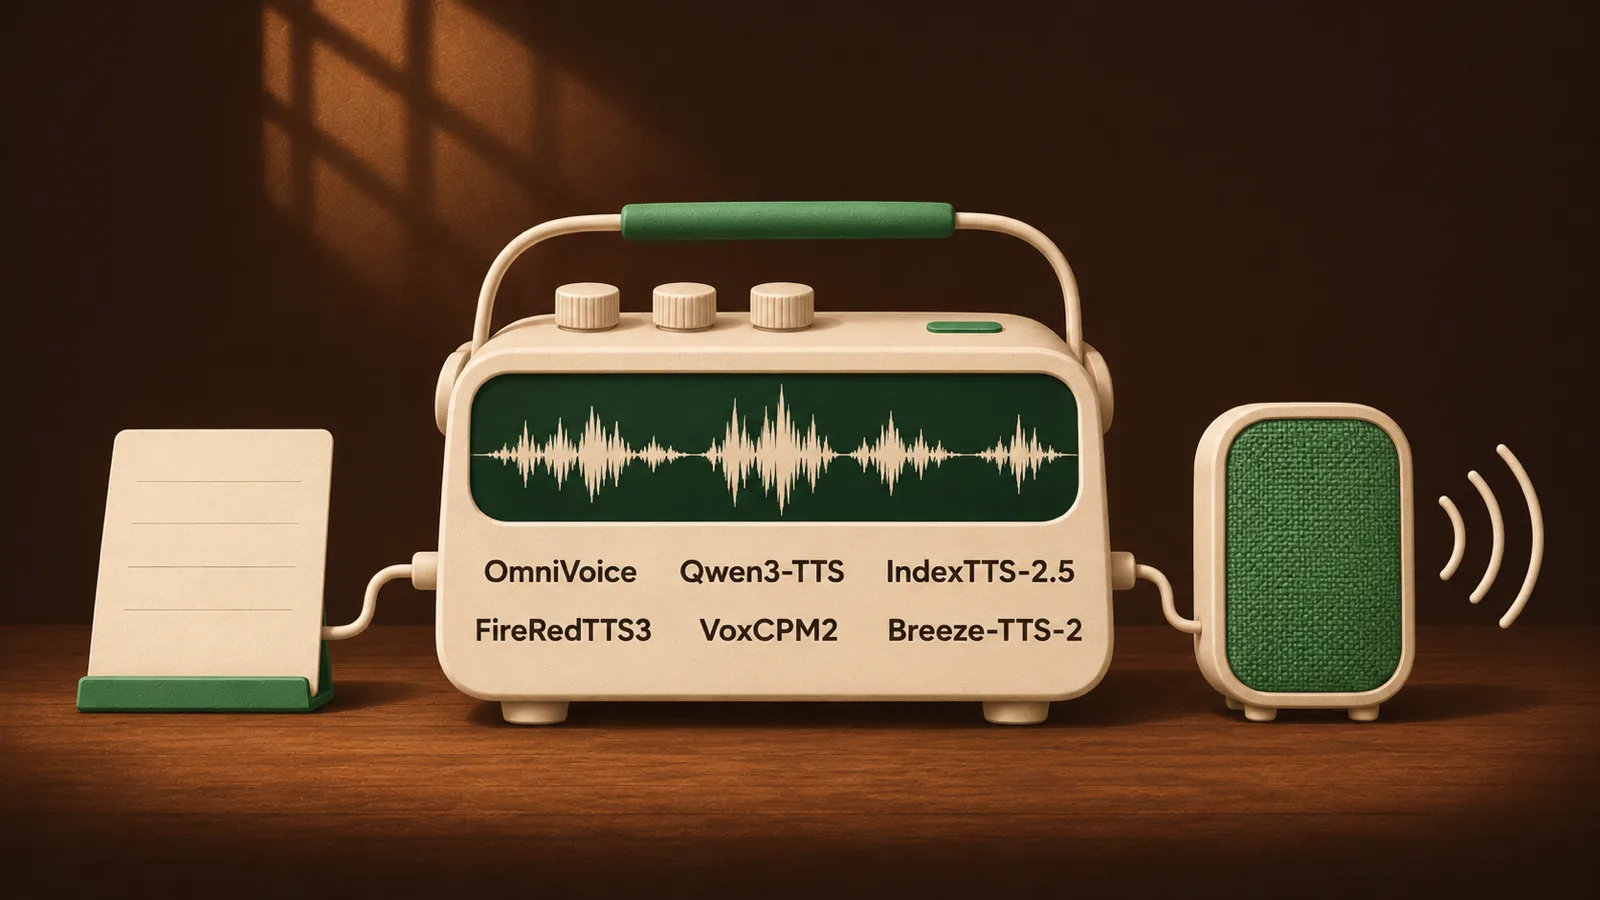
输入文字,生成语音,边生成边播放,也可以导出 WAV。播报接入了 11 款当前前沿的开源模型,来自 Qwen3-TTS、FireRedTTS3、OmniVoice、IndexTTS-2.5、VoxCPM2、Breeze-TTS-2 六个系列,各有所长,可以按语言、音色和速度挑选;新的优秀模型出现后,我们会持续接入。除了内置音色,选择支持相应能力的模型后,还可以用一段清晰的参考录音创建自己的音色,或者用文字描述想要的声音。
播报同样做了流式和加速优化:在 Apple M5 Ultra 上,Qwen3-TTS 0.6B 合成一段 31 个词的英文,约 60 到 90 毫秒就开始出声,约 2.1 秒生成完 11 秒左右的语音;在 NVIDIA 显卡上,FireRedTTS3 生成语音的耗时约为音频时长的 0.26 倍。详见播报。
用歌词生成歌曲
播报页还内置了音乐模型 YuE2。写好带 [Verse]、[Chorus] 等段落标签的歌词,再用一句话描述曲风、人声和配器,就能在本机生成一首带人声和伴奏的完整歌曲,输出 48 kHz 双声道音频。生成前可以先让模型规划一份乐谱,查看、修改后再生成,也可以粘贴自己的 ABC 乐谱。用 YuE2 生成歌曲免费,不消耗额度。
我们为 YuE2 换了新的采样方法 AB3:默认 14 步,只需 15 次模型计算,生成的音频和 32 步参考结果几乎一致(信噪比约 29 dB)。在 Apple Silicon 上,声音生成和解码这一段的耗时从约 1.5 倍歌曲时长缩短到约 0.67 倍,接近实时(不含开头的旋律规划和模型加载)。在 NVIDIA RTX 4090 上,一首 22.3 秒的歌约 9.1 秒生成完。YuE2 权重沿用原作者的 CC BY-NC 4.0 许可,仅限非商业用途。
下面这首歌由 YuE2 在本机生成。生成后,我们用 EdgeSpeak 的强制对齐把歌词对到歌声上,得到每个词的起止时间,再导出逐词高亮的卡拉 OK 字幕,烧进视频。画面里的频谱和波形随音乐实时变化,标题区写的是这次使用的模型参数。一首歌从生成、对齐到字幕,都在同一台电脑上完成。
本地网关:完备的语音文本能力
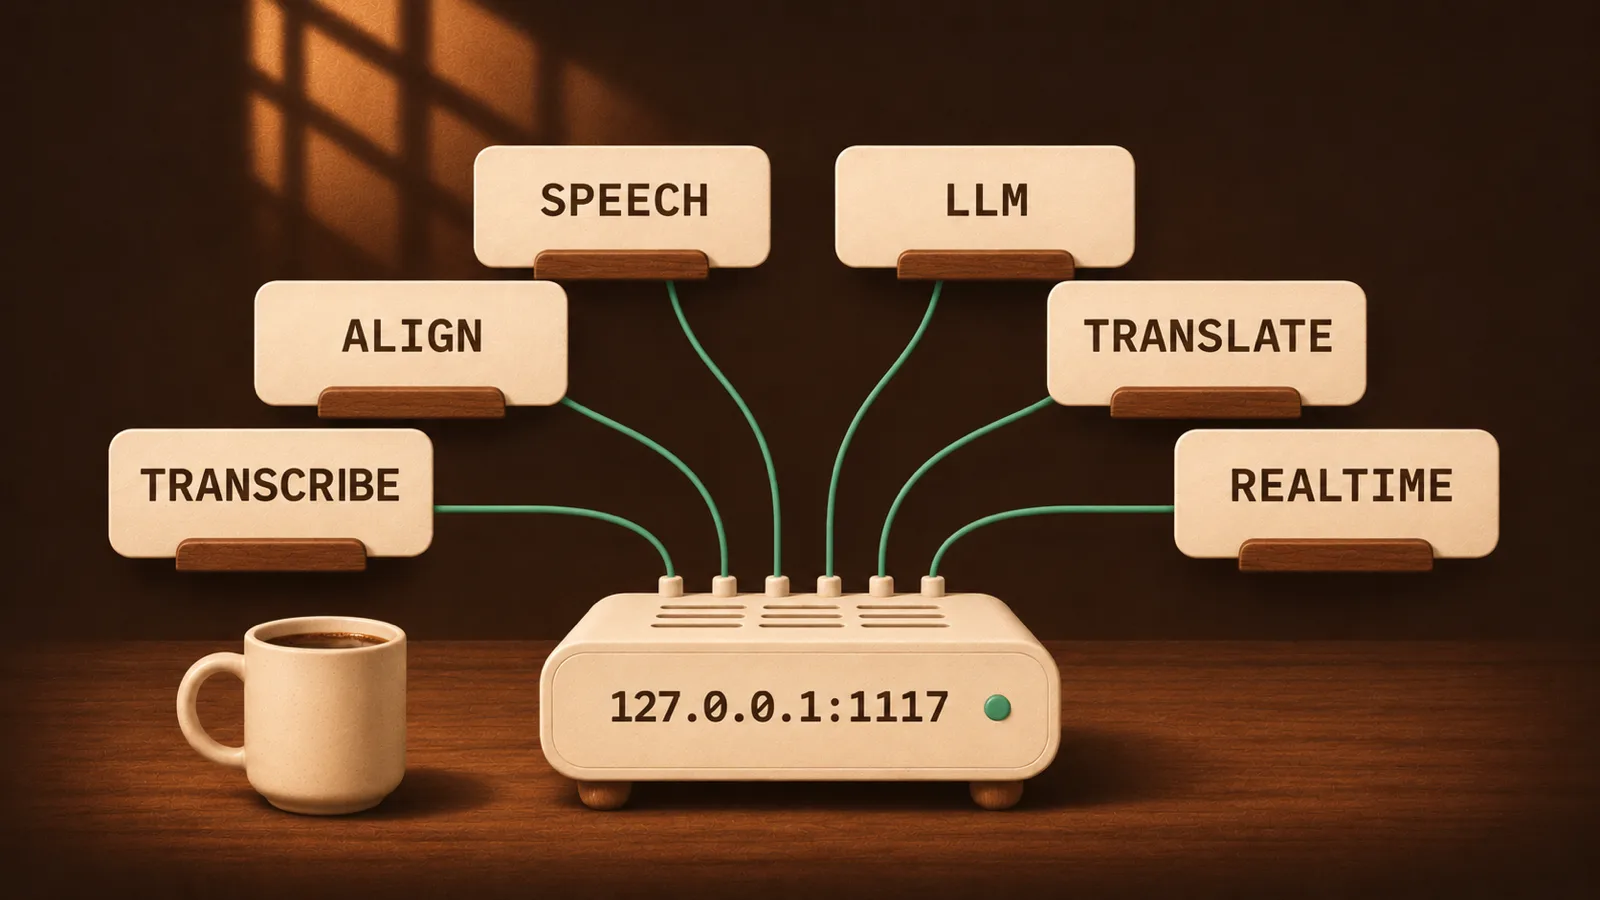
打开桌面 App,本地网关就在 http://127.0.0.1:1117/v1 运行;也可以用 edgespeak-cli serve 单独启动,不需要桌面 App。网关沿用 OpenAI 的接口写法,转录、对齐、播报、LLM、翻译、实时语音都在同一个地址:
| 能力 | 接口 |
|---|---|
| 转录、说话人分离 | /v1/audio/transcriptions、/v1/speaker/diarizations |
| 强制对齐 | /v1/audio/alignments |
| 播报、创建音色 | /v1/audio/speech、/v1/audio/voices |
| LLM 对话、翻译、看图 | /v1/responses、/v1/chat/completions、/v1/messages |
| 实时语音对话 | /v1/realtime(WebSocket) |
| Agent 工具 | /mcp |
这些能力平时往往要分别开通几家云服务、分别付费。有了本地网关,语音和 LLM 的基础能力都在本机,不必再为它们另外购买 API 服务;已有的 OpenAI SDK 代码,把基础地址换成本机地址就能调用。需要给局域网里其他可信机器用时,也可以启动 Headless 服务。网关能做什么、两种运行方式怎么选,见本地语音网关介绍;接口细节见 API 文档。
与 Agent 结合使用
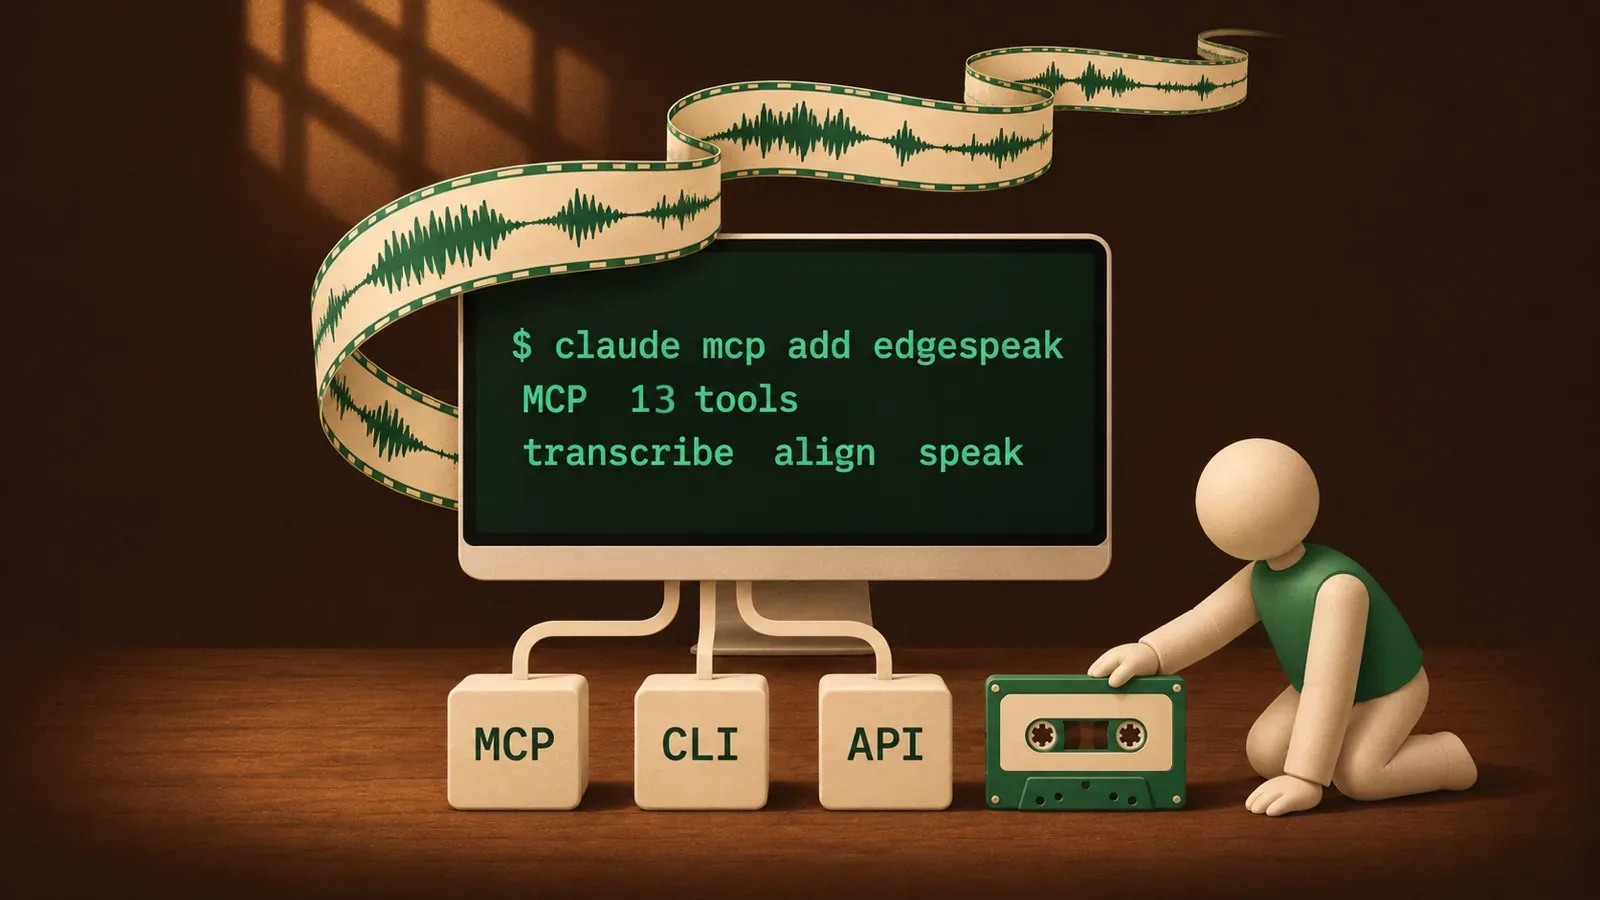
EdgeSpeak 提供 13 个 MCP 工具,覆盖转录、对齐、说话人分离、播报和本地语言模型。在 Claude Code 等支持 MCP 的 Agent 里注册一次,就能直接用自然语言让 Agent 处理录音:比如「把这个文件夹里的会议录音都转成文字,按说话人整理成纪要」,或者「给这段视频生成逐词字幕」。安装 EdgeSpeak Agent Skill 后,Agent 还能按完整流程完成转录、分句、对齐和字幕导出。
和 Claude Code 一起剪视频,是很顺手的组合:Claude Code 本身会调用 FFmpeg 处理视频,EdgeSpeak 补上「听懂视频」这一步,给它每个词的起止时间。你可以直接说「把这段访谈里的口误和超过两秒的停顿剪掉」「把讲到定价的几段切出来做成短视频,配上逐词字幕」,Agent 先用 EdgeSpeak 转录、对齐,再按时间戳剪辑、烧字幕,整个过程都在本机完成。
claude mcp add edgespeak -- edgespeak-cli mcp详见 MCP 文档。
隐私
语音识别、对齐、说话人分离和播报都由本机模型完成,音视频、转录稿和词典只保存在你的设备上,不会上传到任何服务器。适合处理客户录音、内部会议、访谈等敏感内容。联网只用于登录、激活 license 和下载模型;语音对话中如果选用云端模型,该部分会由对应服务处理。详见隐私说明。
开始使用
从下载页安装桌面版,登录后在应用里下载需要的模型。免费方案可以直接试用;也可以一次性买断 license,永久使用,包含后续模型和语音能力更新,最多可激活 4 台设备。各方案额度和价格见定价页。