EdgeSpeak:オンデバイス音声 AI をオールインワンで——文字起こし、読み上げ、アライメント、翻訳、音楽、LLM
文字起こし、読み上げ、アライメント、音楽生成、翻訳に、話者分離とリアルタイム音声対話まで。EdgeSpeak は音声 AI の一連の機能を手元のデバイスで実行します。4 人が交代で話す 26 分の発表会の録音は、Apple M5 で 33 秒で文字起こしが完了し、ピークメモリ使用量は約 1.0 GB でした。
文字起こしに加え、346 言語の強制アライメント、38 言語へのオンデバイス翻訳、11 種類の読み上げモデルに対応。YuE2 では、歌詞から歌声と伴奏のある楽曲を生成できます。13 個の MCP ツールを通じて、Claude Code などのエージェントから直接呼び出せます。macOS(Apple Silicon)と Windows にはデスクトップアプリと CLI、Linux には CLI を提供。音声、動画、文字起こしデータはパソコン内に保存されます。
高い精度、速い処理、少ないメモリ使用量
一般的なパソコンでもローカルモデルを速く、精度よく動かせるよう、さまざまな最適化を施しています。モデルをデバイスに適したサイズに圧縮・量子化し、推論エンジンは Apple Silicon の Metal、NVIDIA GPU の CUDA、クロスプラットフォームの Vulkan にそれぞれ最適化。単体 GPU のないパソコンでは CPU で動作します。
冒頭の 26 分の発表会の録音を、Apple M5 で測定した結果です。
| 項目 | 結果 |
|---|---|
| 精度 | 単語誤り率(WER)6.6% |
| 文字起こし速度 | 33 秒、実時間の約 48× |
| アライメント速度 | 既存の原稿と音声のアライメントが 8.8 秒で完了 |
| メモリ | 文字起こしプロセスのピーク使用量は約 1.0 GB |
NVIDIA RTX 3060 を搭載した Windows では、文字起こしのリアルタイム係数は約 0.04、実時間の約 25× の速度です。スペックが低めのパソコンでは、軽量な Lattice-2 Lite を選べます。処理時間はパソコンによって異なります。
モデルのラインアップ
| 機能 | モデル |
|---|---|
| 文字起こし | Lattice-2 Lite / Flash / Pro。ハードウェアと精度の要件に合わせて選べる 3 段階 |
| 強制アライメント | Lattice-2。346 言語に対応 |
| オンデバイス翻訳 | Lattice-2 Lite / Flash / Pro 翻訳モデル。38 の翻訳先言語に対応し、翻訳 API も提供 |
| 音声対話 | 0.6B から 27B までの Qwen と Gemma モデルを内蔵。互換性のある GGUF モデルもインポート可能 |
| 読み上げ(TTS) | 11 種類:Qwen3-TTS(0.6B / 1.7B の Base と CustomVoice、1.7B VoiceDesign)、FireRedTTS3(Instruct、Base)、OmniVoice、IndexTTS-2.5、VoxCPM2、Breeze-TTS-2。ストリーミング再生、ボイスクローニング、説明文からの音声デザインに対応 |
| 音楽生成 | YuE2。歌詞から歌声と伴奏のある楽曲を生成。無料で利用可能 |
モデルはアプリ内で必要に応じてダウンロードでき、ダウンロード後はオフラインで利用できます。
対応言語
EdgeSpeak のモデルは、中国語と英語だけでなく、設計段階から多言語に対応しています。
| 機能 | 対応言語 |
|---|---|
| 文字起こし | 中国語、広東語、英語、日本語、韓国語、アラビア語、ヒンディー語、タイ語、ベトナム語、ヨーロッパの主要言語など 40 以上の言語 |
| 強制アライメント | 346 言語。複数の言語が混在したテキストにも対応 |
| 翻訳 | 繁体字中国語やウイグル語を含む 38 の翻訳先言語 |
| 読み上げ(TTS) | OmniVoice は言語カタログの全言語に対応し、それ以外の ISO 639 言語も指定可能。FireRedTTS3 は 24 言語と四川語など 21 の中国語方言、Qwen3-TTS は 10 言語に対応 |
言語ごとの対応機能は、言語ガイドをご覧ください。
文字起こし
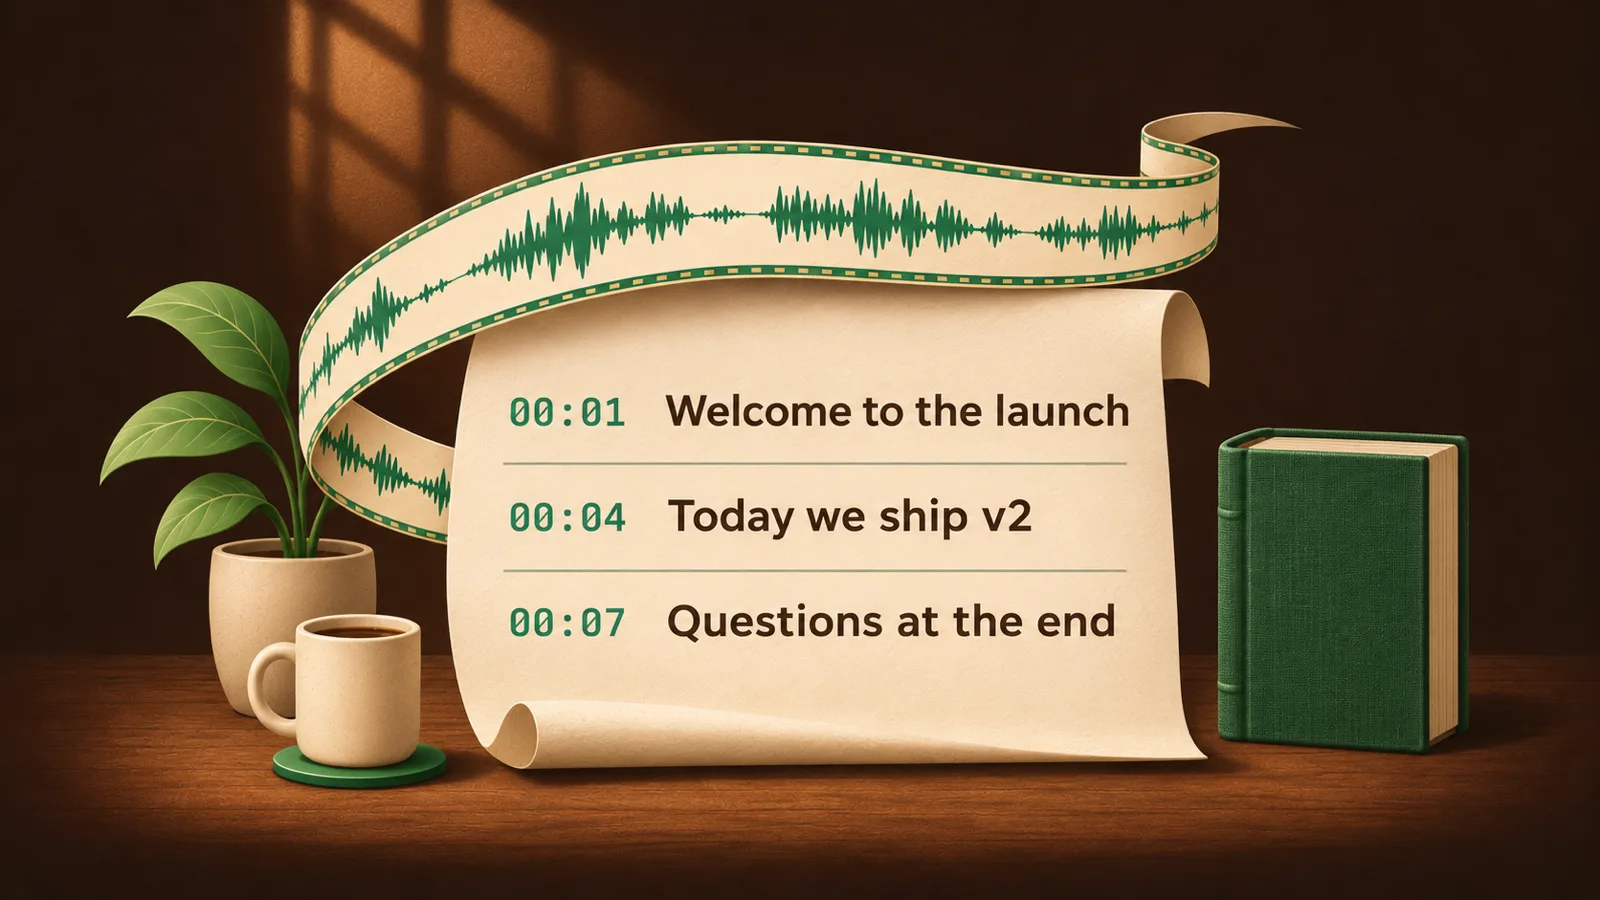
音声や動画を取り込むと、タイムスタンプ付きのテキストに変換できます。40 以上の言語に対応しており、全言語の一覧は言語ガイドで確認できます。プレーンテキスト、SRT、VTT 字幕、JSON での書き出しに対応。人名、製品名、専門用語を辞書に登録すれば、正しく認識し、指定した表記で翻訳できます。Lattice-2 には Lite、Flash、Pro の 3 段階があります。Lite はメモリ使用量が少なく、薄型ノートパソコン向け。標準の Flash は速度と精度のバランスを取り、Pro は 3 モデルの中で精度を重視しています。Flash では 111.7 秒の英語録音を約 2.6 秒で文字起こしできます。詳しくは音声からテキストへをご覧ください。
アライメント(強制アライメント)
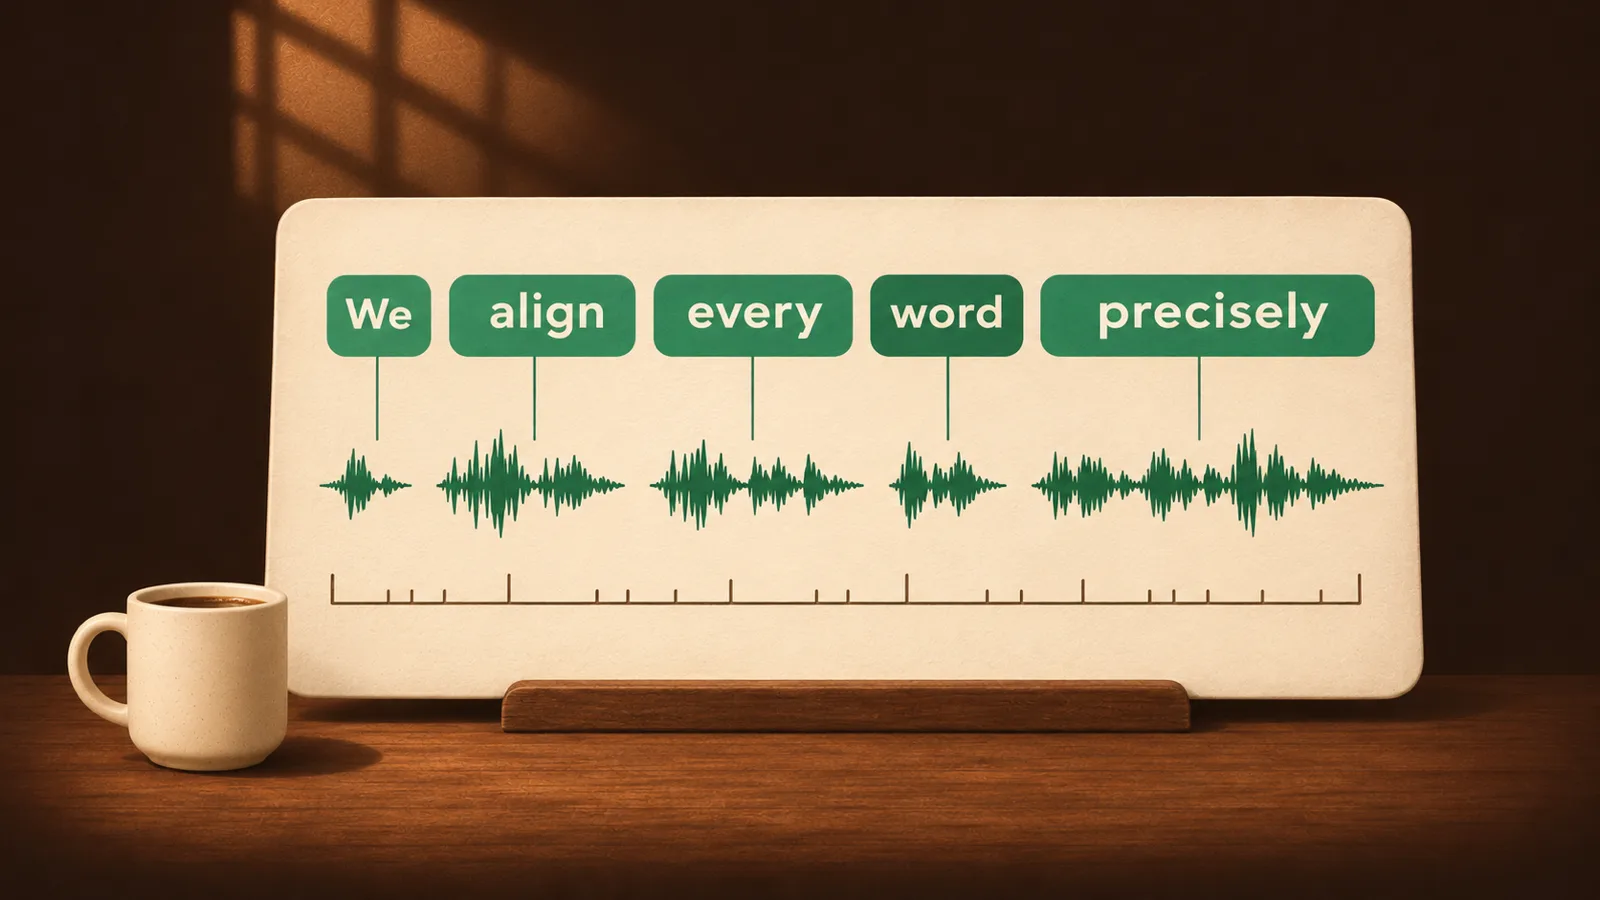
台本、講演原稿、歌詞がすでにある場合は、改めて文字起こしをする必要はありません。テキストを音声に直接合わせ、単語や文ごとの開始・終了時刻を取得できます。中国語、英語、日本語、韓国語、ヨーロッパの主要言語や多くの少数言語を含む 346 言語に対応。動画に正確なタイミングで字幕を付けるほか、歌や発話に合わせて単語をハイライトするカラオケ字幕を歌詞動画や語学学習に使えます。オーディオブック、ポッドキャスト、講座のテキストからクリックで該当箇所へ移動したり、編集や吹き替えで各セリフの位置を素早く見つけたりすることも可能です。数時間に及ぶ音声とテキストにも対応しているため、会議全体やオーディオブック 1 冊分をまとめて処理できます。
アライメントは、文字起こしをやり直すよりも大幅に高速です。20 秒の英語または中国語の録音なら、単語単位のアライメントは約 0.16 秒。26 分の発表会の録音では、全 374 文のアライメントが 8.8 秒で完了し、開始時刻の誤差の中央値は 40 ミリ秒でした。詳しくは強制アライメントをご覧ください。短文、60 分の長時間音声、中国語での単語境界の誤差と、MFA、ElevenLabs、Qwen3-ForcedAligner との比較は強制アライメントと単語タイムスタンプの評価にまとめています。
動画編集に活用
文字起こしとアライメントで得られる単語単位のタイムスタンプは、動画編集にも役立ちます。トーク動画、インタビュー、講座、ポッドキャストを、テキストに沿って編集できます。原稿から言い間違い、繰り返し、長い間を見つければ、削除する映像区間が分かります。印象的な発言を選び、開始・終了時刻を使って短いクリップに切り出すこともできます。書き出した SRT 字幕は Premiere Pro、Final Cut Pro、DaVinci Resolve などに直接読み込めるので、字幕のタイミングを 1 行ずつ設定する必要はありません。
話者分離
会議、インタビュー、ポッドキャストでは、各発言の話者をテキストに表示し、対話形式の原稿に整理できます。話者分離は文字起こしと同じリクエストで実行され、待ち時間はほとんど増えません。111.7 秒の録音では、話者ラベルを付けても、文字起こしのみの場合より約 0.2 秒増えるだけです。詳しくは話者分離をご覧ください。
翻訳
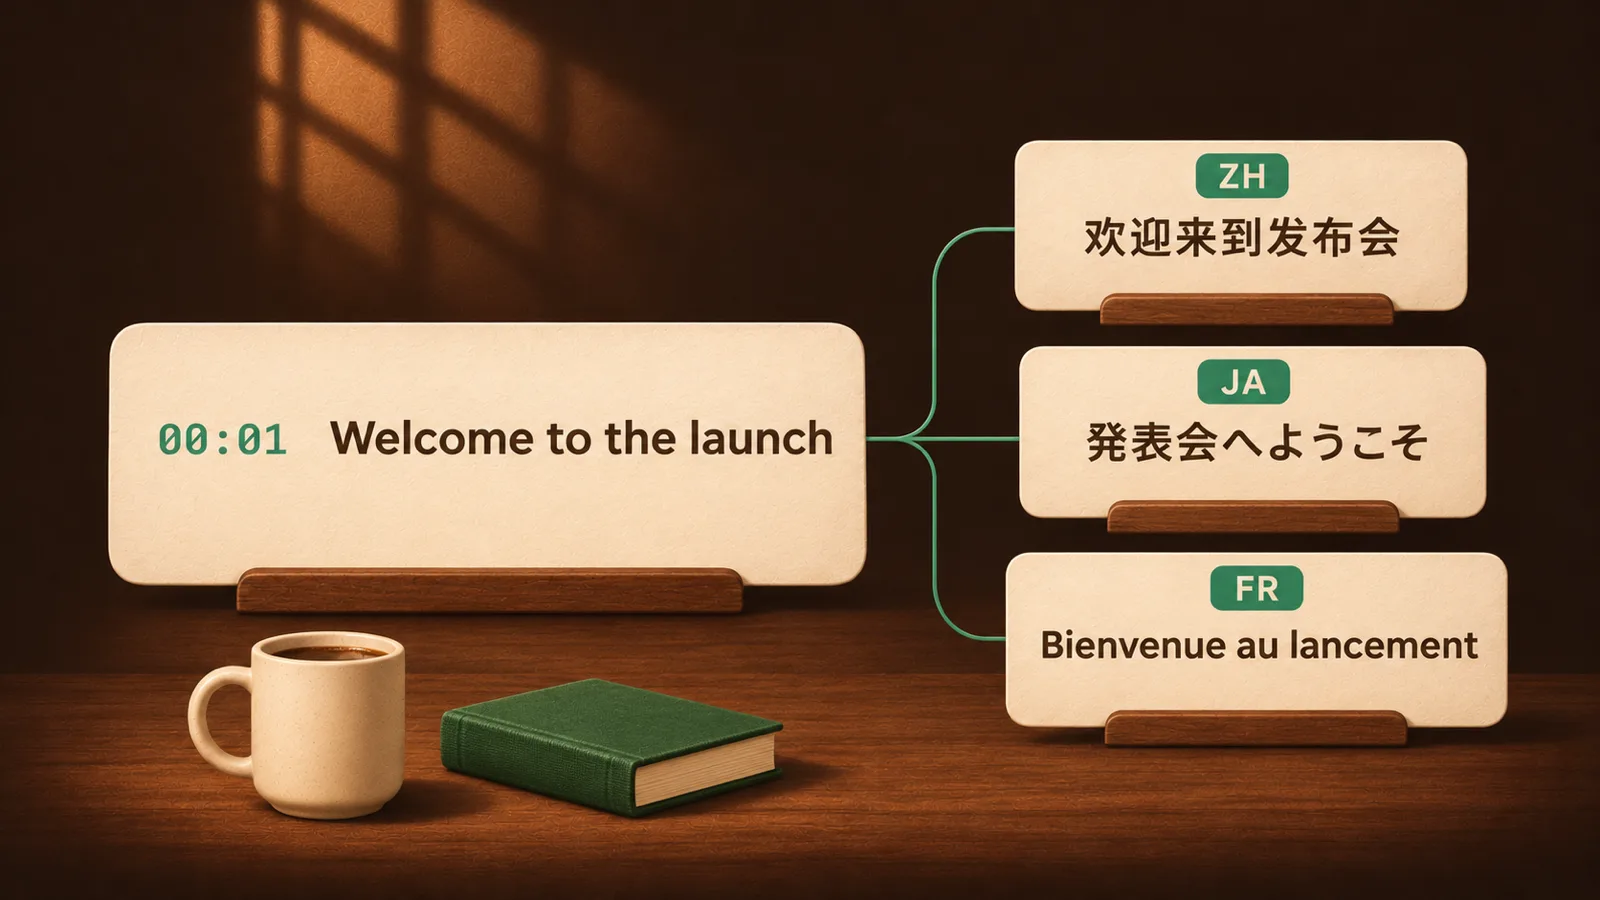
文字起こしやアライメントの結果を、パソコン上で繁体字中国語を含む 38 の言語に翻訳できます。専用のオンデバイス翻訳モデル Lattice-2 Lite / Flash / Pro を使用し、ダウンロード後はオフラインで動作します。翻訳に特化しており、書き換えや要約は行いません。訳文には元のタイムラインが維持され、原文、対訳、訳文の表示を切り替えられます。書き出す際には、原文と訳文の配置も選べます。外国語の動画や講座に中国語、英語、2 言語併記の字幕を付ける、会議やインタビューの原稿を別の言語を話す同僚向けに翻訳する、外国語のポッドキャストや発表会を母語で読む、といった用途に使えます。翻訳前に録音の内容を 1〜2 文で説明し、自然な文体、会話調、原文に忠実な文体から選択できます。辞書に登録した人名や製品名は、指定した表記で翻訳されます。修正や推敲が必要な場合は、自分で設定した商用モデルサービスに切り替えることもできます。詳しくは文字起こしをローカルで翻訳と翻訳要件の書き方をご覧ください。
ローカルゲートウェイは翻訳 API も提供します。Chat Completions または Responses のリクエストに translation パラメータを追加し、翻訳先の言語と文体を指定すると、オンデバイス翻訳モデルで処理されます。MCP ツールや Realtime の同時通訳でも同じ形式を使います。詳しくは翻訳 API ドキュメントをご覧ください。
{
  "model": "EdgeSpeak/Lattice-2-Flash",
  "input": "本日の発表会へようこそ。",
  "translation": { "target_language": "ja", "style": "natural" }
}
音声の理解と対話
マイクに向かって話すと、AI モデルが内容を理解し、音声で返答します。語学練習の相手やロールプレイなどの役割を選べます。たとえば語学練習なら、「カフェの店員になって、スペイン語で注文する練習を手伝って」と話しかけます。同時通訳に切り替えると、話した内容を別の言語で聞けます。
開発者は、同じ機能を使って独自の音声アプリを作れます。ローカルゲートウェイの Realtime API(WebSocket)は、リアルタイム音声対話と発話への割り込みに対応し、リアルタイム文字起こしだけを使うことも可能です。対話に使う言語モデルは、パソコンの性能に合わせて 0.6B から 27B まで選べます。RTX 3060 を搭載した Windows で Vulkan を使うと、生成速度は毎秒約 173 token です。詳しくは音声対話と Realtime API ドキュメントをご覧ください。
読み上げ(TTS)と音楽生成
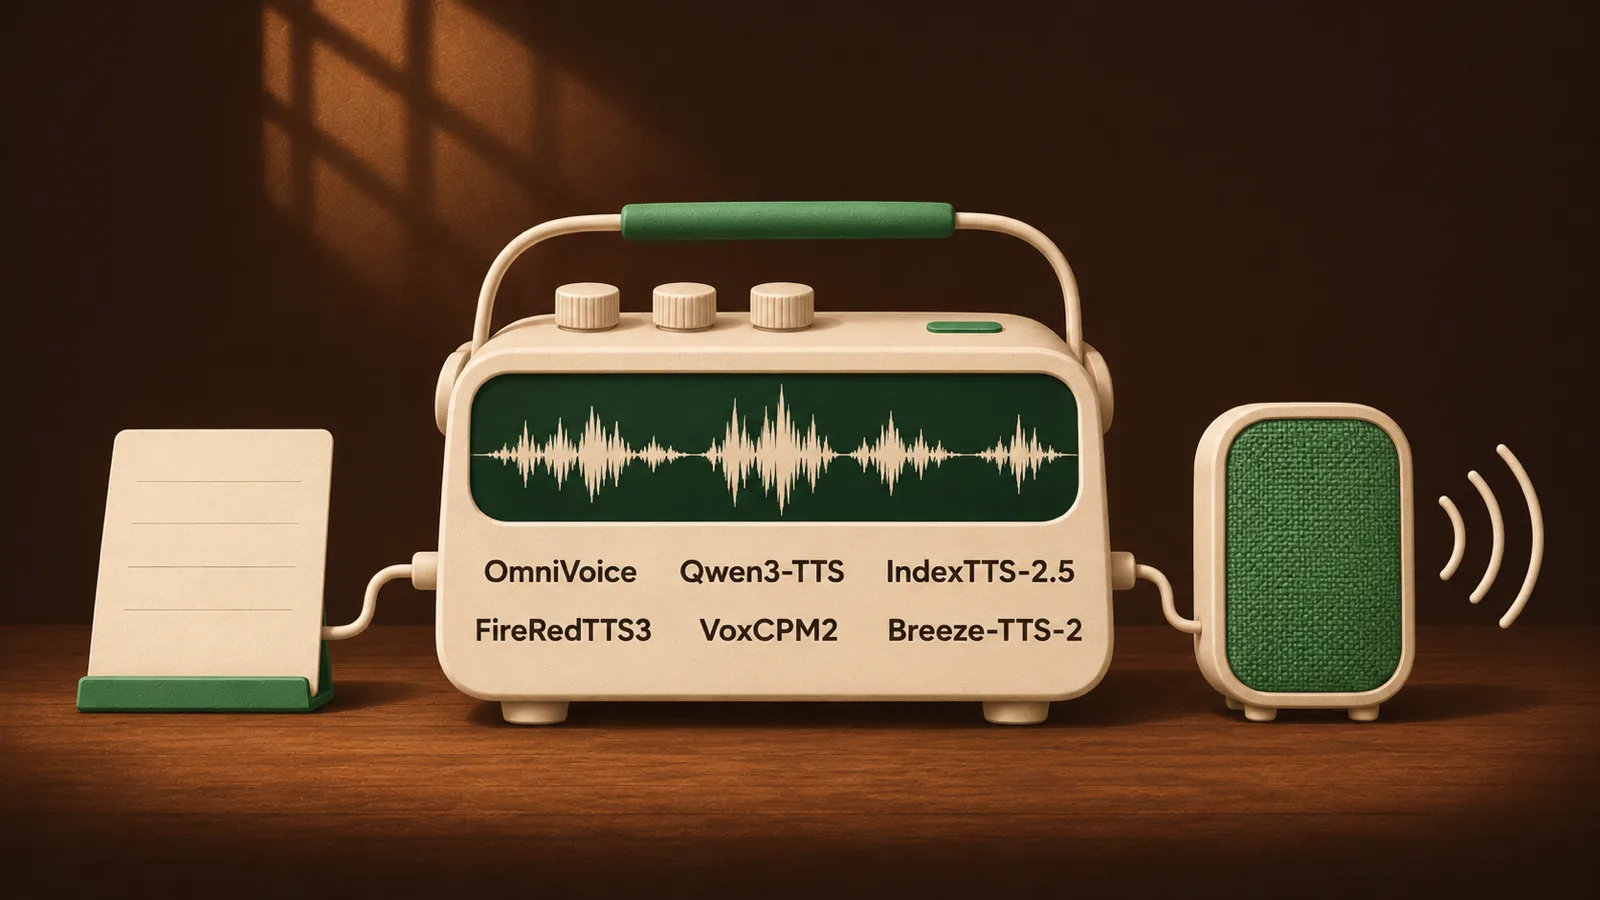
テキストを入力すると、音声を生成しながら再生でき、WAV にも書き出せます。EdgeSpeak は Qwen3-TTS、FireRedTTS3、OmniVoice、IndexTTS-2.5、VoxCPM2、Breeze-TTS-2 の 6 系列、計 11 種類の現行オープンソース読み上げモデルに対応しています。それぞれに特徴があり、言語、声質、速度で選べます。有力な新モデルも随時追加しています。内蔵の音声に加え、対応モデルでは、明瞭な参照録音から自分の声を作ったり、テキストで声の特徴を指定して音声をデザインしたりできます。
音声生成にもストリーミングと高速化を取り入れています。Apple M5 Ultra では、Qwen3-TTS 0.6B が 31 単語の英文を約 60〜90 ミリ秒で再生し始め、約 11 秒の音声を約 2.1 秒で生成します。NVIDIA GPU では、FireRedTTS3 の生成時間は音声の長さの約 0.26× です。詳しくは読み上げをご覧ください。
歌詞から楽曲を生成
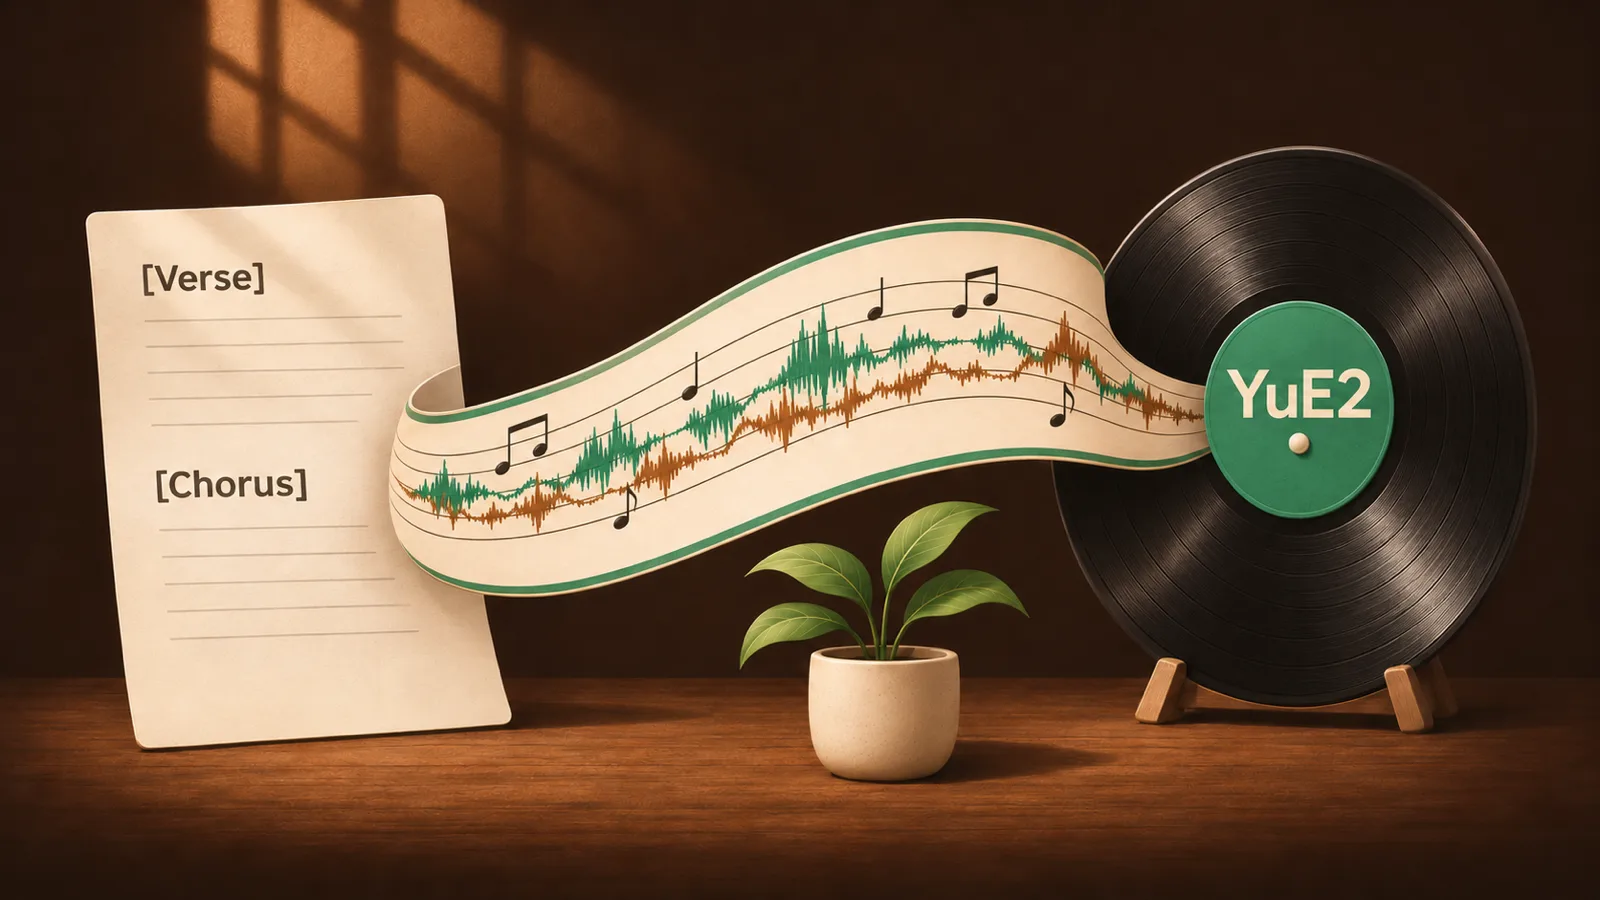
読み上げページには、音楽モデル YuE2 も搭載しています。[Verse] や [Chorus] などのセクションタグを付けて歌詞を書き、ジャンル、歌声、楽器編成を 1 文で指定すると、歌声と伴奏のある楽曲をパソコン上で生成できます。出力は 48 kHz のステレオ音声です。先にモデルに楽譜を組み立てさせ、確認・編集してから生成することも、自分で用意した ABC 記譜を貼り付けることもできます。YuE2 による楽曲生成は無料で、利用枠を消費しません。
YuE2 には、新たなサンプリング手法 AB3 を導入しました。標準は 14 ステップで、モデルの評価は 15 回。32 ステップの参照結果に近い音声を生成します(SNR は約 29 dB)。Apple Silicon では、音声の生成とデコードにかかる時間が楽曲の長さの約 1.5× から約 0.67× に短縮され、実時間に近づきました(最初のメロディー構成とモデルの読み込みを除く)。NVIDIA RTX 4090 では、22.3 秒の楽曲を約 9.1 秒で生成します。YuE2 の重みには原著者の CC BY-NC 4.0 ライセンスが適用され、非商用用途に限り利用できます。
以下の楽曲は、ローカルのパソコンで YuE2 を使って生成しました。その後、EdgeSpeak の強制アライメントで歌詞を歌声に合わせ、単語ごとの開始・終了時刻を取得。単語単位のカラオケ字幕を書き出し、動画に焼き込みました。スペクトルと波形は音楽に合わせて動き、タイトル部分には今回使ったモデル設定を表示しています。生成、アライメント、字幕作成まで、同じパソコンで行いました。
ローカルゲートウェイ:音声とテキストの機能をまとめて提供
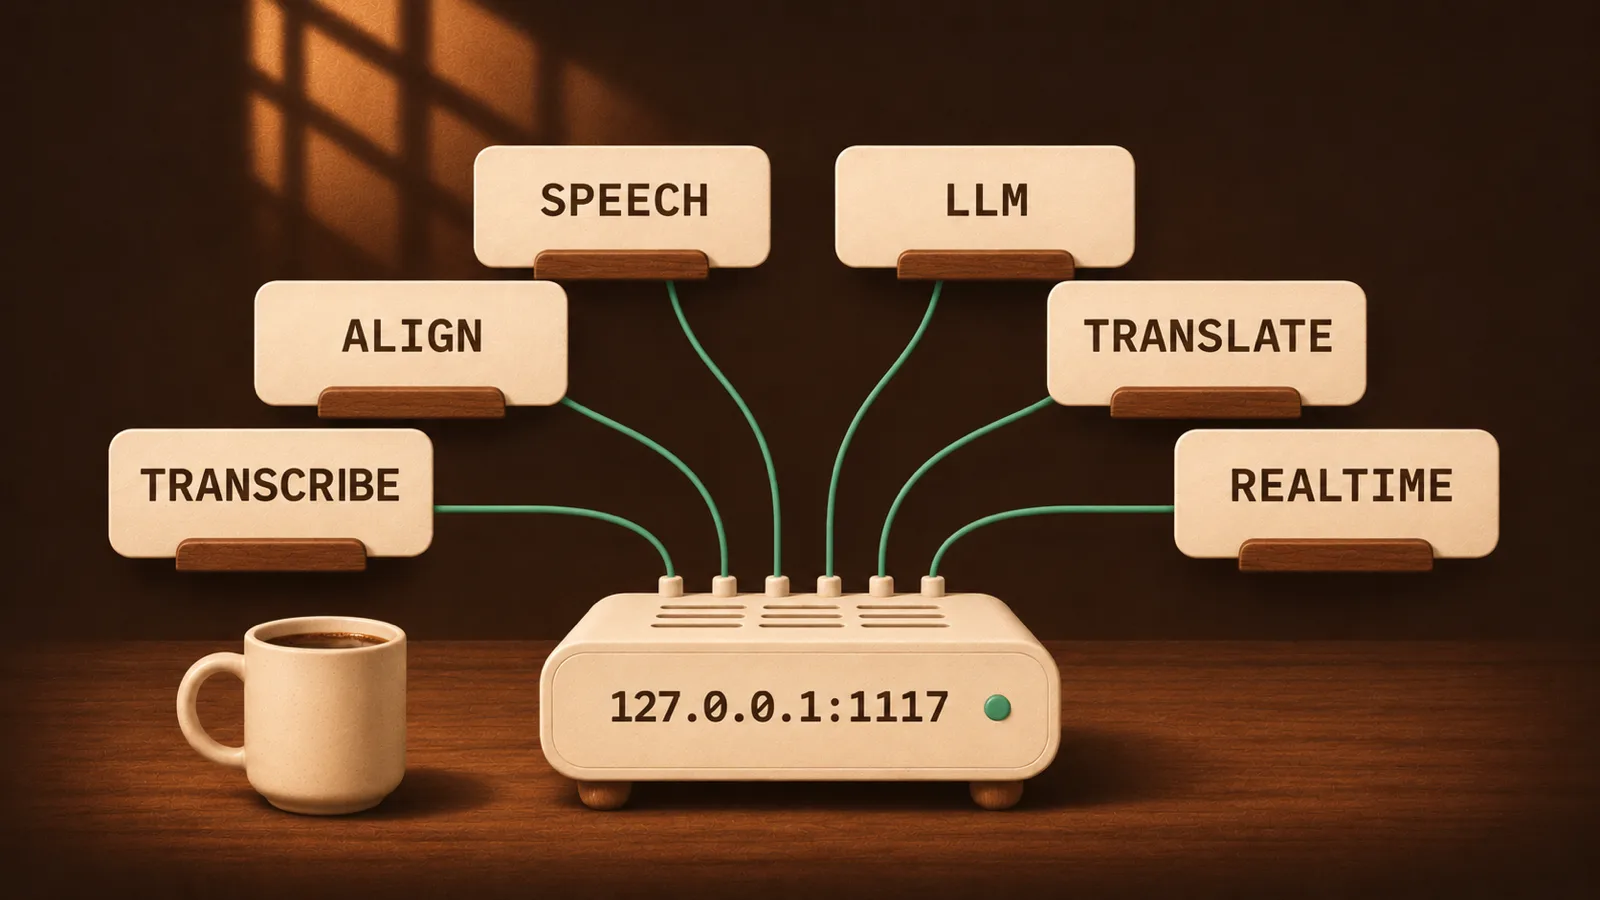
デスクトップアプリを開くと、ローカルゲートウェイが http://127.0.0.1:1117/v1 で動作します。edgespeak-cli serve で単独起動することもでき、その場合はデスクトップアプリが不要です。ゲートウェイは OpenAI API の形式に沿っており、文字起こし、アライメント、読み上げ、LLM、翻訳、リアルタイム音声を同じアドレスから利用できます。
| 機能 | エンドポイント |
|---|---|
| 文字起こし、話者分離 | /v1/audio/transcriptions, /v1/speaker/diarizations |
| 強制アライメント | /v1/audio/alignments |
| 読み上げ、音声の作成 | /v1/audio/speech, /v1/audio/voices |
| LLM 対話、翻訳、画像理解 | /v1/responses, /v1/chat/completions, /v1/messages |
| リアルタイム音声対話 | /v1/realtime(WebSocket) |
| エージェント用ツール | /mcp |
これらの機能を使うには、通常は複数のクラウドサービスに登録し、それぞれに料金を支払う必要があります。ローカルゲートウェイなら、基本的な音声・LLM 機能をパソコン上で実行できるため、個別の API サービスを購入する必要はありません。既存の OpenAI SDK のコードも、ベース URL を自分のパソコンに向けるだけで利用できます。ネットワーク内のほかの信頼できるマシンから使う場合は、ヘッドレスサービスを起動します。ゲートウェイの全体像と 2 つの起動方法はローカル音声ゲートウェイの解説、各エンドポイントの詳細は API ドキュメントをご覧ください。
AI エージェントと連携
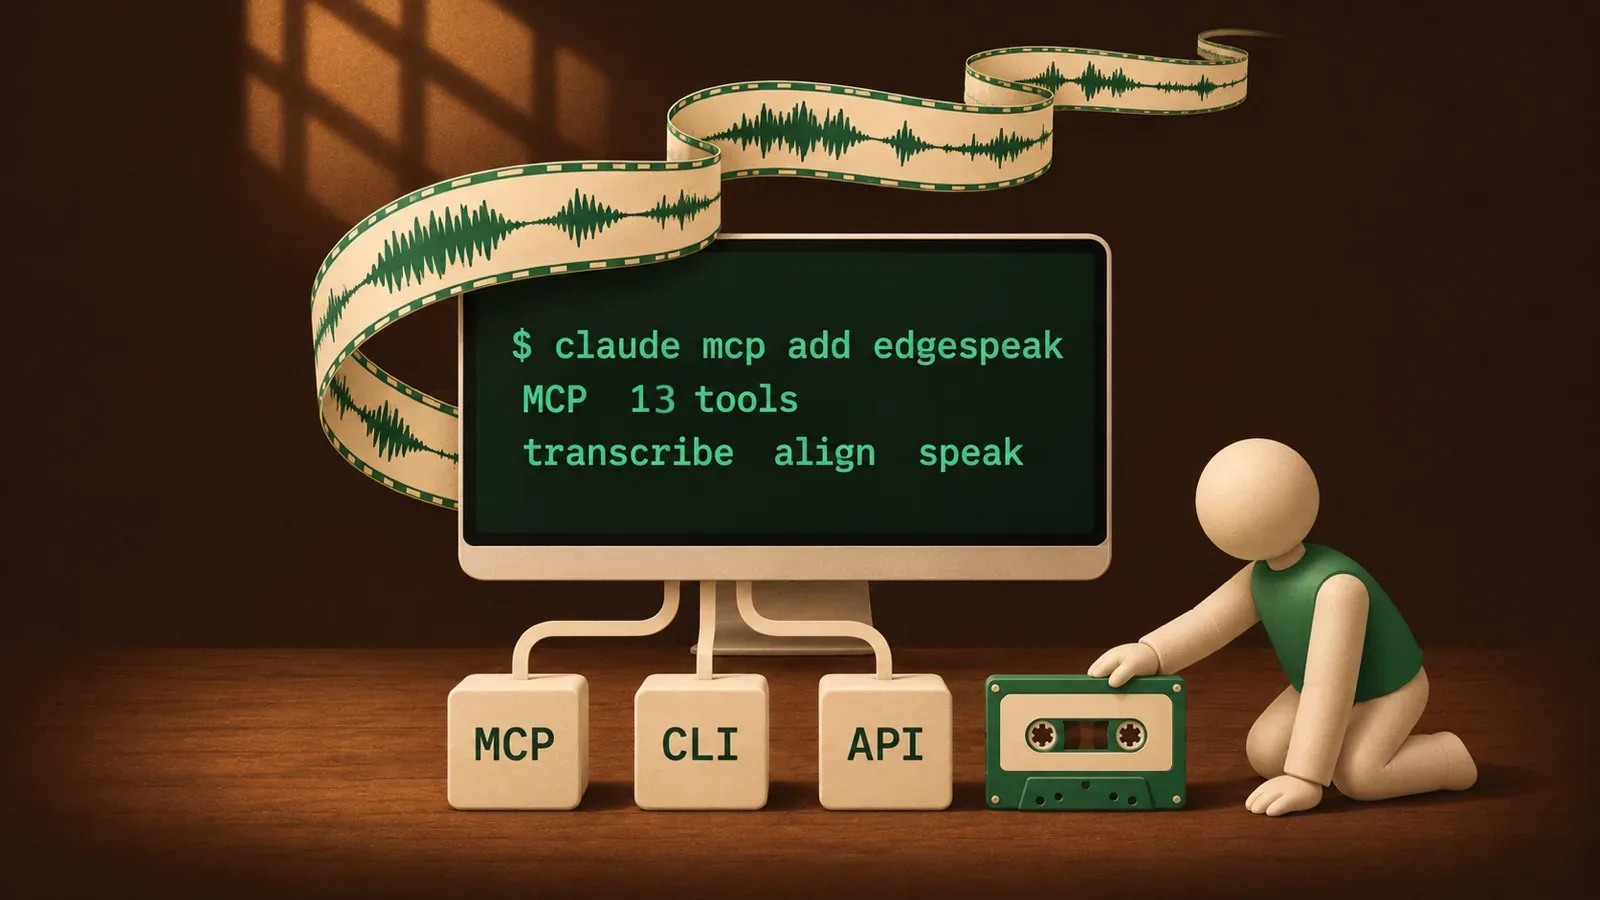
EdgeSpeak は、文字起こし、アライメント、話者分離、読み上げ、ローカル言語モデルを扱う 13 個の MCP ツールを提供します。Claude Code など MCP 対応のエージェントに一度登録すれば、「このフォルダーの会議録音をすべて文字起こしして、話者ごとに議事録をまとめて」「この動画に単語ごとの字幕を付けて」と自然な言葉で依頼できます。EdgeSpeak Agent Skill をインストールすると、文字起こし、文の区切り、アライメント、字幕の書き出しまで、一連の処理をエージェントが実行できます。
Claude Code と EdgeSpeak の組み合わせは、動画編集にも役立ちます。Claude Code は FFmpeg を使った動画処理ができ、EdgeSpeak が発言内容の認識と単語ごとの開始・終了時刻を補います。「このインタビューの言い間違いと 2 秒を超える間をカットして」「料金について話している部分を短いクリップにして、単語ごとの字幕を付けて」と頼むだけで、エージェントが EdgeSpeak で文字起こしとアライメントを行い、タイムスタンプに沿って編集し、字幕を焼き込みます。処理はすべてパソコン上で完結します。
claude mcp add edgespeak -- edgespeak-cli mcp詳しくは MCP ドキュメントをご覧ください。
プライバシー
文字起こし、アライメント、話者分離、読み上げは、すべてローカルモデルで実行します。音声、動画、文字起こしデータ、辞書はデバイス内だけに保存され、サーバーにはアップロードされません。顧客の録音、社内会議、インタビューなど、機密性の高い素材の処理に適しています。ネットワークを使うのは、ログイン、ライセンス認証、モデルのダウンロードのみです。音声対話でクラウドモデルを選んだ場合は、その部分を該当サービスが処理します。詳しくはプライバシーポリシーをご覧ください。
使い始めるには
ダウンロードページからデスクトップアプリをインストールし、ログイン後、必要なモデルをアプリ内でダウンロードします。無料プランですぐに試せるほか、買い切りライセンスを購入すると、今後のモデルや音声機能のアップデートも含め、最大 4 台のデバイスで永続的に利用できます。各プランの利用枠と料金は料金ページをご覧ください。