EdgeSpeak: Sprach-KI auf dem Gerät, alles in einem – Transkription, Sprachausgabe, Alignment, Übersetzung, Musik und LLMs
Transkription, Sprachausgabe, Alignment, Musikgenerierung und Übersetzung, dazu Sprechertrennung und Sprachchats in Echtzeit: EdgeSpeak bringt das gesamte Spektrum der Sprach-KI auf den eigenen Computer. Die 26 Minuten lange Aufnahme einer Produktvorstellung mit vier wechselnden Sprechern wird auf Apple M5 in 33 Sekunden transkribiert. Der maximale Speicherbedarf liegt dabei bei rund 1.0 GB.
Transkription ist erst der Anfang: Dazu kommen Forced Alignment in 346 Sprachen, lokale Übersetzung in 38 Sprachen, 11 Modelle für die Sprachausgabe und YuE2, das aus Liedtexten vollständige Songs mit Gesang und Begleitung erzeugt. Über 13 MCP-Tools können Agenten wie Claude Code direkt darauf zugreifen. Für macOS (Apple Silicon) und Windows gibt es die Desktop-App und die CLI, für Linux die CLI. Audio, Video und Transkripte bleiben auf dem eigenen Computer.
Präzise, schnell und sparsam
Wir haben viel Arbeit investiert, damit lokale Modelle auch auf gewöhnlichen Computern schnell und präzise laufen: Die Modelle werden auf eine zum Gerät passende Größe komprimiert und quantisiert. Die Inferenz-Engine wird gezielt für Metal auf Apple Silicon, CUDA auf NVIDIA-GPUs und das plattformübergreifende Vulkan beschleunigt. Computer ohne dedizierte GPU nutzen die CPU.
Die vollständigen Messergebnisse für die 26 Minuten lange Produktvorstellung auf Apple M5:
| Messgröße | Ergebnis |
|---|---|
| Genauigkeit | Wortfehlerrate (WER) 6.6% |
| Transkriptionsgeschwindigkeit | 33 Sekunden, etwa 48× Echtzeit |
| Alignment-Geschwindigkeit | Vorhandenes Transkript in 8.8 Sekunden am Audio ausgerichtet |
| Speicherbedarf | Spitzenwert des Transkriptionsprozesses bei rund 1.0 GB |
Unter Windows mit einer NVIDIA RTX 3060 liegt der Echtzeitfaktor der Transkription bei etwa 0.04, also rund 25× Echtzeit. Für schwächere Computer steht das schlankere Lattice-2 Lite zur Wahl. Die Laufzeiten unterscheiden sich je nach Computer.
Die Modelle im Überblick
| Funktion | Modelle |
|---|---|
| Transkription | Lattice-2 Lite / Flash / Pro, drei Varianten je nach Hardware und gewünschter Genauigkeit |
| Forced Alignment | Lattice-2, unterstützt 346 Sprachen |
| Lokale Übersetzung | Übersetzungsmodelle Lattice-2 Lite / Flash / Pro, 38 Zielsprachen, mit Übersetzungs-API |
| Sprachchat | Integrierte Modelle von Qwen und Gemma von 0.6B bis 27B; kompatible GGUF-Modelle lassen sich importieren |
| Sprachausgabe (TTS) | 11 Modelle: Qwen3-TTS (0.6B / 1.7B Base und CustomVoice sowie 1.7B VoiceDesign), FireRedTTS3 (Instruct, Base), OmniVoice, IndexTTS-2.5, VoxCPM2 und Breeze-TTS-2, mit Streaming-Wiedergabe, Stimmenklonen und Stimmgestaltung anhand einer Beschreibung |
| Musikgenerierung | YuE2 erzeugt aus Liedtexten vollständige Songs mit Gesang und Begleitung, kostenlos nutzbar |
Modelle werden bei Bedarf in der App heruntergeladen und funktionieren anschließend offline.
Sprachen
Die Modelle von EdgeSpeak sind von Grund auf mehrsprachig ausgelegt und gehen über Chinesisch und Englisch hinaus:
| Funktion | Sprachabdeckung |
|---|---|
| Transkription | Über 40 Sprachen, darunter Chinesisch, Kantonesisch, Englisch, Japanisch, Koreanisch, Arabisch, Hindi, Thai, Vietnamesisch und die wichtigsten europäischen Sprachen |
| Forced Alignment | 346 Sprachen, auch bei mehrsprachigen Texten |
| Übersetzung | 38 Zielsprachen, darunter traditionelles Chinesisch und Uigurisch |
| Sprachausgabe (TTS) | OmniVoice deckt alle Sprachen im Katalog ab und akzeptiert weitere ISO 639-Sprachen; FireRedTTS3 unterstützt 24 Sprachen und 21 chinesische Dialekte wie Sichuanisch; Qwen3-TTS unterstützt 10 Sprachen |
Welche Funktionen für die einzelnen Sprachen verfügbar sind, steht im Sprachleitfaden.
Transkription
Audio oder Video importieren und ein Transkript mit Zeitstempeln in einer von über 40 Sprachen erhalten: Die vollständige Liste steht im Sprachleitfaden. Der Export ist als Klartext, SRT, VTT-Untertitel oder JSON möglich. Namen, Produktbegriffe und Fachausdrücke lassen sich im Wörterbuch hinterlegen, damit sie korrekt erkannt und nach den eigenen Vorgaben übersetzt werden. Lattice-2 gibt es in drei Varianten: Lite benötigt am wenigsten Speicher und eignet sich für schlanke Laptops; Flash ist die Standardvariante mit einem ausgewogenen Verhältnis von Geschwindigkeit und Genauigkeit; Pro liefert innerhalb dieser drei Varianten die höchste Genauigkeit. Flash transkribiert eine 111.7 Sekunden lange englische Aufnahme in etwa 2.6 Sekunden. Mehr unter Sprache zu Text.
Forced Alignment
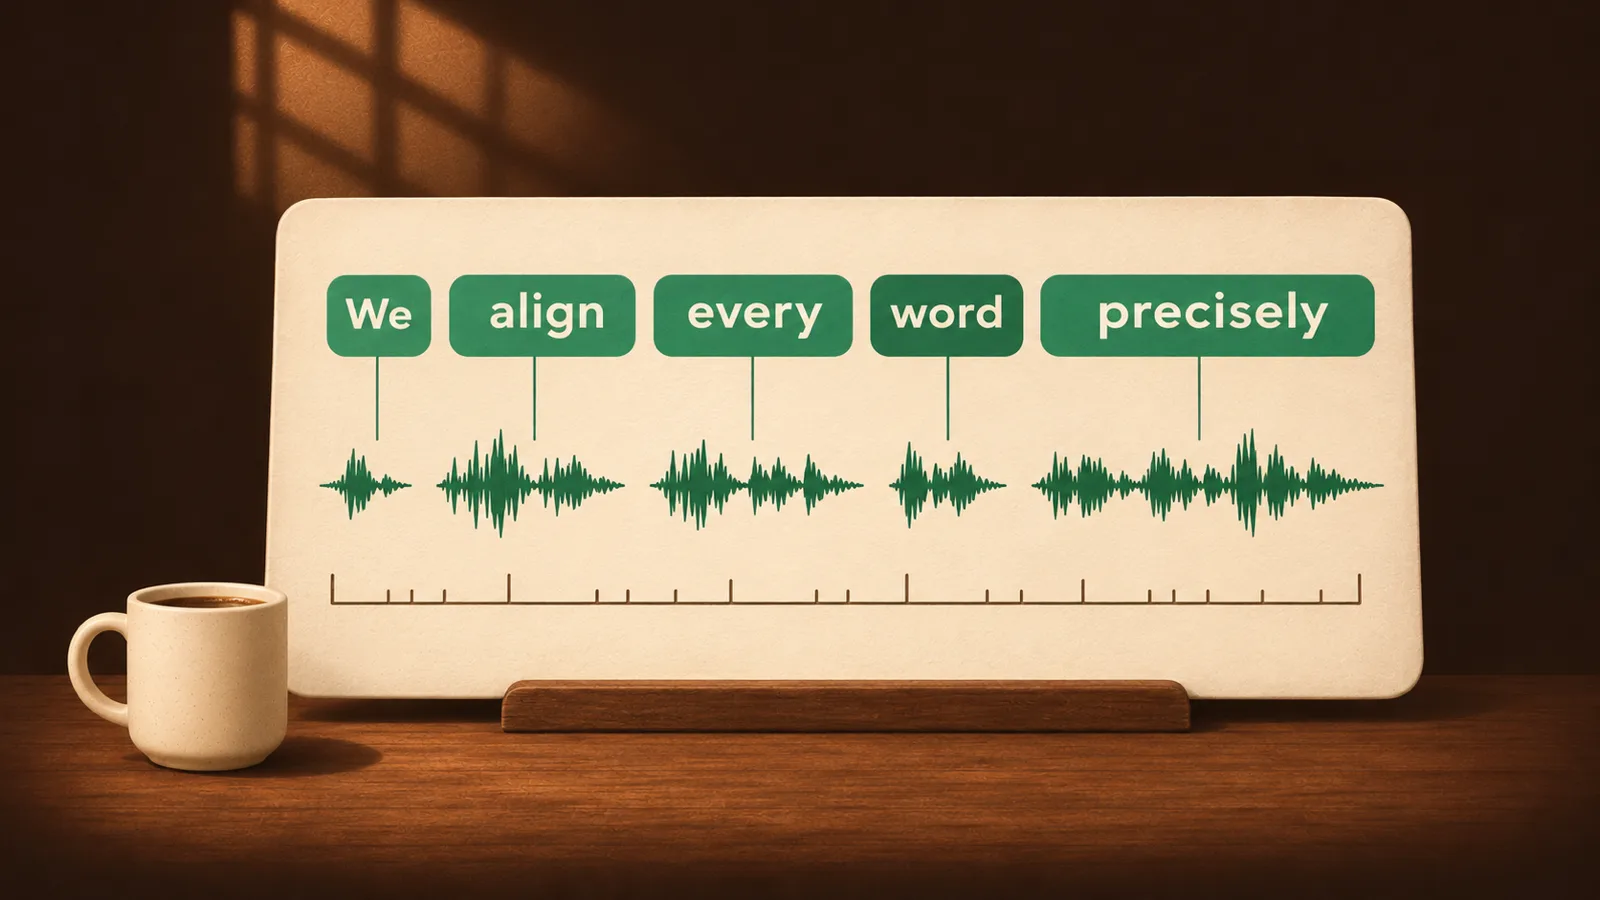
Wer bereits ein Skript, Vortragsnotizen oder einen Liedtext hat, muss nicht erneut transkribieren: Der Text lässt sich direkt am Audio ausrichten und erhält Start- und Endzeiten für jedes Wort und jeden Satz. Alignment unterstützt 346 Sprachen, darunter Chinesisch, Englisch, Japanisch, Koreanisch, die wichtigsten europäischen Sprachen und viele kleinere Sprachen. Die Einsatzmöglichkeiten reichen von präzise getakteten Videountertiteln über Karaoke-Untertitel, die jedes Wort beim Singen oder Sprechen hervorheben, bis zu anklickbaren Transkripten für Hörbücher, Podcasts und Kurse. Das hilft bei Liedtextvideos und beim Sprachenlernen ebenso wie beim schnellen Auffinden einzelner Sätze für Schnitt und Synchronisation. Alignment verarbeitet auch mehrere Stunden lange Audiodateien und Texte, sodass sich eine ganze Besprechung oder ein vollständiges Hörbuch in einem Durchgang ausrichten lässt.
Alignment ist deutlich schneller als eine erneute Transkription: Die wortgenaue Ausrichtung einer 20 Sekunden langen englischen oder chinesischen Aufnahme dauert etwa 0.16 Sekunden. Bei der 26 Minuten langen Produktvorstellung wurden alle 374 Sätze in 8.8 Sekunden ausgerichtet, mit einer medianen Abweichung der Startzeiten von 40 Millisekunden. Mehr unter Forced Alignment. Die Abweichungen an den Wortgrenzen bei kurzen Sätzen, 60-Minuten-Aufnahmen und auf Chinesisch sowie den Vergleich mit MFA, ElevenLabs und Qwen3-ForcedAligner zeigt der Forced-Alignment-Benchmark zu Wortzeitstempeln.
Für den Videoschnitt
Die Wortzeitstempel aus Transkription und Alignment liefern genau die Daten, die der Videoschnitt braucht. Videos mit sprechenden Personen, Interviews, Kurse und Podcasts lassen sich anhand des Transkripts schneiden: Versprecher, Wiederholungen und lange Pausen im Text zeigen, welche Stellen aus dem Material entfernt werden können. Ausgewählte prägnante Aussagen lassen sich anhand ihrer Start- und Endzeiten zu kurzen Clips schneiden. Exportierte SRT-Untertitel können direkt in Premiere Pro, Final Cut Pro, DaVinci Resolve und andere Schnittprogramme importiert werden. Das manuelle Festlegen der Zeiten für jede Untertitelzeile entfällt.
Sprechertrennung
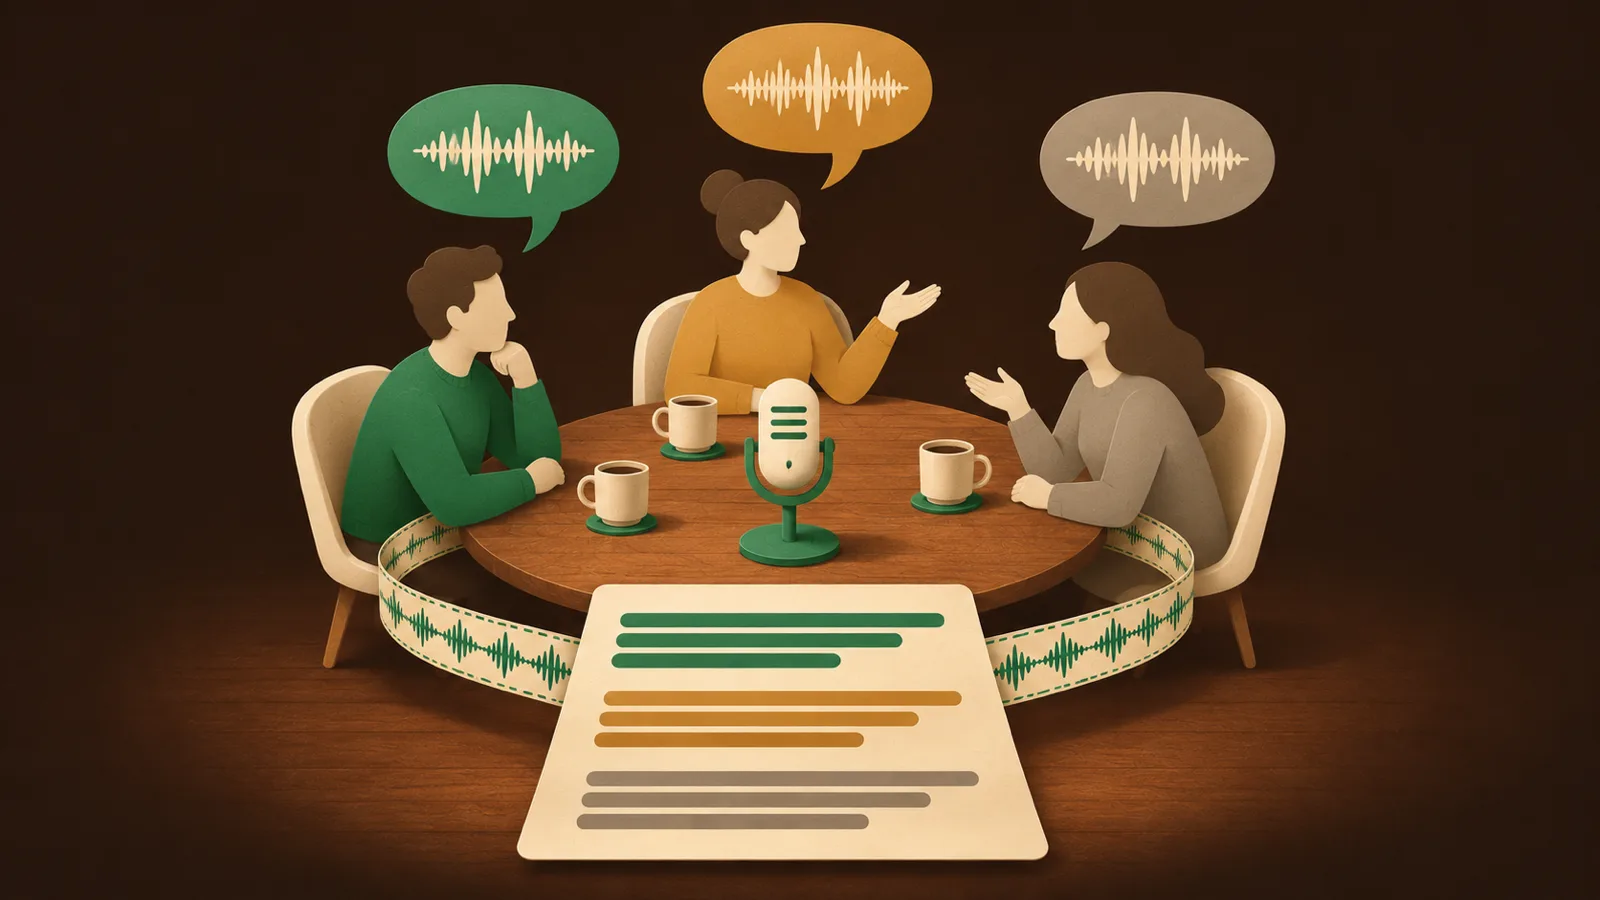
Bei Besprechungen, Interviews und Podcasts kennzeichnet das Transkript, wer welchen Satz gesagt hat. So lässt es sich leicht als Dialog aufbereiten. Die Sprechertrennung läuft in derselben Anfrage wie die Transkription und verlängert die Wartezeit kaum: Bei einer 111.7 Sekunden langen Aufnahme benötigt die Sprecherkennzeichnung nur etwa 0.2 Sekunden zusätzlich zur reinen Transkription. Mehr unter Sprechertrennung.
Übersetzung
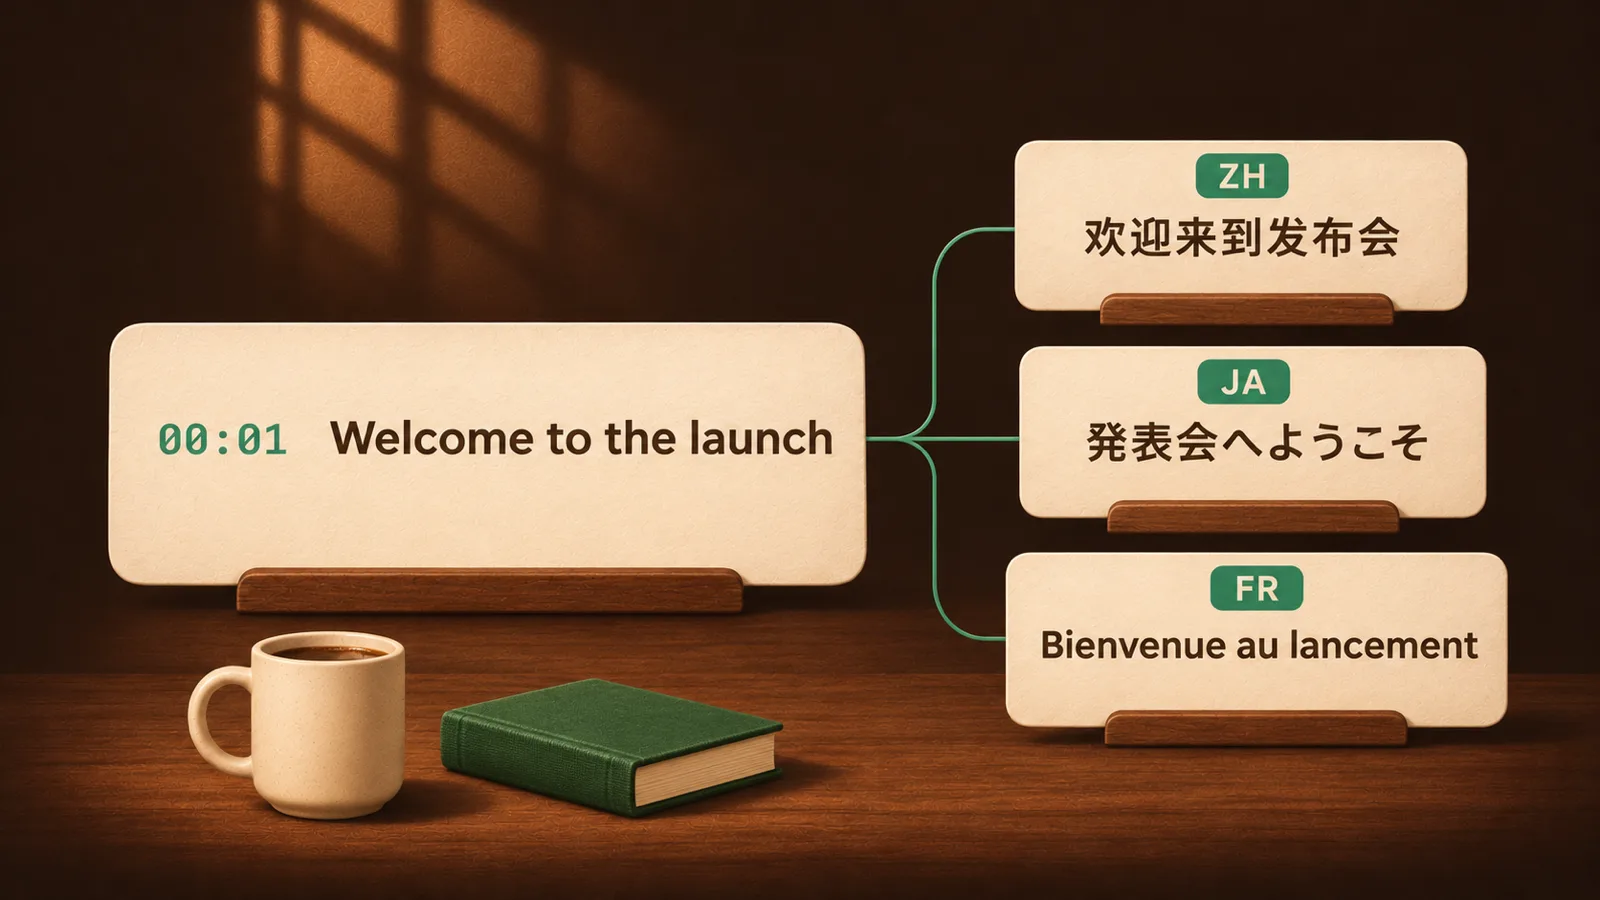
Transkripte und Alignment-Ergebnisse lassen sich auf dem eigenen Computer in 38 Zielsprachen übersetzen, darunter traditionelles Chinesisch. Dafür kommen die dedizierten lokalen Übersetzungsmodelle Lattice-2 Lite / Flash / Pro zum Einsatz, die nach dem Download offline arbeiten. Sie übersetzen, ohne den Text umzuschreiben oder zusammenzufassen. Die Übersetzungen behalten die ursprüngliche Zeitachse bei. Zur Auswahl stehen Ansichten für das Original, die Gegenüberstellung und die Übersetzung; beim Export lässt sich die Anordnung von Original und Übersetzung festlegen. Typische Anwendungen sind chinesische, englische oder zweisprachige Untertitel für fremdsprachige Videos und Kurse, übersetzte Besprechungs- und Interviewtranskripte für anderssprachige Kollegen sowie fremdsprachige Podcasts und Produktvorstellungen zum Nachlesen in der eigenen Sprache. Vor der Übersetzung lässt sich die Aufnahme in ein oder zwei Sätzen beschreiben und ein natürlicher, umgangssprachlicher oder originalgetreuer Stil wählen. Namen und Produktbegriffe aus dem Wörterbuch werden nach den hinterlegten Vorgaben übersetzt. Für Korrekturen oder sprachlichen Feinschliff kann ein selbst konfigurierter kommerzieller Modelldienst verwendet werden. Mehr unter Transkripte lokal übersetzen und Übersetzungsanforderungen formulieren.
Das lokale Gateway bietet auch eine Übersetzungs-API: Ein translation-Parameter mit Zielsprache und Stil in einer Chat Completions- oder Responses-Anfrage genügt, damit das lokale Übersetzungsmodell die Anfrage übernimmt. MCP-Tools und die Realtime-Simultanübersetzung verwenden dasselbe Format. Mehr in der Dokumentation zur Übersetzungs-API.
{
  "model": "EdgeSpeak/Lattice-2-Flash",
  "input": "Willkommen zur heutigen Produktvorstellung.",
  "translation": { "target_language": "ja", "style": "natural" }
}
Sprache verstehen und per Stimme chatten
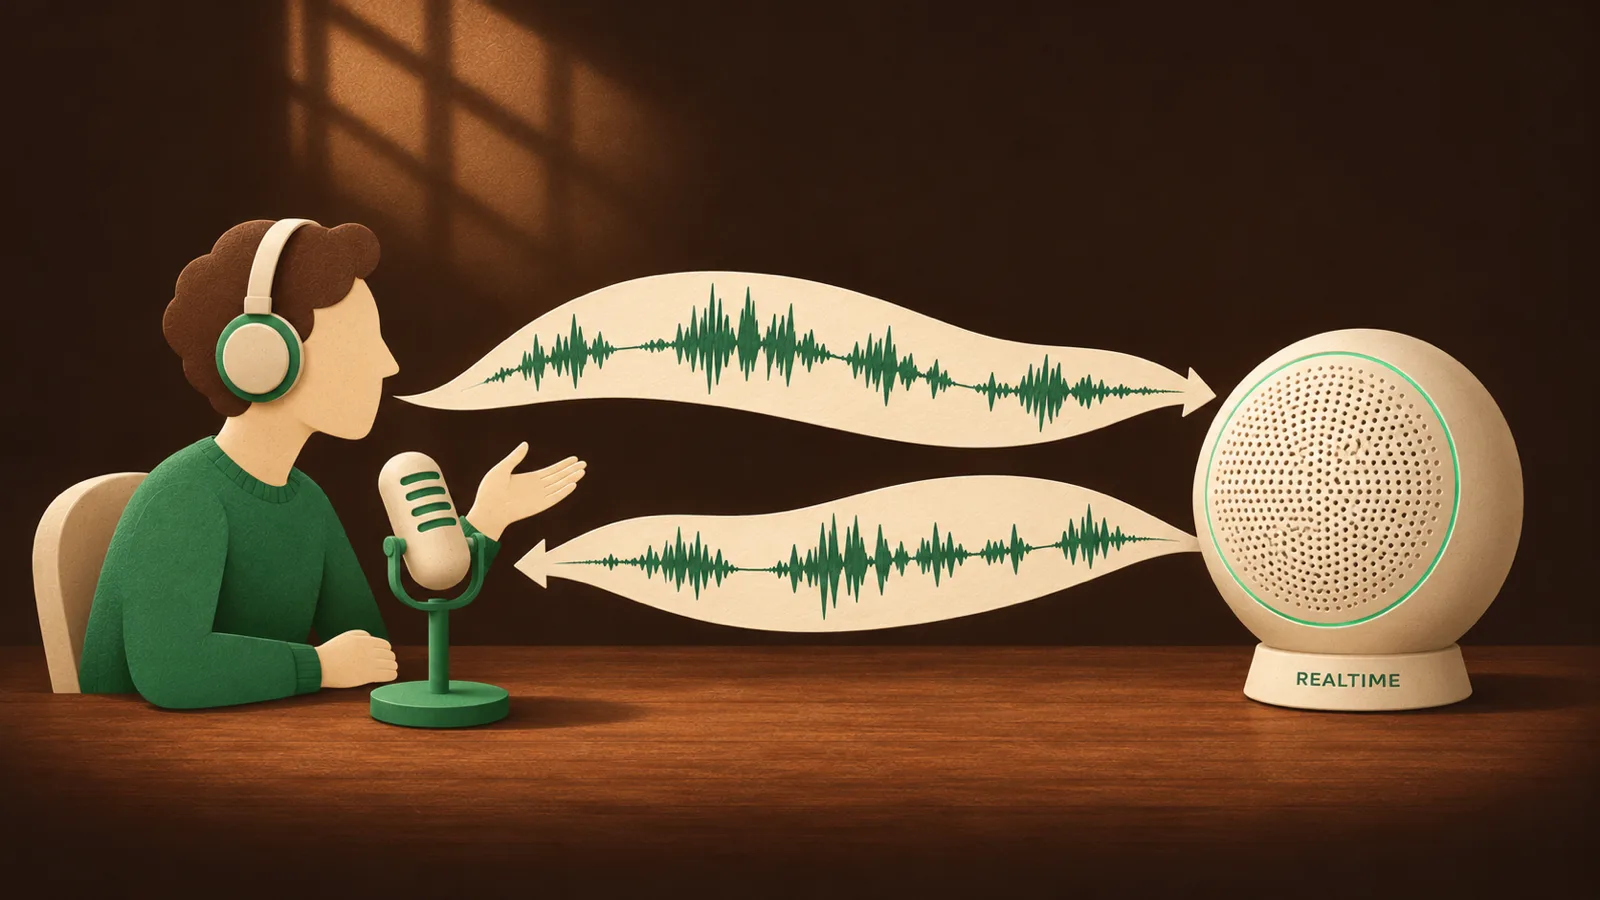
Ins Mikrofon sprechen, und das KI-Modell versteht die Eingabe und antwortet per Stimme. Dafür stehen Rollen wie Sprachpartner oder Rollenspiel zur Auswahl. Beim Sprachpartner könnte die Anweisung lauten: „Spiele einen Barista im Café und übe mit mir das Bestellen auf Spanisch.“ Im Modus für Simultanübersetzung spricht man eine Sprache und hört eine andere.
Entwickler können mit denselben Funktionen eigene Sprachanwendungen bauen: Das lokale Gateway bietet eine Realtime API (WebSocket) für Sprachgespräche in Echtzeit, bei denen man die Antwort durch Sprechen unterbrechen kann, oder für reine Echtzeit-Transkription. Je nach Computer stehen für die Unterhaltung Sprachmodelle von 0.6B bis 27B zur Wahl. Unter Windows mit einer RTX 3060 und Vulkan erreicht die Generierung etwa 173 token pro Sekunde. Mehr unter Sprachchat und in der Dokumentation zur Realtime API.
Sprachausgabe (TTS) und Musikgenerierung
Text eingeben und Sprache erzeugen, die schon während der Generierung abgespielt wird, oder als WAV exportieren. EdgeSpeak unterstützt 11 aktuelle Open-Source-Modelle für die Sprachausgabe aus sechs Familien: Qwen3-TTS, FireRedTTS3, OmniVoice, IndexTTS-2.5, VoxCPM2 und Breeze-TTS-2. Jedes hat eigene Stärken, sodass sich die Auswahl nach Sprache, Stimme und Geschwindigkeit richten kann. Leistungsfähige neue Modelle ergänzen wir fortlaufend. Neben den integrierten Stimmen können Modelle mit entsprechender Unterstützung aus einer klaren Referenzaufnahme eine eigene Stimme erstellen oder anhand einer Textbeschreibung eine Stimme gestalten.
Auch die Sprachausgabe nutzt Streaming und Beschleunigung: Auf Apple M5 Ultra beginnt Qwen3-TTS 0.6B bei einem englischen Text mit 31 Wörtern nach etwa 60 bis 90 Millisekunden mit der Tonausgabe und erzeugt die rund 11 Sekunden Audio in etwa 2.1 Sekunden. Auf einer NVIDIA-GPU benötigt FireRedTTS3 etwa das 0.26× der Audiolänge. Mehr unter Sprachausgabe.
Songs aus Liedtexten
Die Seite für die Sprachausgabe enthält auch das Musikmodell YuE2. Ein Liedtext mit Abschnittsmarkierungen wie [Verse] und [Chorus] sowie ein Satz zu Genre, Gesang und Instrumenten genügen, um auf dem eigenen Computer einen vollständigen Song mit Gesang und Begleitung als 48 kHz-Stereo-Audio zu erzeugen. Das Modell kann zunächst eine Partitur planen, die sich vor der Generierung prüfen und bearbeiten lässt. Auch eigene ABC-Notation kann eingefügt werden. Die Songgenerierung mit YuE2 ist kostenlos und verbraucht kein Kontingent.
Wir haben YuE2 mit einer neuen Sampling-Methode ausgestattet: AB3 verwendet standardmäßig 14 Schritte und nur 15 Modellauswertungen. Das erzeugte Audio ist nahezu identisch mit der Referenz aus 32 Schritten (SNR rund 29 dB). Auf Apple Silicon sank die Dauer der Klangerzeugung und Dekodierung von etwa dem 1.5× auf etwa das 0.67× der Songlänge, nahe an Echtzeit (ohne die anfängliche Melodieplanung und das Laden des Modells). Auf einer NVIDIA RTX 4090 wird ein 22.3 Sekunden langer Song in etwa 9.1 Sekunden erzeugt. Die Gewichte von YuE2 behalten die CC BY-NC 4.0-Lizenz der ursprünglichen Autoren und dürfen nur für nichtkommerzielle Zwecke genutzt werden.
Der folgende Song wurde von YuE2 auf einem lokalen Computer erzeugt. Anschließend haben wir den Liedtext mit Forced Alignment in EdgeSpeak am Gesang ausgerichtet, Start- und Endzeiten jedes Wortes ermittelt, wortweise hervorgehobene Karaoke-Untertitel exportiert und in das Video eingebrannt. Spektrum und Wellenform bewegen sich zur Musik; der Titelbereich zeigt die Modelleinstellungen dieses Durchlaufs. Generierung, Alignment und Untertitel entstanden auf demselben Computer.
Lokales Gateway: umfassende Sprach- und Textfunktionen
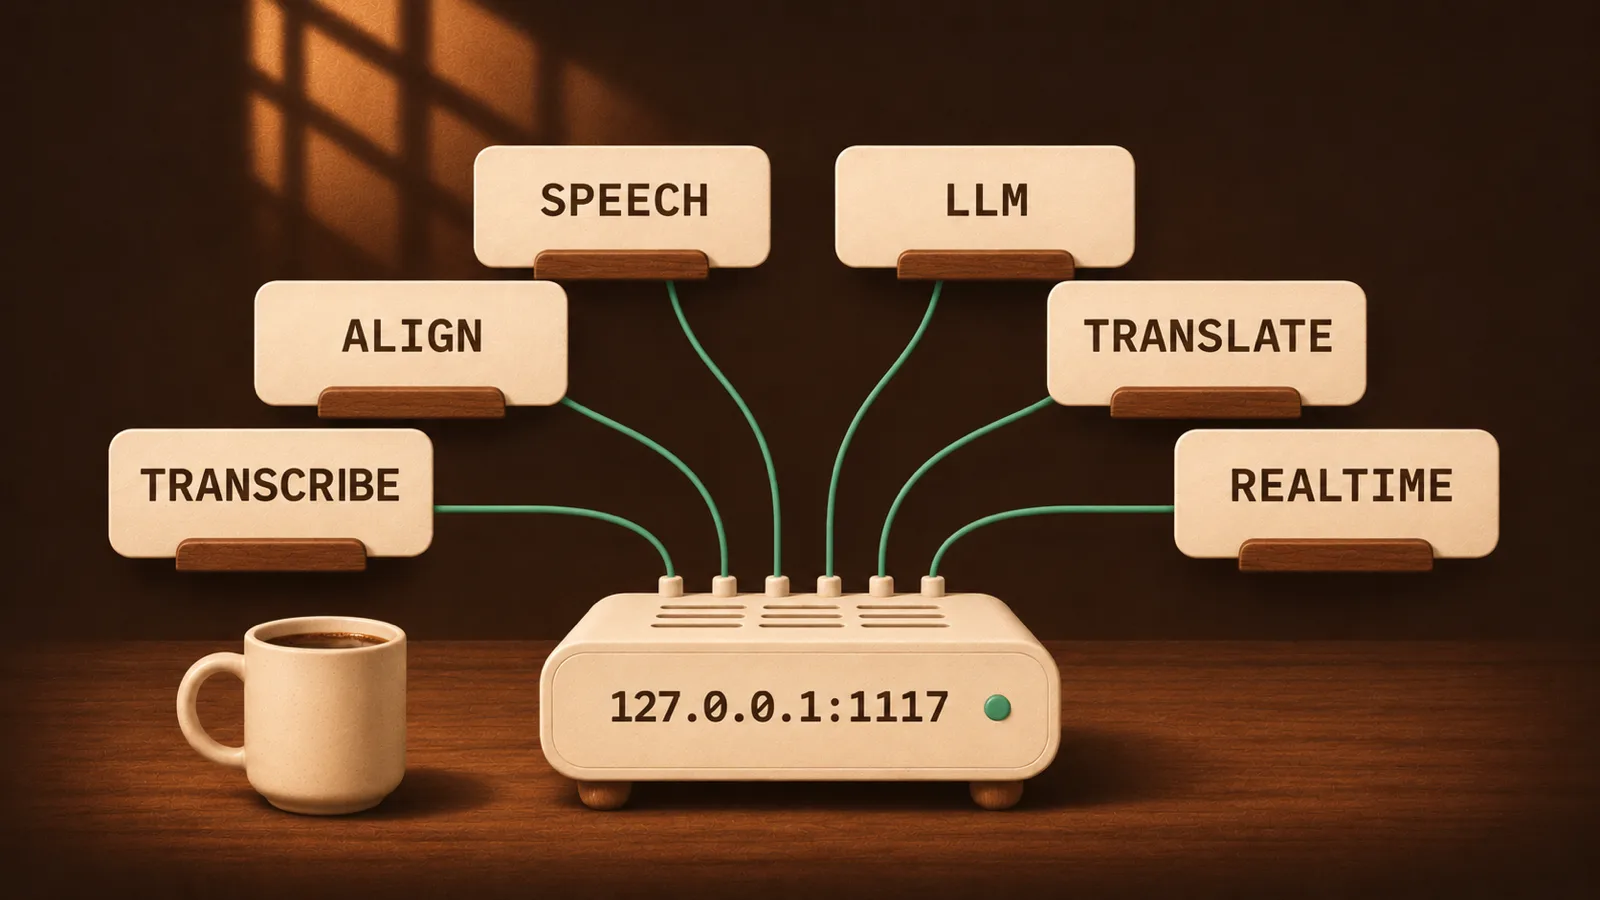
Beim Öffnen der Desktop-App startet das lokale Gateway unter http://127.0.0.1:1117/v1. Mit edgespeak-cli serve lässt es sich auch eigenständig ohne Desktop-App starten. Das Gateway folgt den Konventionen der OpenAI API und vereint Transkription, Alignment, Sprachausgabe, LLMs, Übersetzung und Echtzeit-Sprachfunktionen unter einer Adresse:
| Funktion | Endpunkte |
|---|---|
| Transkription, Sprechertrennung | /v1/audio/transcriptions, /v1/speaker/diarizations |
| Forced Alignment | /v1/audio/alignments |
| Sprachausgabe, Stimmerstellung | /v1/audio/speech, /v1/audio/voices |
| LLM-Chat, Übersetzung, Bildverarbeitung | /v1/responses, /v1/chat/completions, /v1/messages |
| Sprachchat in Echtzeit | /v1/realtime (WebSocket) |
| Agenten-Tools | /mcp |
Für diese Funktionen muss man sich üblicherweise bei mehreren Cloud-Diensten anmelden und jeweils bezahlen. Mit dem lokalen Gateway liegen die grundlegenden Sprach- und LLM-Funktionen auf dem eigenen Computer. Separate API-Dienste sind dafür nicht nötig. Vorhandener Code mit dem OpenAI SDK funktioniert, sobald die Basis-URL auf den eigenen Rechner zeigt. Um andere vertrauenswürdige Computer im Netzwerk zu bedienen, lässt sich der Dienst ohne Oberfläche starten. Was das Gateway abdeckt und welche der beiden Betriebsarten passt, erklärt die Einführung zum lokalen Sprach-Gateway; Details zu den Endpunkten stehen in der API-Dokumentation.
Mit KI-Agenten nutzen
EdgeSpeak bietet 13 MCP-Tools für Transkription, Alignment, Sprechertrennung, Sprachausgabe und lokale Sprachmodelle. Nach einmaliger Registrierung in Claude Code oder einem anderen MCP-fähigen Agenten reichen Anweisungen in natürlicher Sprache: „Transkribiere alle Besprechungsaufnahmen in diesem Ordner und erstelle daraus nach Sprechern gegliederte Notizen“ oder „Erstelle wortweise Untertitel für dieses Video“. Mit installiertem EdgeSpeak Agent Skill kann der Agent den gesamten Ablauf von Transkription und Satzsegmentierung über Alignment bis zum Untertitelexport ausführen.
Auch beim Videoschnitt ergänzen sich Claude Code und EdgeSpeak: Claude Code nutzt bereits FFmpeg zur Videobearbeitung. EdgeSpeak liefert das Verständnis des gesprochenen Inhalts samt Start- und Endzeit jedes Wortes. Eine Anweisung wie „Schneide die Versprecher und alle Pausen über zwei Sekunden aus diesem Interview“ oder „Erstelle aus den Stellen zur Preisgestaltung kurze Clips mit wortweisen Untertiteln“ genügt. Der Agent transkribiert und richtet mit EdgeSpeak aus, schneidet anschließend anhand der Zeitstempel und brennt die Untertitel ein. Alles läuft auf dem eigenen Computer.
claude mcp add edgespeak -- edgespeak-cli mcpMehr in der MCP-Dokumentation.
Datenschutz
Transkription, Alignment, Sprechertrennung und Sprachausgabe laufen vollständig mit lokalen Modellen. Audio, Video, Transkripte und Wörterbücher werden ausschließlich auf dem eigenen Gerät gespeichert und auf keinen Server hochgeladen. Das eignet sich für Kundenaufnahmen, interne Besprechungen, Interviews und andere sensible Inhalte. Eine Netzwerkverbindung wird nur für die Anmeldung, Lizenzaktivierung und Modelldownloads genutzt. Wer im Sprachchat ein Cloud-Modell auswählt, lässt diesen Teil vom entsprechenden Dienst verarbeiten. Mehr in der Datenschutzerklärung.
Einstieg
Die Desktop-App von der Downloadseite installieren, anmelden und die benötigten Modelle in der App herunterladen. Mit dem kostenlosen Tarif lässt sich EdgeSpeak direkt ausprobieren. Alternativ gibt es eine Lizenz gegen Einmalzahlung für die dauerhafte Nutzung auf bis zu 4 Geräten, einschließlich künftiger Modell- und Sprachfunktionsupdates. Kontingente und Preise der einzelnen Tarife stehen auf der Preisseite.