EdgeSpeak : l’IA vocale sur l’appareil, tout-en-un — transcription, synthèse vocale, alignement, traduction, musique et LLM
Transcription, synthèse vocale, alignement, génération musicale et traduction, mais aussi séparation des locuteurs et conversations vocales en temps réel : EdgeSpeak fait tourner toute la chaîne d’IA vocale sur votre appareil. Un enregistrement de présentation de 26 minutes, où quatre intervenants prennent la parole à tour de rôle, est transcrit en 33 secondes sur Apple M5, avec un pic de mémoire d’environ 1.0 GB.
La transcription n’est qu’un début : alignement forcé en 346 langues, traduction locale vers 38 langues, 11 modèles de synthèse vocale et YuE2, qui transforme des paroles en chansons complètes avec voix et accompagnement. Grâce à 13 outils MCP, des agents comme Claude Code peuvent appeler EdgeSpeak directement. L’application de bureau et la CLI sont disponibles sur macOS (Apple Silicon) et Windows, et la CLI sur Linux. Vos fichiers audio, vos vidéos et vos transcriptions restent sur votre ordinateur.
Précision, rapidité et légèreté
Nous avons beaucoup travaillé pour rendre les modèles locaux rapides et précis sur des ordinateurs courants : les modèles sont compressés et quantifiés à une taille adaptée à l’appareil, et le moteur d’inférence bénéficie d’accélérations spécifiques pour Metal sur Apple Silicon, CUDA sur les GPU NVIDIA et Vulkan sur plusieurs plateformes. Les ordinateurs sans carte graphique dédiée utilisent le CPU.
Voici l’ensemble des mesures de cet enregistrement de présentation de 26 minutes sur Apple M5 :
| Mesure | Résultat |
|---|---|
| Précision | Taux d’erreur sur les mots (WER) de 6.6% |
| Vitesse de transcription | 33 secondes, soit environ 48× le temps réel |
| Vitesse d’alignement | Texte existant aligné sur l’audio en 8.8 secondes |
| Mémoire | Pic d’environ 1.0 GB pour le processus de transcription |
Sous Windows avec une NVIDIA RTX 3060, le facteur temps réel de la transcription est d’environ 0.04, soit environ 25× le temps réel. Les ordinateurs moins puissants peuvent utiliser Lattice-2 Lite, plus léger. Les durées varient d’un ordinateur à l’autre.
Les modèles disponibles
| Fonction | Modèles |
|---|---|
| Transcription | Lattice-2 Lite / Flash / Pro, trois variantes selon votre matériel et vos besoins de précision |
| Alignement forcé | Lattice-2, couvrant 346 langues |
| Traduction locale | Modèles de traduction Lattice-2 Lite / Flash / Pro, 38 langues cibles et une API de traduction |
| Conversation vocale | Modèles Qwen et Gemma intégrés, de 0.6B à 27B ; possibilité d’importer des modèles GGUF compatibles |
| Synthèse vocale | 11 modèles : Qwen3-TTS (0.6B / 1.7B Base et CustomVoice, ainsi que 1.7B VoiceDesign), FireRedTTS3 (Instruct, Base), OmniVoice, IndexTTS-2.5, VoxCPM2 et Breeze-TTS-2, avec lecture en continu, clonage vocal et création de voix à partir d’une description |
| Génération musicale | YuE2, qui transforme des paroles en chansons complètes avec voix et accompagnement, utilisable gratuitement |
Les modèles se téléchargent à la demande dans l’application et fonctionnent ensuite hors ligne.
Langues
Les modèles d’EdgeSpeak sont conçus dès le départ pour plusieurs langues, au-delà du chinois et de l’anglais :
| Fonction | Langues prises en charge |
|---|---|
| Transcription | Plus de 40 langues, dont le chinois, le cantonais, l’anglais, le japonais, le coréen, l’arabe, l’hindi, le thaï, le vietnamien et les principales langues européennes |
| Alignement forcé | 346 langues, y compris les textes qui en mélangent plusieurs |
| Traduction | 38 langues cibles, dont le chinois traditionnel et l’ouïghour |
| Synthèse vocale | OmniVoice couvre toutes les langues du catalogue et accepte d’autres langues ISO 639 ; FireRedTTS3 prend en charge 24 langues et 21 dialectes chinois, dont le sichuanais ; Qwen3-TTS prend en charge 10 langues |
Consultez le guide des langues pour connaître les fonctions disponibles dans chaque langue.
Transcription
Importez un fichier audio ou une vidéo pour obtenir une transcription horodatée dans l’une des plus de 40 langues prises en charge ; la liste complète figure dans le guide des langues. Exportez le résultat en texte brut, en sous-titres SRT ou VTT, ou en JSON. Ajoutez les noms propres, noms de produits et termes spécialisés au dictionnaire pour qu’ils soient reconnus correctement et traduits selon vos choix. Lattice-2 propose trois variantes : Lite consomme peu de mémoire et convient aux ultraportables ; Flash, le choix par défaut, équilibre vitesse et précision ; Pro offre une précision supérieure. Flash transcrit un enregistrement en anglais de 111.7 secondes en environ 2.6 secondes. Voir la transcription audio.
Alignement forcé
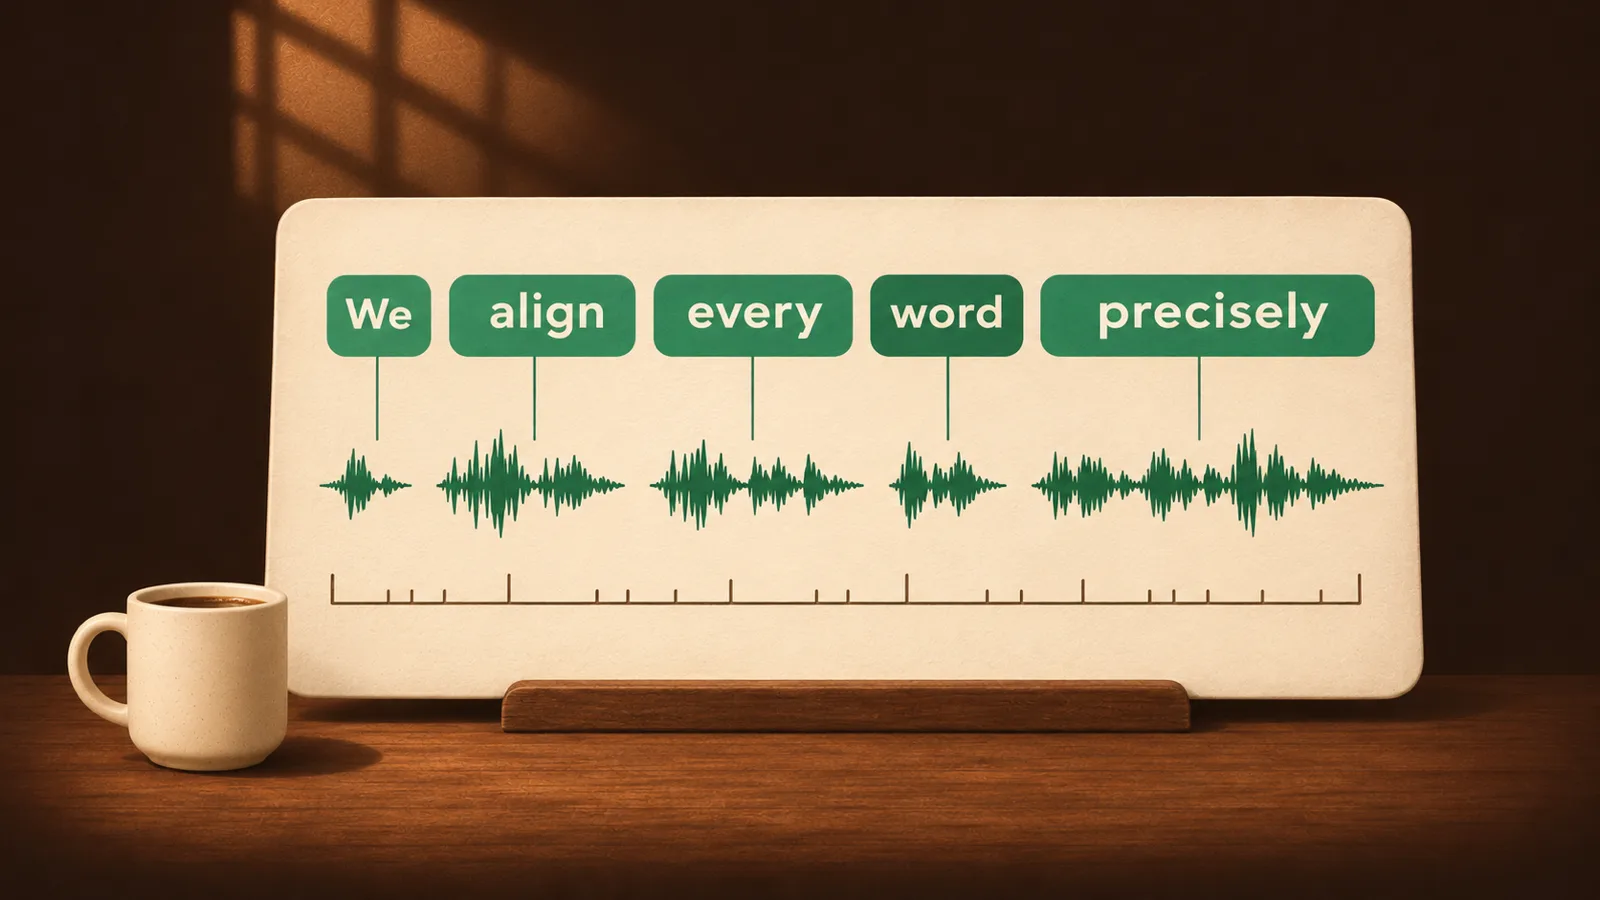
Si vous disposez déjà d’un script, de notes d’intervention ou de paroles, inutile de relancer une transcription : alignez directement le texte sur l’audio pour obtenir les instants de début et de fin de chaque mot et de chaque phrase. L’alignement couvre 346 langues, dont le chinois, l’anglais, le japonais, le coréen, les principales langues européennes et de nombreuses langues moins répandues. Les usages sont variés : des sous-titres précisément synchronisés pour les vidéos ; des sous-titres karaoké qui surlignent chaque mot au fil du chant ou de la parole, pour les vidéos de paroles et l’apprentissage des langues ; des transcriptions permettant d’accéder à un passage d’un livre audio, d’un podcast ou d’un cours en un clic ; et le repérage rapide de chaque réplique pour le montage ou le doublage. L’alignement accepte des fichiers audio et des textes de plusieurs heures : une réunion complète ou un livre audio entier peuvent être alignés en une seule fois.
L’alignement est beaucoup plus rapide qu’une nouvelle transcription : l’alignement mot à mot d’un enregistrement de 20 secondes en anglais ou en chinois prend environ 0.16 seconde ; les 374 phrases de la présentation de 26 minutes ont été alignées en 8.8 secondes, avec une erreur médiane de 40 millisecondes sur les instants de début. Voir l’alignement forcé. L’erreur sur les frontières de mots sur des phrases courtes, sur 60 minutes d’audio et en chinois, ainsi que la comparaison avec MFA, ElevenLabs et Qwen3-ForcedAligner, sont détaillées dans le benchmark d’alignement forcé et d’horodatage mot à mot.
Pour le montage vidéo
Les horodatages par mot issus de la transcription et de l’alignement fournissent précisément les données nécessaires au montage vidéo. Vidéos face caméra, entretiens, cours et podcasts peuvent se monter à partir du texte : repérez les erreurs de parole, les répétitions et les longues pauses dans la transcription pour savoir quels passages retirer ; sélectionnez les citations marquantes et découpez-les en clips courts à partir de leurs instants de début et de fin. Les sous-titres SRT exportés s’importent directement dans Premiere Pro, Final Cut Pro, DaVinci Resolve et d’autres logiciels de montage, sans devoir synchroniser chaque ligne à la main.
Séparation des locuteurs
Pour les réunions, les entretiens et les podcasts, la transcription indique qui prononce chaque phrase, ce qui facilite sa mise en forme en dialogue. La séparation des locuteurs s’effectue dans la même requête que la transcription et ajoute très peu d’attente : sur un enregistrement de 111.7 secondes, les étiquettes de locuteurs ne demandent qu’environ 0.2 seconde de plus qu’une simple transcription. Voir la séparation des locuteurs.
Traduction
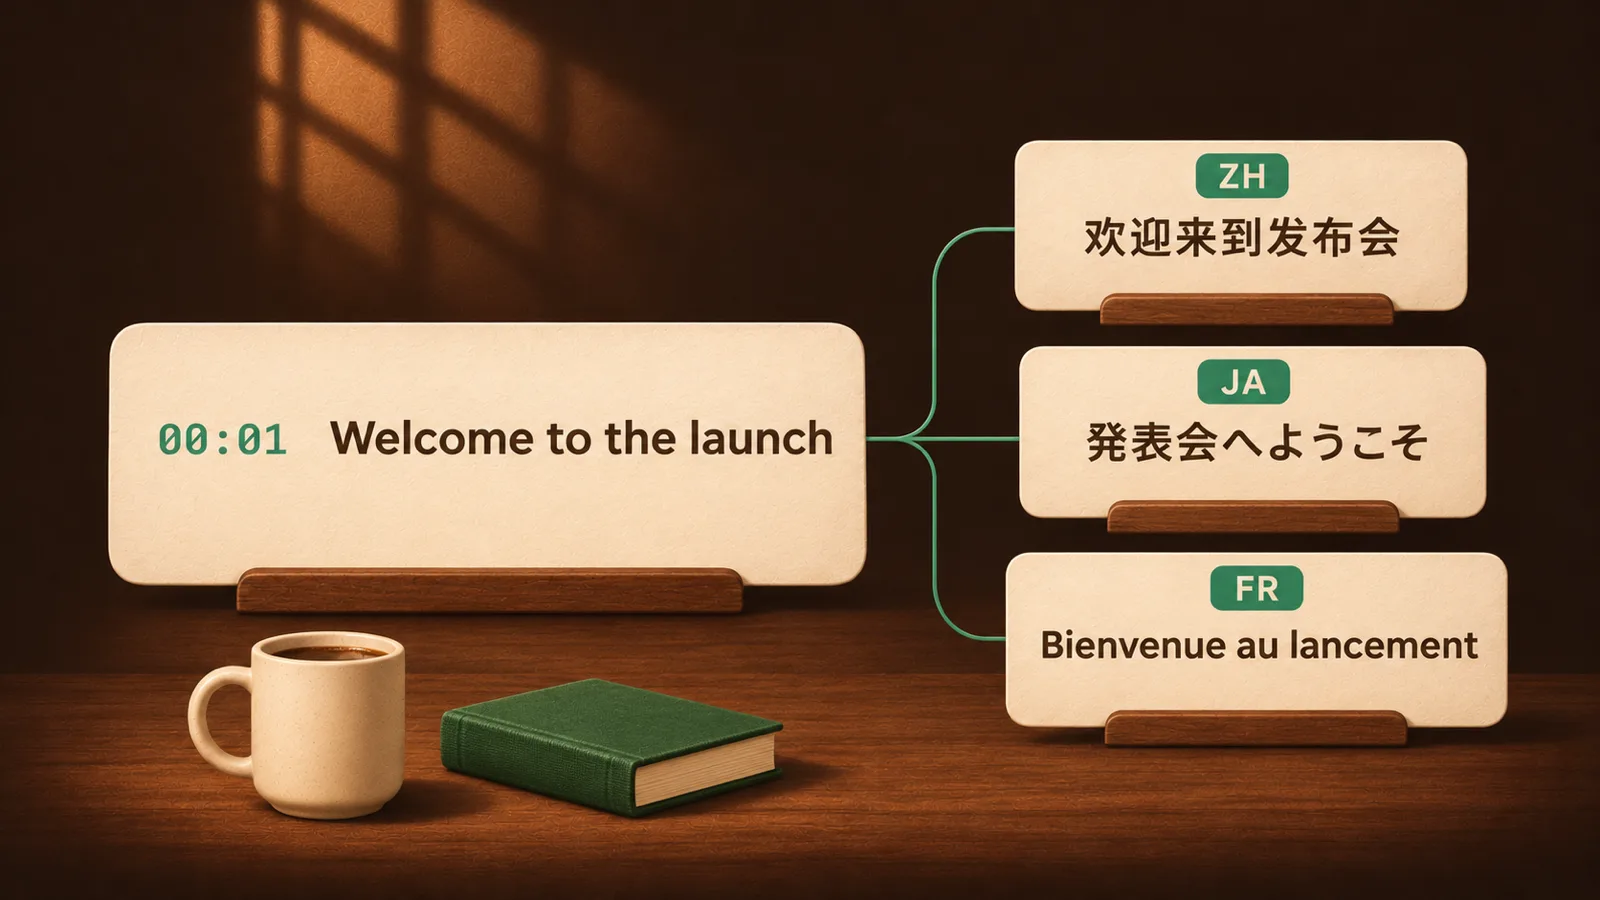
Les transcriptions et les textes alignés peuvent être traduits sur votre ordinateur vers 38 langues cibles, dont le chinois traditionnel. La traduction utilise des modèles locaux dédiés, Lattice-2 Lite / Flash / Pro, qui fonctionnent hors ligne une fois téléchargés ; ils traduisent sans réécrire ni résumer. Les traductions conservent la chronologie d’origine. Vous pouvez afficher le texte original, les deux textes côte à côte ou la traduction seule, puis choisir leur disposition à l’export. Parmi les usages courants : créer des sous-titres chinois, anglais ou bilingues pour des vidéos et des cours en langue étrangère ; traduire des comptes rendus de réunions et d’entretiens pour des collègues parlant une autre langue ; lire dans votre langue des podcasts et des présentations en langue étrangère. Avant de traduire, vous pouvez décrire le contenu de l’enregistrement en une ou deux phrases et choisir un style naturel, conversationnel ou fidèle ; les noms propres et noms de produits du dictionnaire sont traduits selon vos réglages. Pour corriger ou améliorer le texte, vous pouvez passer à un service de modèle commercial que vous configurez vous-même. Voir la traduction locale des transcriptions et la rédaction des consignes de traduction.
La passerelle locale propose aussi une API de traduction : ajoutez un paramètre translation à une requête Chat Completions ou Responses en précisant la langue cible et le style, et le modèle de traduction local s’en charge. Les outils MCP et l’interprétation simultanée Realtime utilisent le même format. Voir la documentation de l’API de traduction.
{
  "model": "EdgeSpeak/Lattice-2-Flash",
  "input": "Bienvenue à la présentation d’aujourd’hui.",
  "translation": { "target_language": "ja", "style": "natural" }
}
Compréhension et conversation vocales
Parlez dans le microphone : le modèle d’IA vous comprend et répond à voix haute. Choisissez un rôle, comme partenaire de conversation pour apprendre une langue ou personnage à incarner ; avec le partenaire linguistique, vous pourriez dire : « Joue le rôle d’un serveur de café et aide-moi à m’entraîner à commander en espagnol. » Passez en interprétation simultanée pour parler dans une langue et entendre la réponse dans une autre.
Les développeurs peuvent créer leurs propres applications vocales avec ces mêmes fonctions : la passerelle locale propose une Realtime API (WebSocket) pour les conversations vocales en temps réel, avec la possibilité d’interrompre la réponse en parlant, ou pour la transcription en temps réel seule. Le modèle de langage utilisé dans la conversation peut aller de 0.6B à 27B selon votre ordinateur ; sous Windows avec une RTX 3060 et Vulkan, la génération atteint environ 173 tokens par seconde. Voir la conversation vocale et la documentation de la Realtime API.
Synthèse vocale et génération musicale
Saisissez du texte pour générer une voix qui se lit au fur et à mesure de sa production, ou exportez-la au format WAV. EdgeSpeak prend en charge 11 modèles de synthèse vocale open source actuels, issus de six familles — Qwen3-TTS, FireRedTTS3, OmniVoice, IndexTTS-2.5, VoxCPM2 et Breeze-TTS-2 — avec chacun leurs points forts : vous pouvez choisir selon la langue, la voix et la vitesse. Nous continuons d’intégrer de nouveaux modèles performants à mesure qu’ils apparaissent. En plus des voix intégrées, les modèles compatibles permettent de créer votre propre voix à partir d’un enregistrement de référence clair, ou de concevoir une voix à partir d’une description textuelle.
La synthèse vocale bénéficie elle aussi de la génération en continu et d’accélérations : sur Apple M5 Ultra, Qwen3-TTS 0.6B commence à produire du son en environ 60 à 90 millisecondes pour un passage de 31 mots en anglais, et génère environ 11 secondes d’audio en quelque 2.1 secondes ; sur un GPU NVIDIA, FireRedTTS3 prend environ 0.26× la durée de l’audio. Voir la synthèse vocale.
Des chansons à partir de paroles
La page de synthèse vocale intègre aussi le modèle musical YuE2. Écrivez des paroles avec des balises de section comme [Verse] et [Chorus], décrivez en une phrase le genre musical, les voix et les instruments : le modèle génère sur votre ordinateur une chanson complète avec voix et accompagnement, en audio stéréo à 48 kHz. Vous pouvez lui faire préparer une partition, la relire et la modifier avant de lancer la génération, ou coller votre propre notation ABC. La génération de chansons avec YuE2 est gratuite et ne consomme pas votre quota.
Nous avons doté YuE2 d’une nouvelle méthode d’échantillonnage, AB3 : 14 étapes par défaut et seulement 15 évaluations du modèle, pour un audio presque identique à la référence en 32 étapes (SNR d’environ 29 dB). Sur Apple Silicon, la durée de la phase de génération sonore et de décodage est passée d’environ 1.5× à environ 0.67× la durée du morceau, proche du temps réel (hors planification initiale de la mélodie et chargement du modèle). Sur une NVIDIA RTX 4090, un morceau de 22.3 secondes est généré en environ 9.1 secondes. Les poids de YuE2 conservent la licence CC BY-NC 4.0 des auteurs d’origine et sont réservés à un usage non commercial.
La chanson ci-dessous a été générée par YuE2 sur un ordinateur local. Nous avons ensuite utilisé l’alignement forcé d’EdgeSpeak pour synchroniser les paroles avec le chant, obtenir les instants de début et de fin de chaque mot, exporter des sous-titres karaoké mot à mot et les incruster dans la vidéo. Le spectre et la forme d’onde évoluent au rythme de la musique, et la zone de titre affiche les paramètres du modèle utilisés pour cette génération. Génération, alignement et sous-titres ont tous été réalisés sur le même ordinateur.
Passerelle locale : toutes les fonctions vocales et textuelles
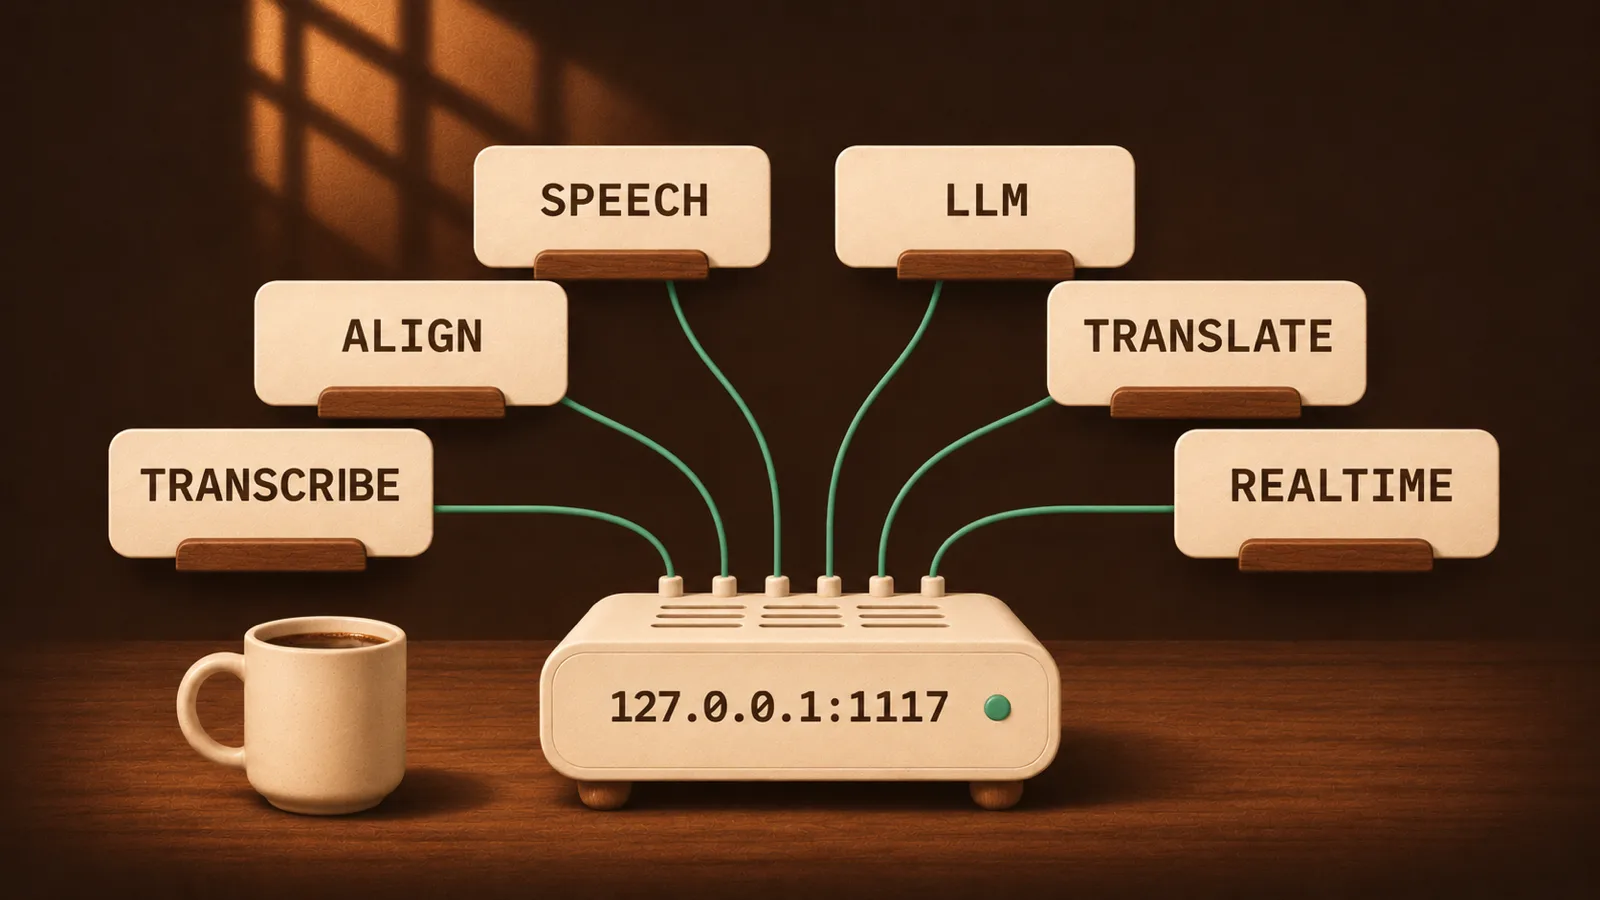
À l’ouverture de l’application de bureau, la passerelle locale démarre à l’adresse http://127.0.0.1:1117/v1 ; vous pouvez aussi la lancer seule avec edgespeak-cli serve, sans l’application de bureau. La passerelle suit les conventions de l’API OpenAI et regroupe transcription, alignement, synthèse vocale, LLM, traduction et voix en temps réel à une seule adresse :
| Fonction | Points d’accès |
|---|---|
| Transcription, séparation des locuteurs | /v1/audio/transcriptions, /v1/speaker/diarizations |
| Alignement forcé | /v1/audio/alignments |
| Synthèse vocale, création de voix | /v1/audio/speech, /v1/audio/voices |
| Conversation avec un LLM, traduction, vision | /v1/responses, /v1/chat/completions, /v1/messages |
| Conversation vocale en temps réel | /v1/realtime (WebSocket) |
| Outils pour agents | /mcp |
Ces fonctions nécessitent habituellement de s’inscrire à plusieurs services cloud et de payer chacun séparément. Avec la passerelle locale, les fonctions de base de traitement vocal et de LLM sont sur votre ordinateur : vous n’avez pas besoin de souscrire des services API distincts pour y accéder. Le code existant utilisant le SDK OpenAI fonctionne dès que son URL de base pointe vers votre machine. Pour donner accès à d’autres machines de confiance sur votre réseau, démarrez le service sans interface graphique. Pour le périmètre de la passerelle et le choix entre ses deux modes de lancement, voir la présentation de la passerelle vocale locale ; le détail des points de terminaison est dans la documentation de l’API.
Utiliser EdgeSpeak avec des agents d’IA
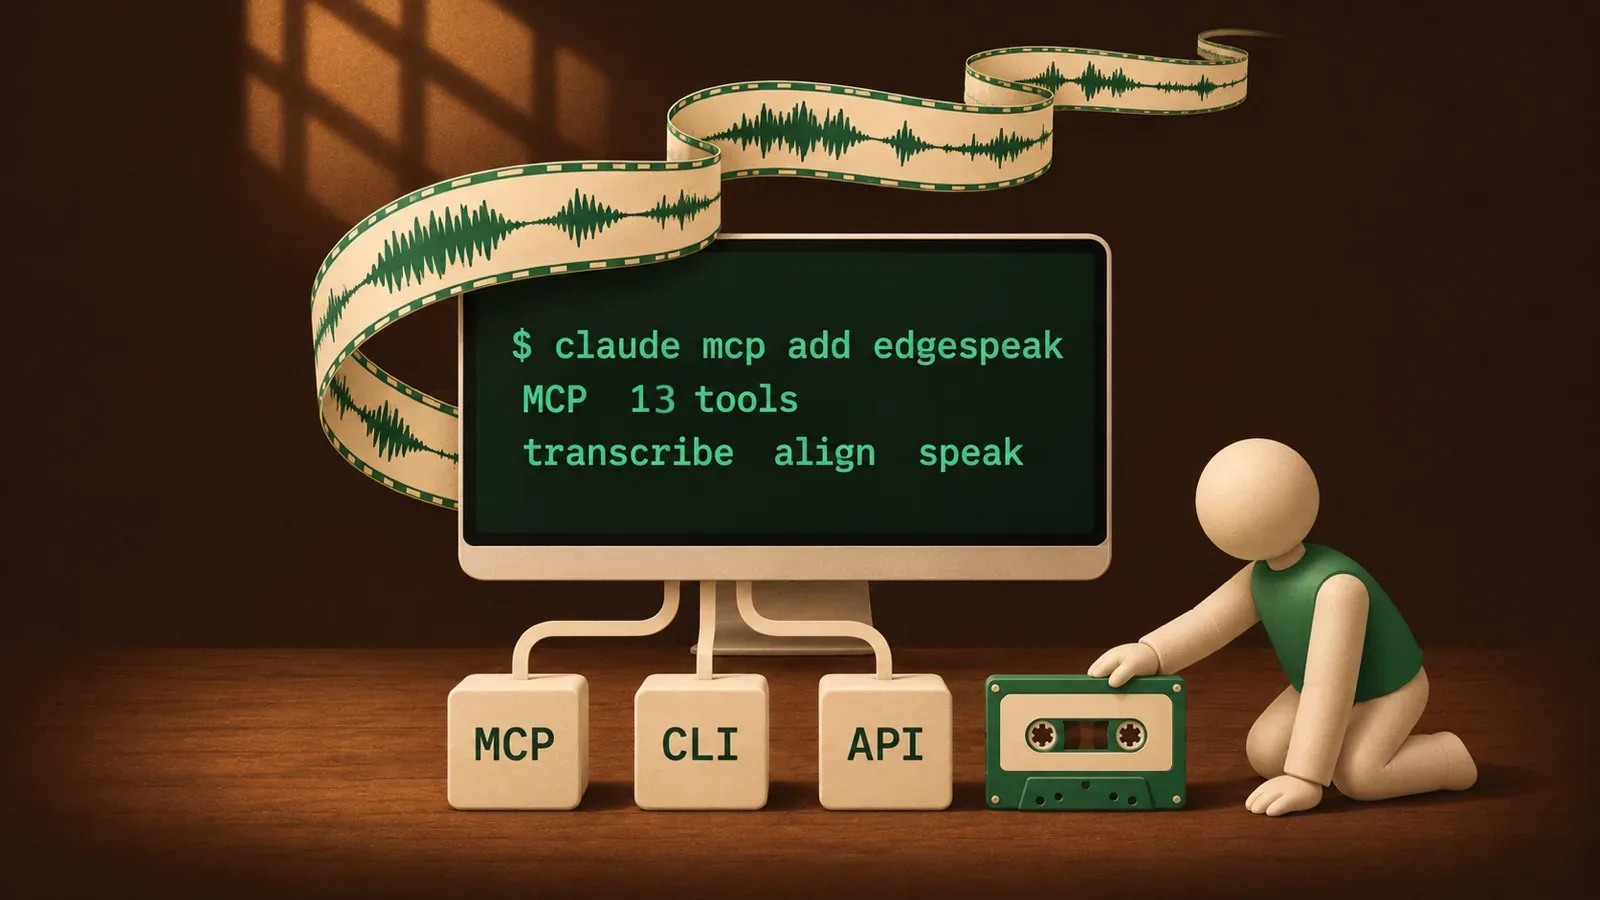
EdgeSpeak fournit 13 outils MCP couvrant la transcription, l’alignement, la séparation des locuteurs, la synthèse vocale et les modèles de langage locaux. Enregistrez-le une fois dans Claude Code ou dans tout agent compatible MCP, puis formulez votre demande en langage naturel : « Transcris tous les enregistrements de réunion de ce dossier et transforme-les en notes organisées par intervenant », ou « Crée des sous-titres mot à mot pour cette vidéo ». Avec l’EdgeSpeak Agent Skill installé, l’agent peut exécuter toute la chaîne : transcription, segmentation en phrases, alignement et export des sous-titres.
Claude Code et EdgeSpeak se complètent aussi pour le montage vidéo : Claude Code sait déjà piloter FFmpeg pour traiter les vidéos, et EdgeSpeak lui permet de comprendre ce qui est dit, avec les instants de début et de fin de chaque mot. Vous pouvez simplement demander : « Coupe les erreurs de parole et toutes les pauses de plus de deux secondes dans cet entretien » ou « Extrais les passages sur les tarifs en clips courts avec des sous-titres mot à mot ». L’agent transcrit et aligne avec EdgeSpeak, puis découpe la vidéo et incruste les sous-titres à partir des horodatages, le tout sur votre ordinateur.
claude mcp add edgespeak -- edgespeak-cli mcpVoir la documentation MCP.
Confidentialité
La transcription, l’alignement, la séparation des locuteurs et la synthèse vocale reposent sur des modèles locaux. Les fichiers audio, les vidéos, les transcriptions et les dictionnaires sont stockés uniquement sur votre appareil et ne sont envoyés à aucun serveur, ce qui convient aux enregistrements de clients, réunions internes, entretiens et autres contenus sensibles. Le réseau sert uniquement à la connexion au compte, à l’activation de la licence et au téléchargement des modèles ; si vous choisissez un modèle cloud pour la conversation vocale, cette partie est traitée par le service correspondant. Voir la politique de confidentialité.
Premiers pas
Installez l’application de bureau depuis la page de téléchargement, connectez-vous et téléchargez les modèles dont vous avez besoin dans l’application. L’offre gratuite permet de l’essayer immédiatement ; vous pouvez aussi acheter une licence à paiement unique pour une utilisation permanente, incluant les futures mises à jour des modèles et des fonctions vocales, sur un maximum de 4 appareils. Consultez la page des tarifs pour connaître les quotas et les prix de chaque offre.