EdgeSpeak: IA de voz en el dispositivo, todo en uno — transcripción, voz, alineación, traducción, música y LLM
Transcripción, texto a voz, alineación, generación musical y traducción, además de separación de hablantes y chat de voz en tiempo real: EdgeSpeak ejecuta todas estas funciones de IA de voz en tu propio dispositivo. La grabación de una presentación de 26 minutos con cuatro participantes que intervienen por turnos se transcribe en 33 segundos en Apple M5, con un pico de memoria de unos 1.0 GB.
La transcripción es solo el comienzo: alineación forzada en 346 idiomas, traducción local a 38 idiomas, 11 modelos de voz y YuE2, que convierte letras en canciones completas con voz y acompañamiento. Sus 13 herramientas MCP permiten que agentes como Claude Code lo utilicen directamente. macOS (Apple Silicon) y Windows cuentan con aplicación de escritorio y CLI; Linux dispone de CLI. Tus archivos de audio y vídeo y tus transcripciones se quedan en tu ordenador.
Precisión, rapidez y bajo consumo
Hemos dedicado mucho trabajo a que los modelos locales sean rápidos y precisos en ordenadores corrientes: los modelos se comprimen y cuantizan hasta un tamaño adecuado para el dispositivo, y el motor de inferencia se acelera por separado para Metal en Apple Silicon, CUDA en GPU NVIDIA y Vulkan en distintas plataformas. Los ordenadores sin GPU dedicada utilizan la CPU.
Estas son las mediciones completas de aquella presentación de 26 minutos en Apple M5:
| Métrica | Resultado |
|---|---|
| Precisión | Tasa de error por palabra (WER) del 6.6% |
| Velocidad de transcripción | 33 segundos, unas 48× más rápido que en tiempo real |
| Velocidad de alineación | Transcripción existente alineada con el audio en 8.8 segundos |
| Memoria | Pico del proceso de transcripción de unos 1.0 GB |
En Windows con una NVIDIA RTX 3060, la transcripción alcanza un factor de tiempo real de aproximadamente 0.04, unas 25× más rápido que en tiempo real. Los ordenadores con menos recursos pueden optar por Lattice-2 Lite, más ligero. Los tiempos varían según el ordenador.
Modelos disponibles
| Función | Modelos |
|---|---|
| Transcripción | Lattice-2 Lite / Flash / Pro, tres variantes según tu equipo y tus necesidades de precisión |
| Alineación forzada | Lattice-2, con cobertura de 346 idiomas |
| Traducción local | Modelos de traducción Lattice-2 Lite / Flash / Pro, 38 idiomas de destino y una API de traducción |
| Chat de voz | Modelos Qwen y Gemma integrados, de 0.6B a 27B; permite importar modelos GGUF compatibles |
| Texto a voz | 11 modelos: Qwen3-TTS (0.6B / 1.7B Base y CustomVoice, además de 1.7B VoiceDesign), FireRedTTS3 (Instruct, Base), OmniVoice, IndexTTS-2.5, VoxCPM2 y Breeze-TTS-2, con reproducción en streaming, clonación de voz y diseño de voces a partir de una descripción |
| Generación musical | YuE2, que convierte letras en canciones completas con voz y acompañamiento, de uso gratuito |
Los modelos se descargan según los necesites desde la aplicación y funcionan sin conexión una vez descargados.
Idiomas
Los modelos de EdgeSpeak son multilingües desde su diseño, más allá del chino y el inglés:
| Función | Cobertura de idiomas |
|---|---|
| Transcripción | Más de 40 idiomas, entre ellos chino, cantonés, inglés, japonés, coreano, árabe, hindi, tailandés, vietnamita y las principales lenguas europeas |
| Alineación forzada | 346 idiomas, incluidos textos que combinan varios idiomas |
| Traducción | 38 idiomas de destino, entre ellos chino tradicional y uigur |
| Texto a voz | OmniVoice cubre todos los idiomas del catálogo y admite otros idiomas ISO 639; FireRedTTS3 admite 24 idiomas y 21 dialectos chinos, como el sichuanés; Qwen3-TTS admite 10 idiomas |
Consulta la guía de idiomas para conocer las funciones disponibles en cada idioma.
Transcripción
Importa audio o vídeo y obtén una transcripción con marcas de tiempo en cualquiera de los más de 40 idiomas disponibles; consulta la lista completa en la guía de idiomas. Exporta texto sin formato, subtítulos SRT o VTT, o JSON. Añade nombres, términos de productos y vocabulario especializado al diccionario para que se reconozcan correctamente y se traduzcan como prefieras. Lattice-2 tiene tres variantes: Lite consume menos memoria y resulta adecuado para portátiles ligeros; Flash es la opción predeterminada y equilibra velocidad y precisión; Pro ofrece mayor precisión que las otras dos. Flash transcribe una grabación en inglés de 111.7 segundos en unos 2.6 segundos. Consulta voz a texto.
Alineación forzada
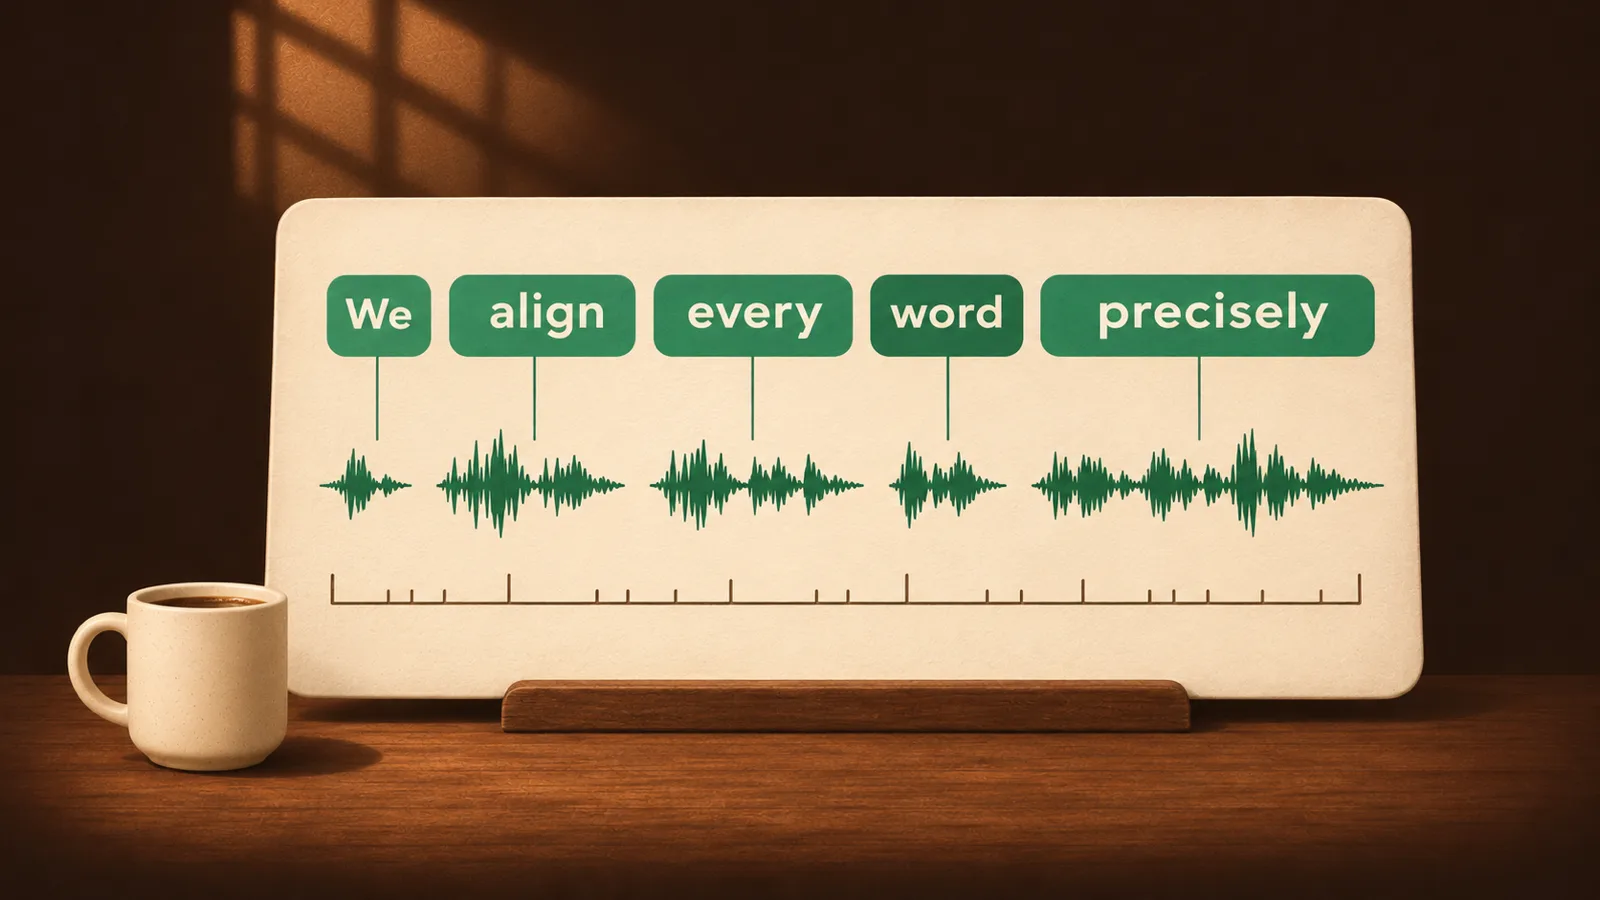
Si ya tienes un guion, las notas de una charla o una letra, puedes alinear el texto directamente con el audio sin volver a transcribir y obtener los tiempos de inicio y fin de cada palabra y frase. La alineación cubre 346 idiomas, incluidos chino, inglés, japonés, coreano, las principales lenguas europeas y muchas lenguas minoritarias. Tiene numerosas aplicaciones: subtítulos con tiempos precisos para vídeos; subtítulos de karaoke que resaltan cada palabra al cantarla o pronunciarla, útiles para vídeos con letras y aprendizaje de idiomas; transcripciones de audiolibros, pódcast y cursos en las que puedes hacer clic para saltar a un punto; y localización rápida de cada frase al editar o doblar. La alineación admite audio y texto de varias horas, por lo que permite alinear una reunión completa o un audiolibro entero de una sola vez.
Alinear es mucho más rápido que volver a transcribir: la alineación por palabras de una grabación en inglés o chino de 20 segundos tarda unos 0.16 segundos; en la presentación de 26 minutos se alinearon las 374 frases en 8.8 segundos, con una mediana de error en el tiempo de inicio de 40 milisegundos. Consulta alineación forzada. El error en los límites de palabra en frases cortas, grabaciones de 60 minutos y en chino, junto con la comparación frente a MFA, ElevenLabs y Qwen3-ForcedAligner, se detalla en la evaluación de alineación forzada y marcas de tiempo por palabra.
Para editar vídeo
Las marcas de tiempo por palabra que generan la transcripción y la alineación son precisamente los datos que necesita la edición de vídeo. Los vídeos de personas hablando a cámara, las entrevistas, los cursos y los pódcast se pueden editar a partir de la transcripción: localiza los errores, las repeticiones y las pausas largas en el texto para saber qué fragmento eliminar; selecciona las citas más interesantes y conviértelas en clips cortos a partir de sus tiempos de inicio y fin. Los subtítulos SRT exportados se importan directamente en Premiere Pro, Final Cut Pro, DaVinci Resolve y otros editores, sin tener que ajustar los tiempos línea por línea.
Separación de hablantes
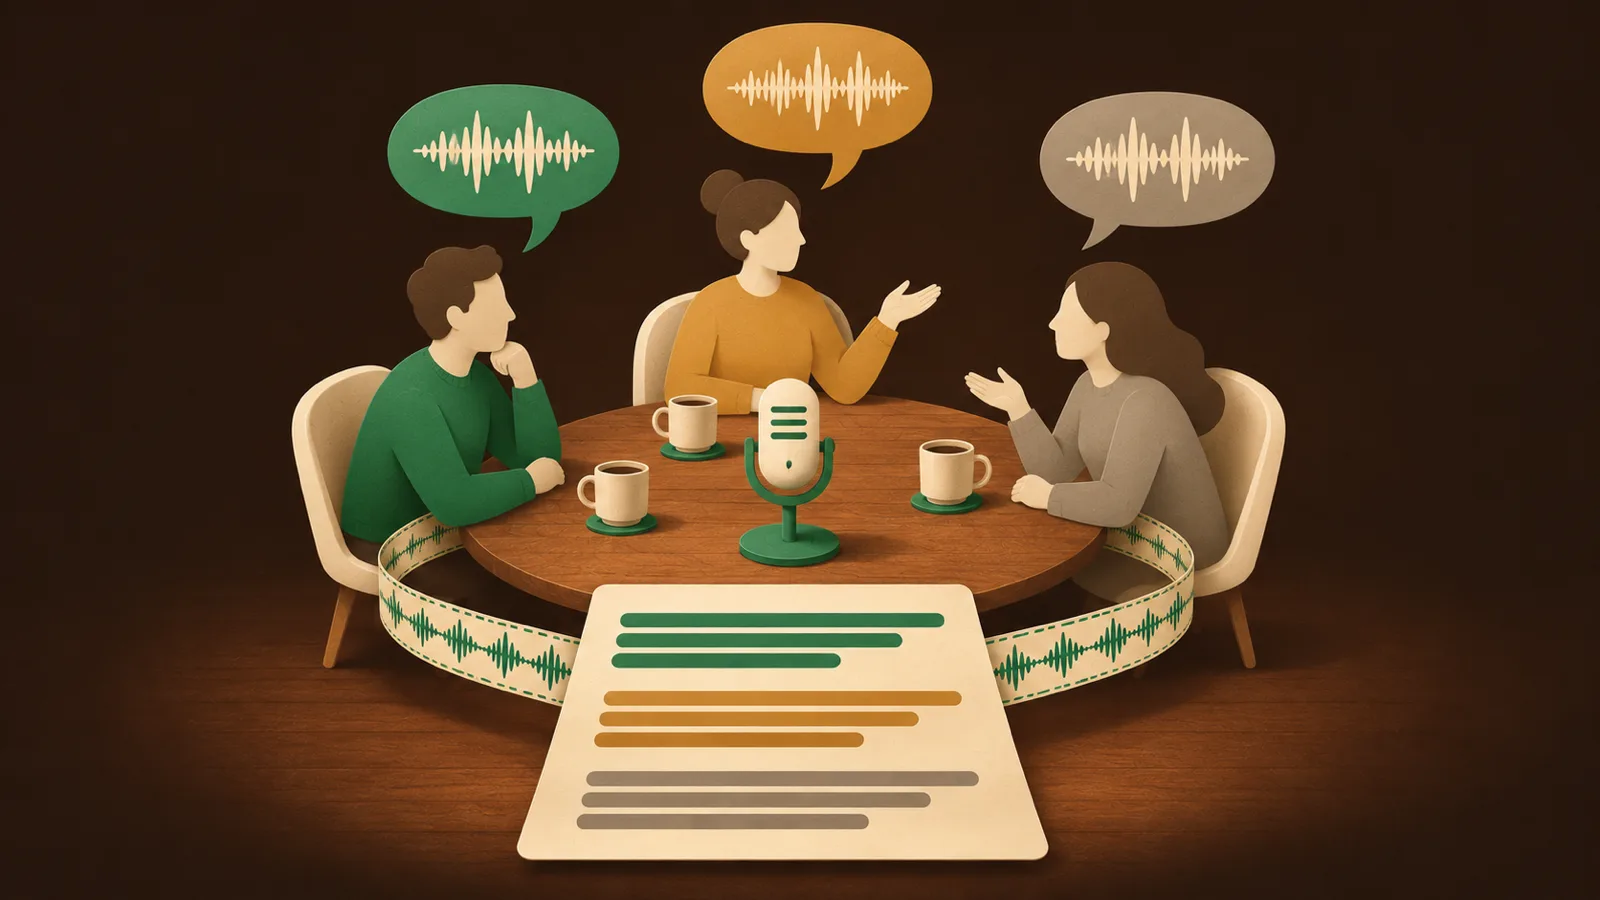
En reuniones, entrevistas y pódcast, la transcripción indica quién ha dicho cada frase y facilita organizar el texto como un diálogo. La separación de hablantes se ejecuta en la misma solicitud que la transcripción y apenas añade espera: en una grabación de 111.7 segundos, las etiquetas de hablante solo añaden unos 0.2 segundos frente a la transcripción básica. Consulta separación de hablantes.
Traducción
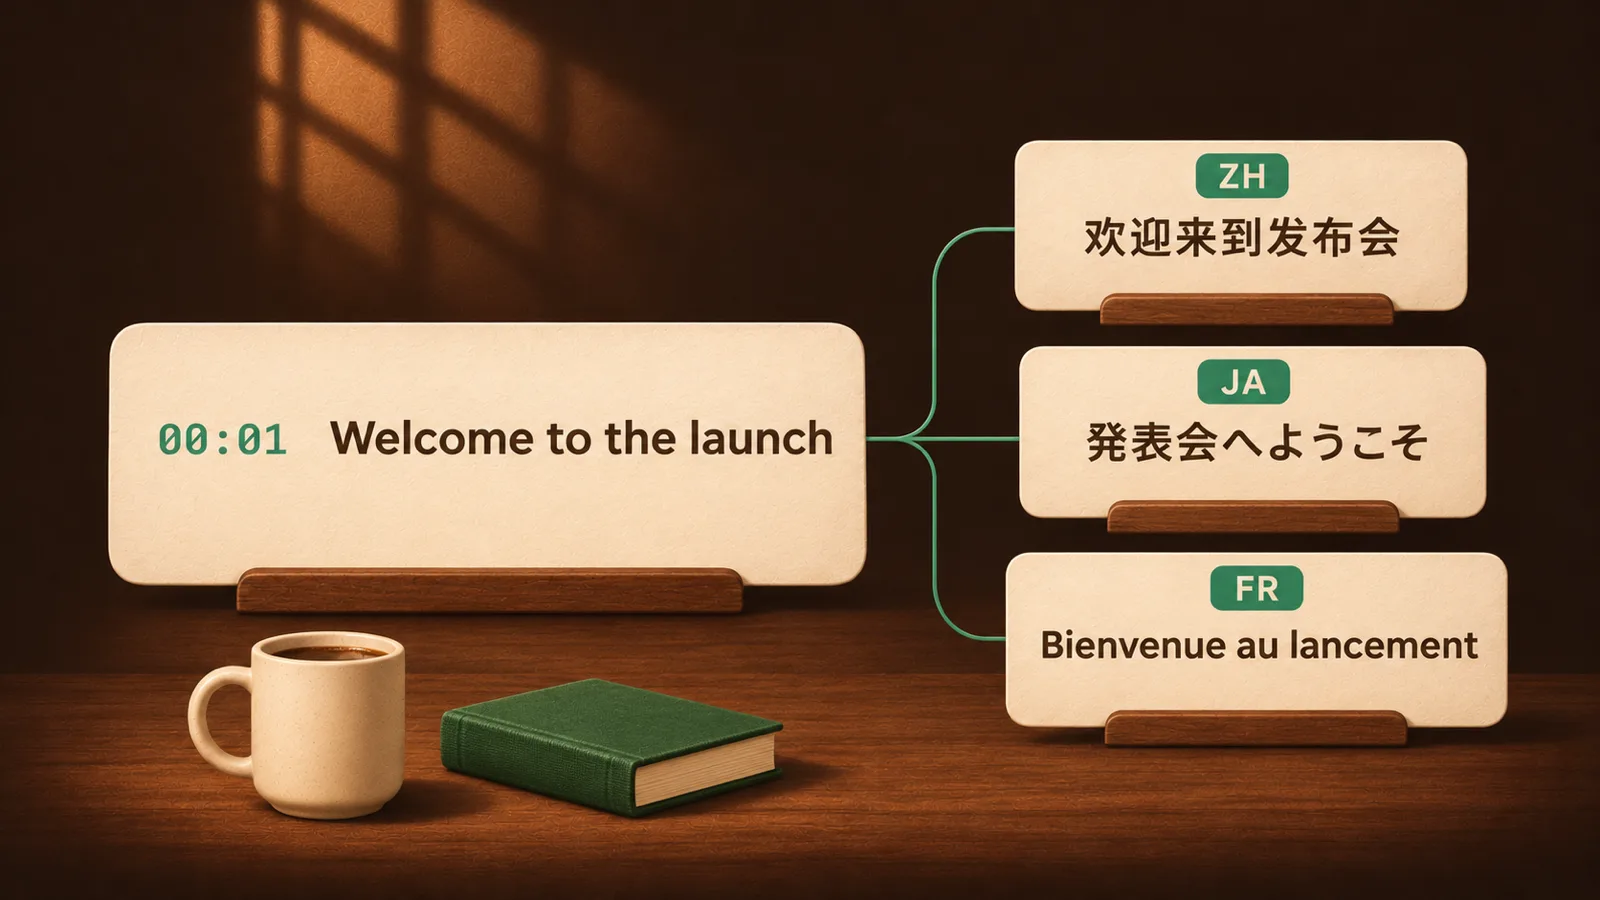
Las transcripciones y los textos alineados se pueden traducir en tu ordenador a 38 idiomas de destino, incluido el chino tradicional. La traducción utiliza modelos locales específicos, Lattice-2 Lite / Flash / Pro, que funcionan sin conexión una vez descargados; se limitan a traducir, sin reescribir ni resumir. Las traducciones conservan la línea de tiempo original, puedes alternar entre las vistas del original, en paralelo y de la traducción, y elegir cómo se presentan el original y la traducción al exportarlos. Entre los usos habituales están crear subtítulos en chino, inglés o bilingües para vídeos y cursos en otros idiomas; traducir transcripciones de reuniones y entrevistas para compañeros que hablan otro idioma; y leer pódcast y presentaciones en otros idiomas en tu propia lengua. Antes de traducir, puedes describir el contenido de la grabación en una o dos frases y elegir un estilo natural, conversacional o fiel; los nombres y los términos de productos de tu diccionario se traducen según lo hayas configurado. Cuando necesites corregir o pulir el texto, puedes recurrir a un servicio comercial de modelos que configures por tu cuenta. Consulta traducir transcripciones en local y cómo redactar las instrucciones de traducción.
La pasarela local también ofrece una API de traducción: añade un parámetro translation a una solicitud de Chat Completions o Responses con el idioma de destino y el estilo, y el modelo de traducción local se encargará de procesarla. Las herramientas MCP y la interpretación simultánea de Realtime utilizan el mismo formato. Consulta la documentación de la API de traducción.
{
  "model": "EdgeSpeak/Lattice-2-Flash",
  "input": "Te damos la bienvenida a la presentación de hoy.",
  "translation": { "target_language": "ja", "style": "natural" }
}
Comprensión y chat de voz
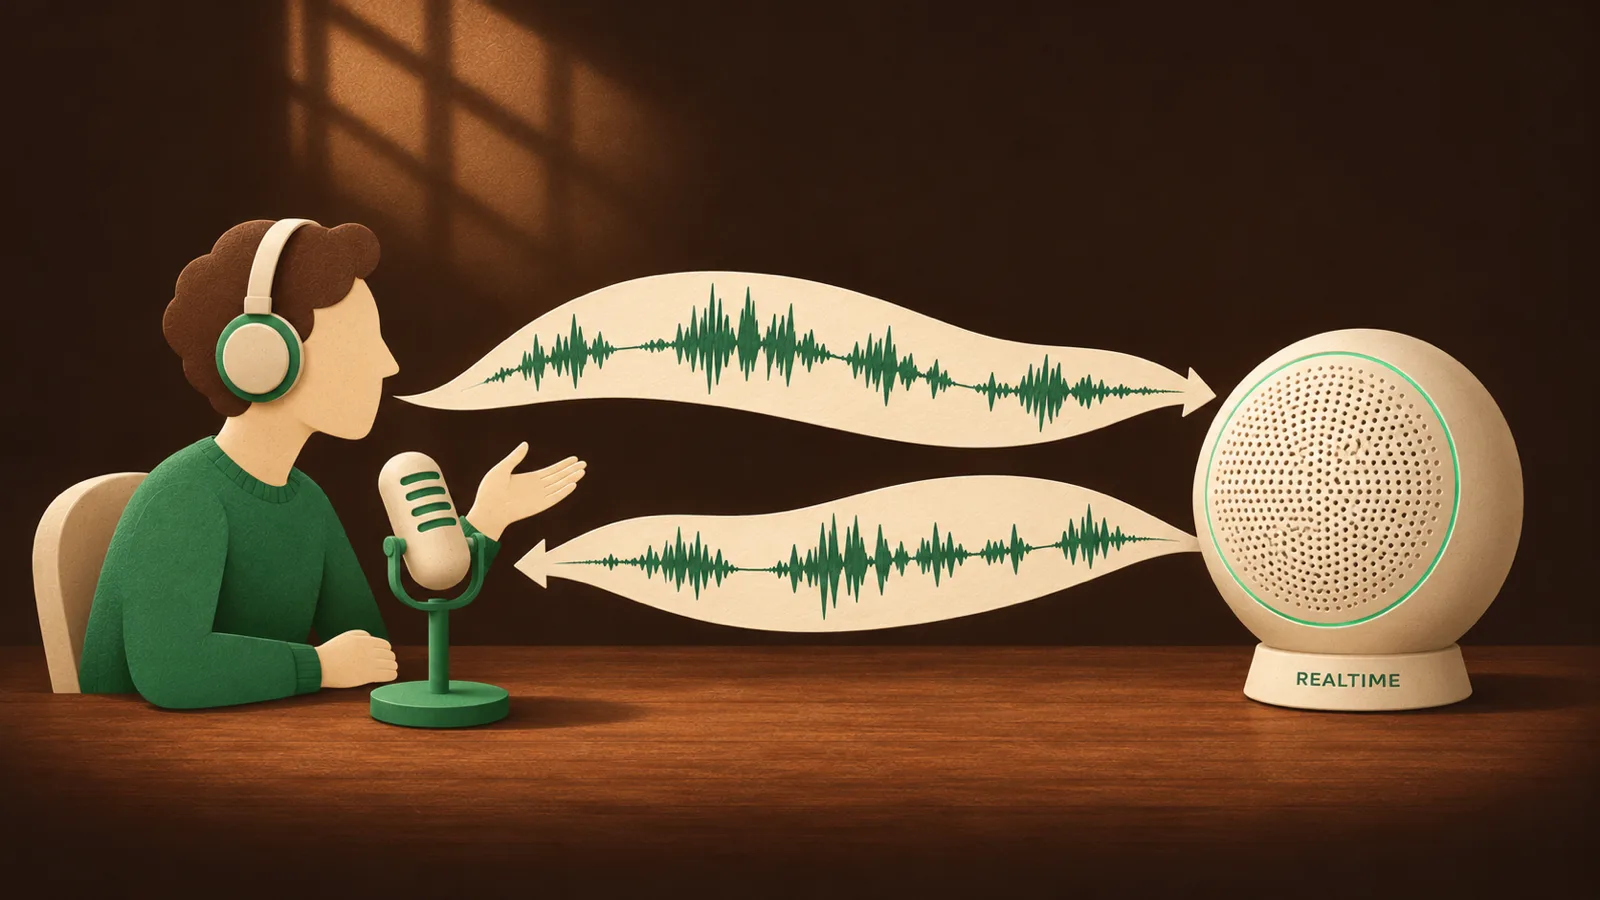
Habla por el micrófono y el modelo de IA te entiende y responde con voz. Elige un perfil, como compañero de práctica de idiomas o un personaje; con el compañero de idiomas podrías decir: «Haz de barista de una cafetería y ayúdame a practicar cómo pedir en español». Cambia a interpretación simultánea para hablar en un idioma y escuchar otro.
Los desarrolladores pueden crear sus propias aplicaciones de voz con estas mismas funciones: la pasarela local ofrece una Realtime API (WebSocket) con conversación de voz en tiempo real y posibilidad de interrumpir, o solo transcripción en tiempo real. El modelo de lenguaje de la conversación puede ir de 0.6B a 27B para adaptarse a tu ordenador; en Windows con una RTX 3060 y Vulkan, la generación alcanza unos 173 tokens por segundo. Consulta chat de voz y la documentación de Realtime API.
Texto a voz y generación musical
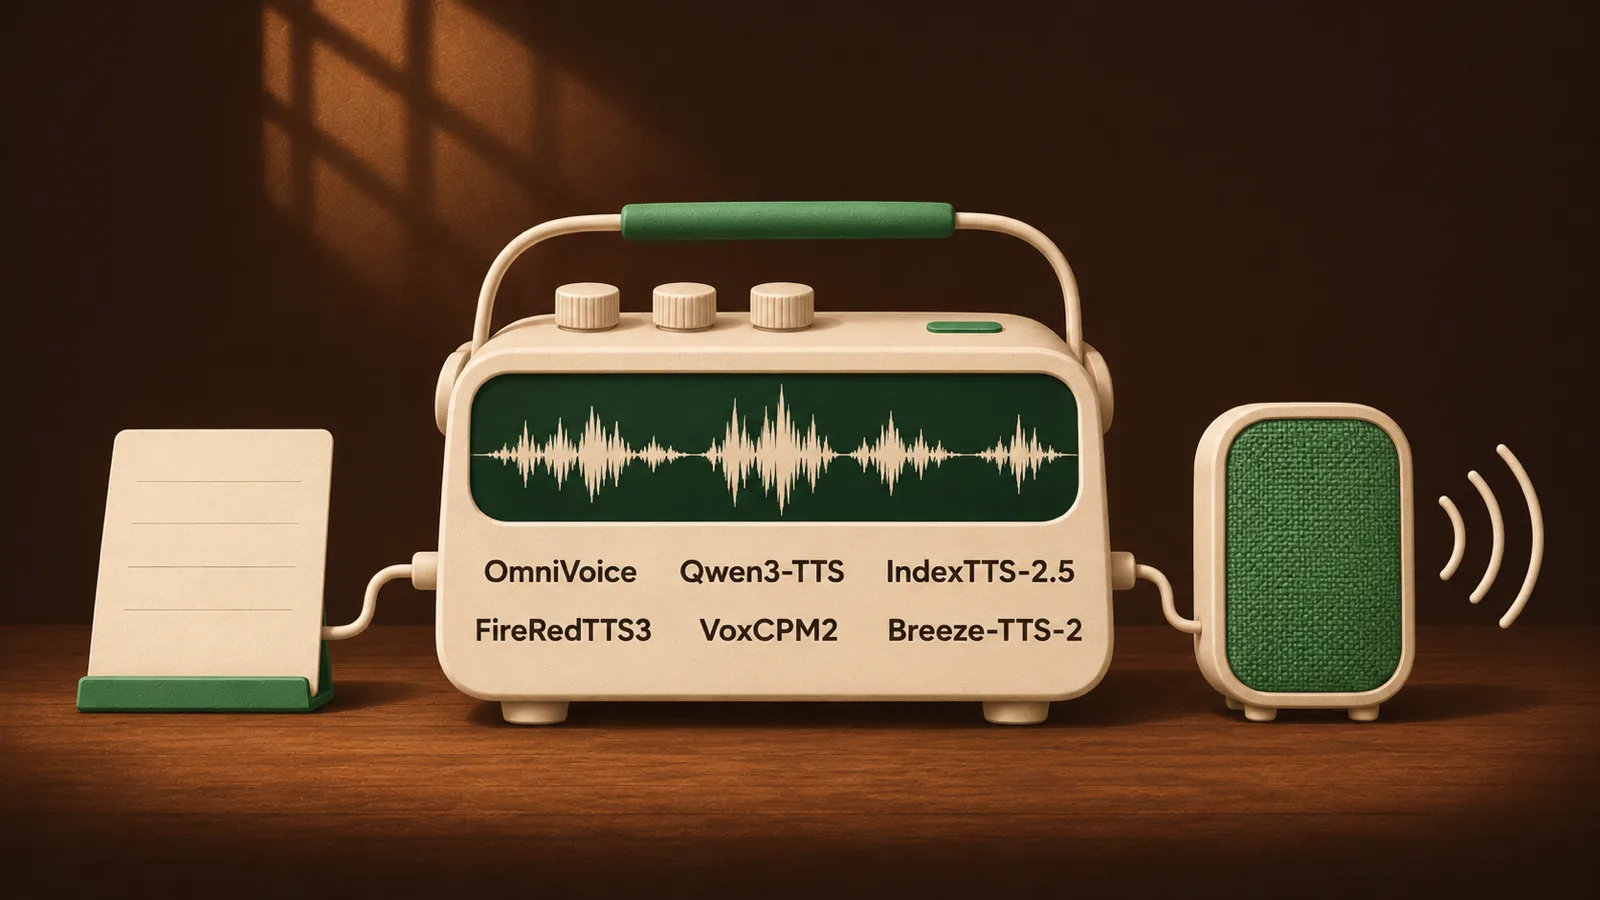
Escribe texto y genera voz que se reproduce mientras se va creando, o expórtala como WAV. EdgeSpeak admite 11 modelos actuales de voz de código abierto de seis familias —Qwen3-TTS, FireRedTTS3, OmniVoice, IndexTTS-2.5, VoxCPM2 y Breeze-TTS-2—, cada una con sus puntos fuertes, para que elijas según el idioma, la voz y la velocidad; seguimos incorporando nuevos modelos destacados a medida que aparecen. Además de las voces integradas, los modelos compatibles permiten crear tu propia voz a partir de una grabación de referencia clara, o diseñar una voz a partir de una descripción de texto.
La generación de voz también funciona en streaming y está acelerada: en Apple M5 Ultra, Qwen3-TTS 0.6B empieza a producir sonido para un pasaje en inglés de 31 palabras en unos 60 a 90 milisegundos y completa unos 11 segundos de audio en aproximadamente 2.1 segundos; en una GPU NVIDIA, FireRedTTS3 tarda aproximadamente 0.26× la duración del audio. Consulta texto a voz.
Canciones a partir de letras
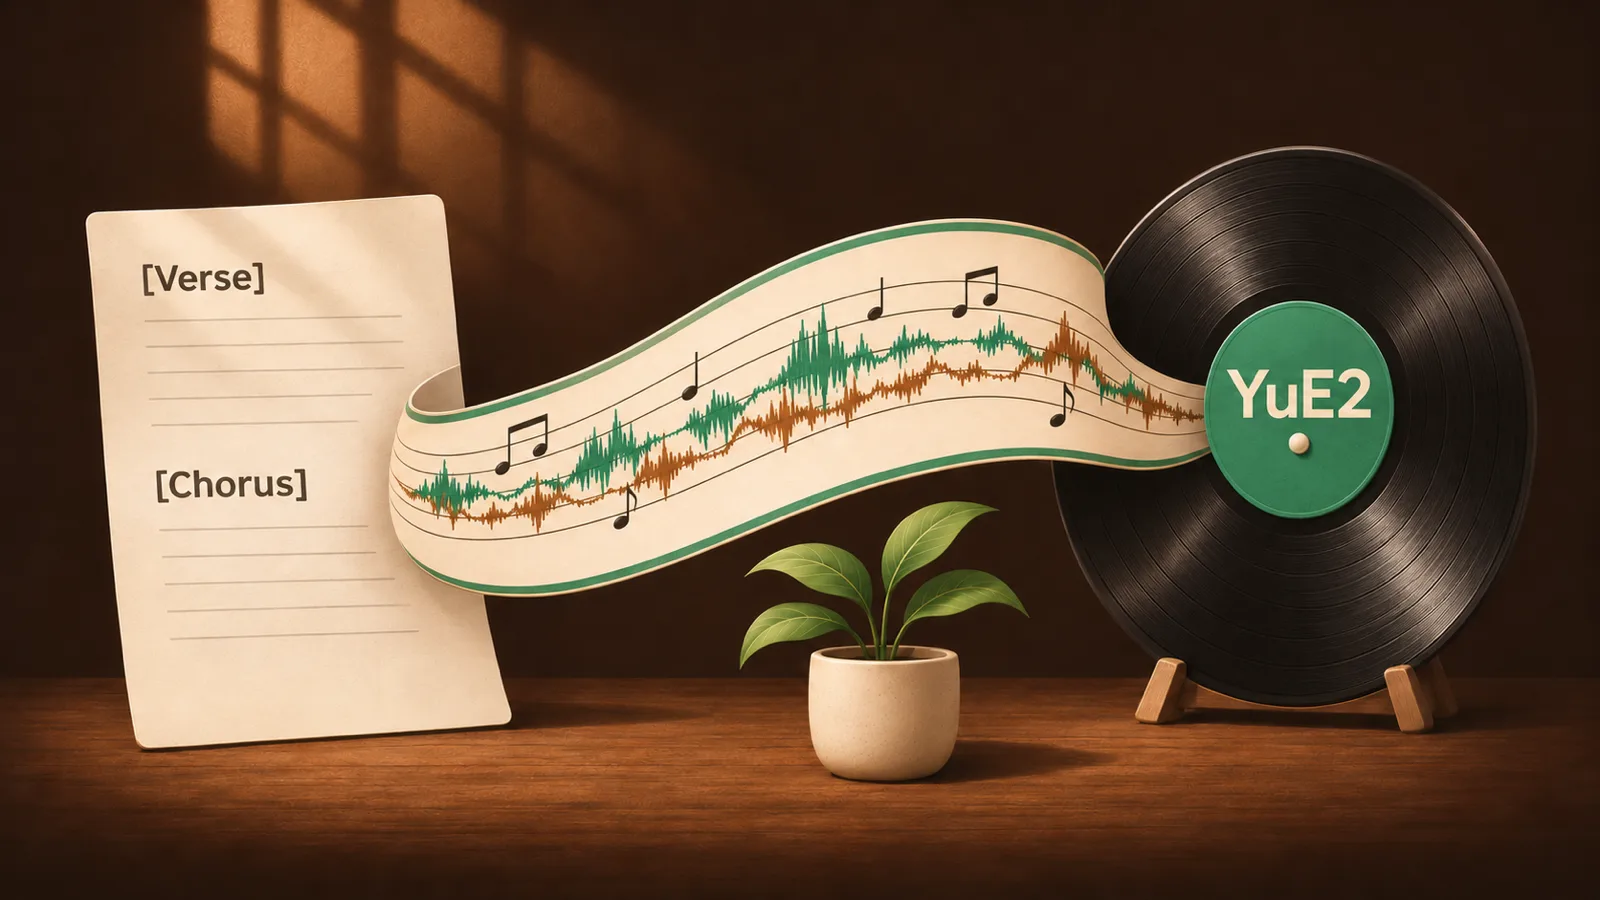
La página de texto a voz también incluye el modelo musical YuE2. Escribe una letra con etiquetas de sección como [Verse] y [Chorus], describe el género, la voz y los instrumentos en una frase, y generará una canción completa con voz y acompañamiento en tu ordenador, en audio estéreo de 48 kHz. Puedes pedir al modelo que planifique una partitura antes, revisarla y editarla antes de generar la canción, o pegar tu propia notación ABC. Generar canciones con YuE2 es gratis y no consume tu cuota.
Hemos incorporado a YuE2 un nuevo método de muestreo, AB3: 14 pasos de forma predeterminada y solo 15 evaluaciones del modelo, con un audio casi idéntico a la referencia de 32 pasos (SNR de unos 29 dB). En Apple Silicon, la etapa de generación y decodificación del sonido pasó de tardar aproximadamente 1.5× la duración de la canción a unas 0.67×, cerca del tiempo real (sin contar la planificación inicial de la melodía ni la carga del modelo). En una NVIDIA RTX 4090, una canción de 22.3 segundos se genera en unos 9.1 segundos. Los pesos de YuE2 conservan la licencia CC BY-NC 4.0 de sus autores originales y solo se pueden usar con fines no comerciales.
La canción que aparece a continuación se generó con YuE2 en un ordenador local. Después usamos la alineación forzada de EdgeSpeak para alinear la letra con la voz, obtener los tiempos de inicio y fin de cada palabra, exportar subtítulos de karaoke palabra por palabra e incrustarlos en el vídeo. El espectro y la onda se mueven con la música, y la zona del título muestra los ajustes del modelo utilizados en esta ejecución. La generación, la alineación y los subtítulos se hicieron en el mismo ordenador.
Pasarela local: funciones completas de voz y texto
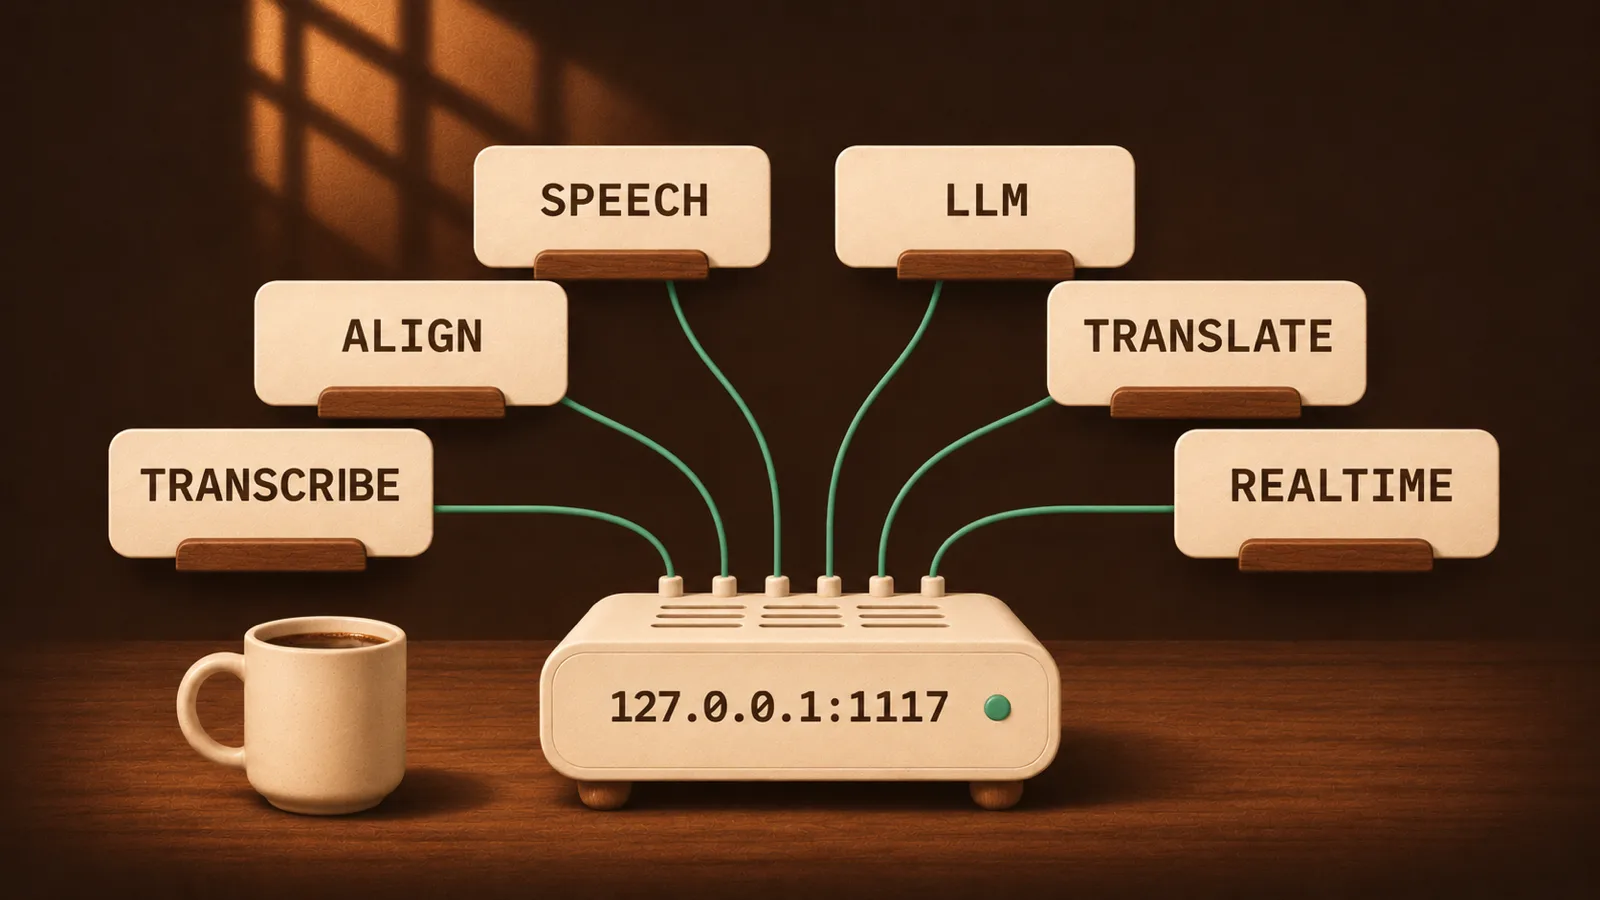
Al abrir la aplicación de escritorio, la pasarela local se ejecuta en http://127.0.0.1:1117/v1; también puedes iniciarla por separado con edgespeak-cli serve, sin necesidad de la aplicación de escritorio. La pasarela sigue las convenciones de la API de OpenAI y reúne la transcripción, la alineación, el texto a voz, los LLM, la traducción y la voz en tiempo real en una misma dirección:
| Función | Endpoints |
|---|---|
| Transcripción, separación de hablantes | /v1/audio/transcriptions, /v1/speaker/diarizations |
| Alineación forzada | /v1/audio/alignments |
| Texto a voz, creación de voces | /v1/audio/speech, /v1/audio/voices |
| Chat con LLM, traducción, visión | /v1/responses, /v1/chat/completions, /v1/messages |
| Chat de voz en tiempo real | /v1/realtime (WebSocket) |
| Herramientas para agentes | /mcp |
Estas funciones suelen exigir registrarse en varios servicios en la nube y pagar por cada uno. Con la pasarela local, las funciones básicas de voz y LLM están en tu ordenador, por lo que no necesitas contratar servicios API independientes para ellas; el código existente que utiliza el SDK de OpenAI funciona al apuntar la URL base a tu equipo. Para dar servicio a otros equipos de confianza de tu red, inicia el servicio sin interfaz gráfica. Para saber qué cubre la pasarela y cómo elegir entre sus dos modos de ejecución, consulta la guía de la pasarela de voz local; los detalles de cada endpoint están en la documentación de la API.
Uso con agentes de IA
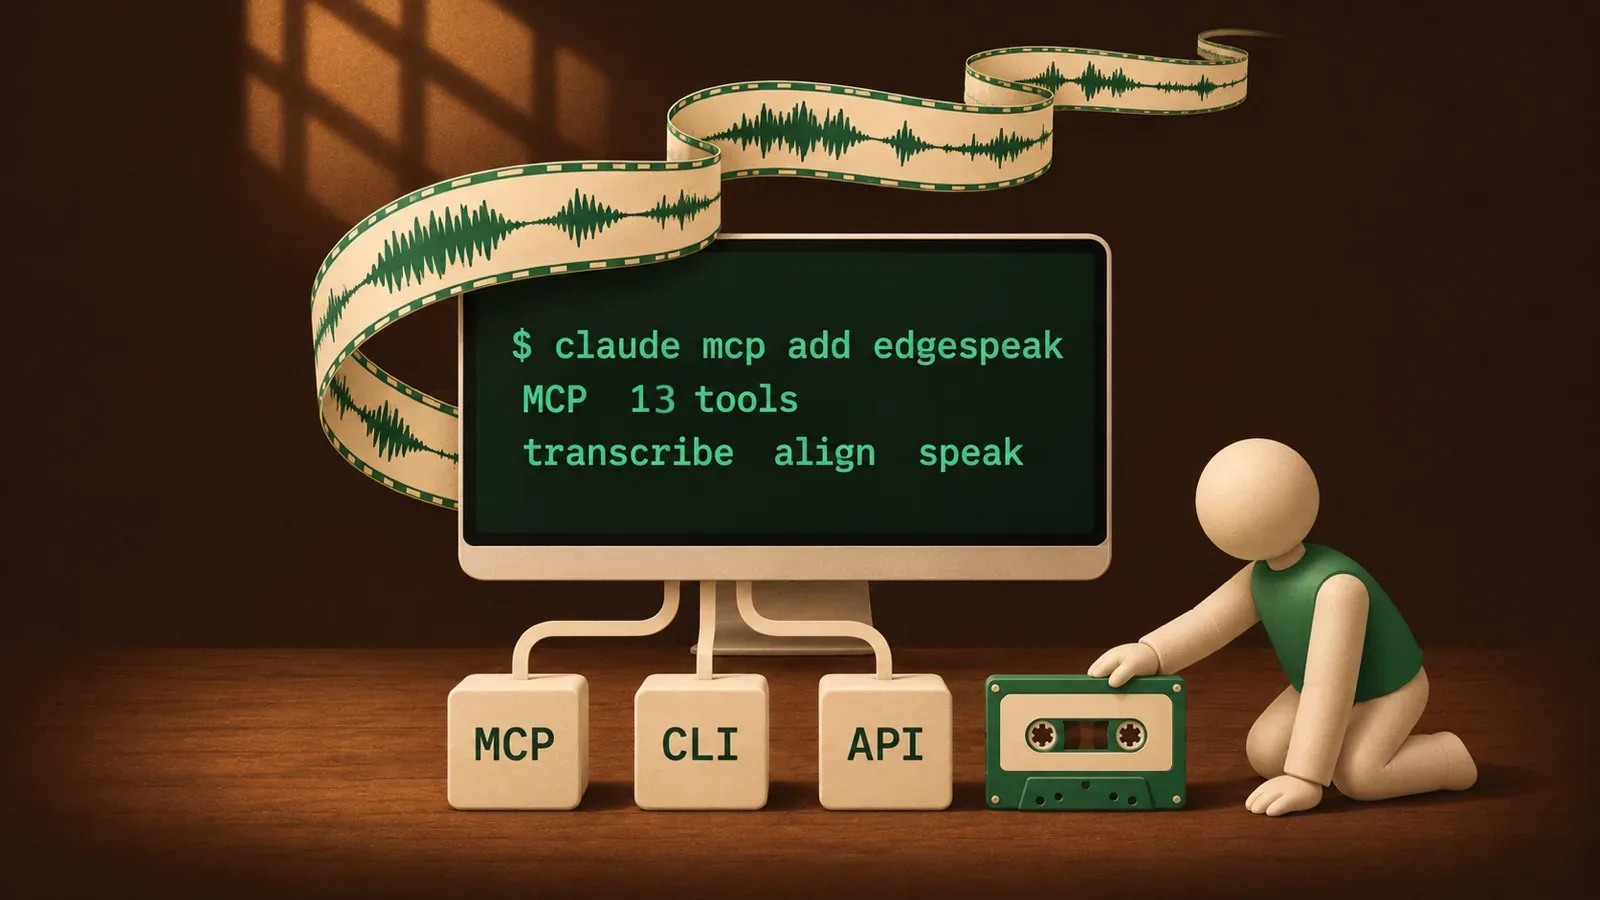
EdgeSpeak ofrece 13 herramientas MCP para transcripción, alineación, separación de hablantes, texto a voz y modelos de lenguaje locales. Regístralo una vez en Claude Code o en cualquier agente compatible con MCP y pídele en lenguaje natural: «Transcribe todas las grabaciones de reuniones de esta carpeta y conviértelas en notas organizadas por hablante» o «Crea subtítulos palabra por palabra para este vídeo». Con EdgeSpeak Agent Skill instalado, el agente puede ejecutar el proceso completo de transcripción, segmentación en frases, alineación y exportación de subtítulos.
Claude Code y EdgeSpeak también se complementan para editar vídeo: Claude Code ya utiliza FFmpeg para procesar vídeos, y EdgeSpeak añade la capacidad de entender lo que se dice, con los tiempos de inicio y fin de cada palabra. Basta con decir «Elimina los errores al hablar y todas las pausas de más de dos segundos de esta entrevista» o «Extrae las partes sobre precios en clips cortos con subtítulos palabra por palabra». El agente transcribe y alinea con EdgeSpeak, y después recorta e incrusta los subtítulos según las marcas de tiempo, todo en tu ordenador.
claude mcp add edgespeak -- edgespeak-cli mcpConsulta la documentación de MCP.
Privacidad
La transcripción, la alineación, la separación de hablantes y el texto a voz se ejecutan con modelos locales. El audio, el vídeo, las transcripciones y los diccionarios se almacenan solo en tu dispositivo y no se suben a ningún servidor, lo que resulta adecuado para grabaciones de clientes, reuniones internas, entrevistas y otros materiales sensibles. La red solo se utiliza para iniciar sesión, activar la licencia y descargar modelos; si eliges un modelo en la nube para el chat de voz, esa parte la procesa el servicio correspondiente. Consulta la política de privacidad.
Primeros pasos
Instala la aplicación de escritorio desde la página de descargas, inicia sesión y descarga los modelos que necesites desde la aplicación. El plan gratuito permite probarla de inmediato; también puedes comprar una licencia de pago único para usarla de forma permanente, con futuras actualizaciones de modelos y funciones de voz incluidas, en hasta 4 dispositivos. Consulta la página de precios para conocer la cuota y el precio de cada plan.