EdgeSpeak: 온디바이스 음성 AI 올인원 — 전사, 음성 출력, 정렬, 번역, 음악, LLM
전사, 음성 출력(TTS), 정렬, 음악 생성, 번역부터 화자 분리와 실시간 음성 대화까지. EdgeSpeak는 음성 AI에 필요한 기능을 내 기기에서 실행합니다. 4명이 번갈아 발언하는 26분 분량의 발표 행사 녹음을 Apple M5에서 33초 만에 전사하며, 최대 메모리 사용량은 약 1.0 GB입니다.
전사는 시작일 뿐입니다. 346개 언어의 강제 정렬, 38개 언어로의 온디바이스 번역, 11개 음성 출력 모델을 지원하며, YuE2는 가사로 보컬과 반주를 갖춘 완성곡을 만듭니다. 13개 MCP 도구를 통해 Claude Code 같은 에이전트가 직접 호출할 수도 있습니다. macOS(Apple Silicon)와 Windows에는 데스크톱 앱과 CLI를, Linux에는 CLI를 제공하며, 오디오와 비디오, 전사문은 내 컴퓨터에 보관됩니다.
정확하고 빠르게, 메모리 부담은 가볍게
일반적인 컴퓨터에서도 로컬 모델을 빠르고 정확하게 실행할 수 있도록 많은 최적화를 거쳤습니다. 모델을 기기에 맞는 크기로 압축·양자화하고, 추론 엔진은 Apple Silicon의 Metal, NVIDIA GPU의 CUDA, 여러 플랫폼에서 사용할 수 있는 Vulkan에 맞춰 각각 가속했습니다. 외장 GPU가 없는 컴퓨터에서는 CPU로 실행할 수 있습니다.
앞서 소개한 26분 발표 행사 녹음을 Apple M5에서 측정한 결과입니다.
| 항목 | 결과 |
|---|---|
| 정확도 | 단어 오류율(WER) 6.6% |
| 전사 속도 | 33초, 실시간 대비 약 48× 속도 |
| 정렬 속도 | 기존 전사문을 오디오에 정렬하는 데 8.8초 |
| 메모리 | 전사 프로세스의 최대 사용량 약 1.0 GB |
NVIDIA RTX 3060을 탑재한 Windows에서는 전사의 실시간 계수가 약 0.04로, 실시간 대비 약 25× 속도를 냅니다. 사양이 낮은 컴퓨터에서는 더 가벼운 Lattice-2 Lite를 선택할 수 있습니다. 처리 시간은 컴퓨터에 따라 달라집니다.
모델 구성
| 기능 | 모델 |
|---|---|
| 전사 | Lattice-2 Lite / Flash / Pro, 하드웨어와 정확도 요구에 따라 선택하는 세 가지 등급 |
| 강제 정렬 | Lattice-2, 346개 언어 지원 |
| 온디바이스 번역 | Lattice-2 Lite / Flash / Pro 번역 모델, 38개 목표 언어 지원 및 번역 API 제공 |
| 음성 대화 | 0.6B부터 27B까지의 Qwen 및 Gemma 모델 내장, 호환되는 GGUF 모델 가져오기 지원 |
| 음성 출력(TTS) | 11개 모델: Qwen3-TTS(0.6B / 1.7B Base 및 CustomVoice, 1.7B VoiceDesign), FireRedTTS3(Instruct, Base), OmniVoice, IndexTTS-2.5, VoxCPM2, Breeze-TTS-2. 스트리밍 재생, 음성 복제, 설명에 따른 음성 디자인 지원 |
| 음악 생성 | YuE2, 가사로 보컬과 반주가 있는 완성곡 생성, 무료 사용 |
모델은 앱에서 필요할 때 내려받으며, 다운로드 후에는 오프라인으로 사용할 수 있습니다.
지원 언어
EdgeSpeak의 모델은 처음부터 다국어를 지원하도록 설계되어 중국어와 영어 외에도 다양한 언어를 처리합니다.
| 기능 | 지원 언어 범위 |
|---|---|
| 전사 | 중국어, 광둥어, 영어, 일본어, 한국어, 아랍어, 힌디어, 태국어, 베트남어, 주요 유럽 언어 등 40개 이상 언어 |
| 강제 정렬 | 여러 언어가 섞인 텍스트를 포함해 346개 언어 |
| 번역 | 중국어 번체와 위구르어를 포함한 38개 목표 언어 |
| 음성 출력(TTS) | OmniVoice는 언어 목록의 모든 언어와 그 밖의 ISO 639 언어도 입력받습니다. FireRedTTS3는 24개 언어와 쓰촨어 등 21개 중국어 방언을, Qwen3-TTS는 10개 언어를 지원합니다. |
언어별로 지원하는 기능은 언어 가이드에서 확인할 수 있습니다.
전사
오디오나 비디오를 가져오면 40개 이상 언어로 타임스탬프가 포함된 전사문을 만들 수 있습니다. 전체 지원 목록은 언어 가이드를 참고하세요. 일반 텍스트, SRT, VTT 자막 또는 JSON으로 내보낼 수 있습니다. 이름, 제품명, 전문 용어를 사전에 추가하면 정확하게 인식하고 번역도 지정한 표기에 맞출 수 있습니다. Lattice-2는 세 가지 등급으로 제공됩니다. Lite는 메모리 사용량이 적어 경량 노트북에 적합하고, 기본 모델인 Flash는 속도와 정확도의 균형을 맞췄으며, Pro는 세 모델 중 정확도가 가장 높습니다. Flash는 111.7초 분량의 영어 녹음을 약 2.6초 만에 전사합니다. 자세한 내용은 음성을 텍스트로 변환을 참고하세요.
강제 정렬
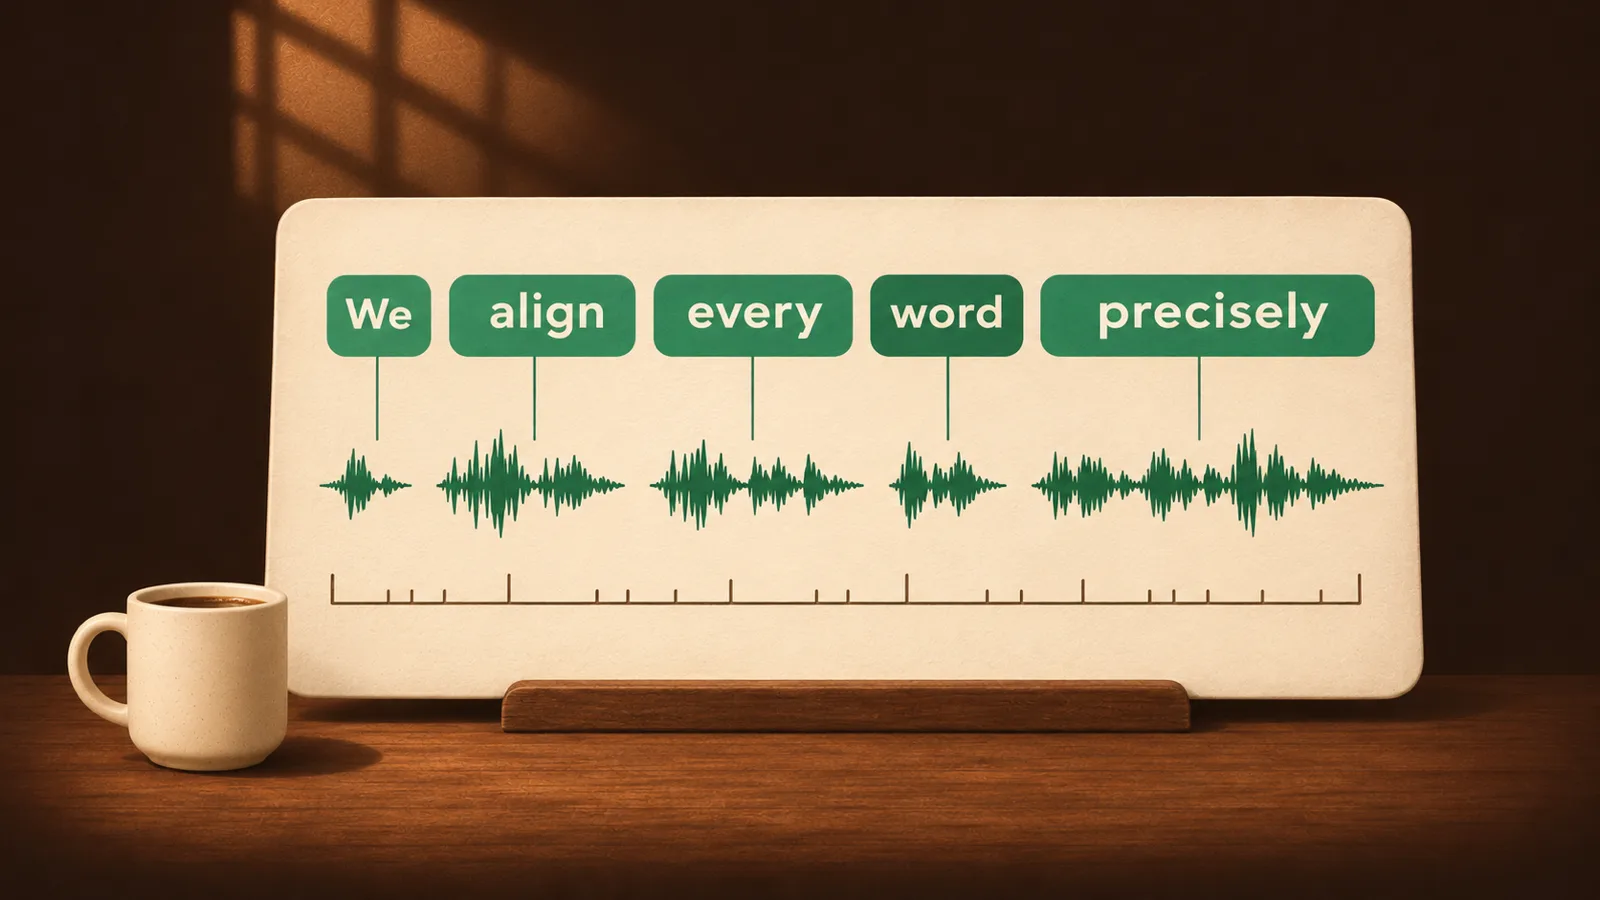
대본, 발표 원고, 가사가 이미 있다면 다시 전사할 필요 없이 텍스트를 오디오에 바로 정렬해 단어와 문장의 시작·종료 시간을 얻을 수 있습니다. 중국어, 영어, 일본어, 한국어, 주요 유럽 언어와 여러 소수 언어를 포함해 346개 언어를 지원합니다. 활용 범위도 넓습니다. 영상에 정확한 타이밍의 자막을 넣거나, 노래와 말소리에 맞춰 단어마다 강조되는 노래방 자막을 만들어 가사 영상과 언어 학습에 활용할 수 있습니다. 오디오북, 팟캐스트, 강의에는 클릭하면 해당 구간으로 이동하는 전사문을 붙이고, 편집이나 더빙 중에는 원하는 대사를 빠르게 찾을 수 있습니다. 수 시간 분량의 오디오와 텍스트도 처리하므로 회의 전체나 오디오북 한 권을 한 번에 정렬할 수 있습니다.
정렬은 다시 전사하는 것보다 훨씬 빠릅니다. 20초 분량의 영어 또는 중국어 녹음을 단어 단위로 정렬하는 데 약 0.16초가 걸립니다. 26분 발표 행사 녹음에서는 374개 문장 전체를 8.8초 만에 정렬했고, 시작 시간 오차의 중앙값은 40밀리초였습니다. 자세한 내용은 강제 정렬을 참고하세요. 짧은 문장, 60분 녹음, 중국어에서의 단어 경계 오차와 MFA, ElevenLabs, Qwen3-ForcedAligner와의 비교는 강제 정렬 단어 타임스탬프 벤치마크에 정리했습니다.
영상 편집에 활용하기
전사와 정렬에서 얻은 단어별 타임스탬프는 영상 편집에 필요한 데이터이기도 합니다. 말하는 사람이 중심인 영상, 인터뷰, 강의, 팟캐스트를 전사문을 보며 편집할 수 있습니다. 텍스트에서 말실수, 반복, 긴 침묵을 찾으면 어느 구간을 잘라야 할지 알 수 있고, 인상적인 발언을 골라 시작·종료 시간에 맞춰 짧은 클립으로 만들 수도 있습니다. 내보낸 SRT 자막은 Premiere Pro, Final Cut Pro, DaVinci Resolve 등 편집기에 바로 가져올 수 있어 자막 시간을 한 줄씩 맞출 필요가 없습니다.
화자 분리
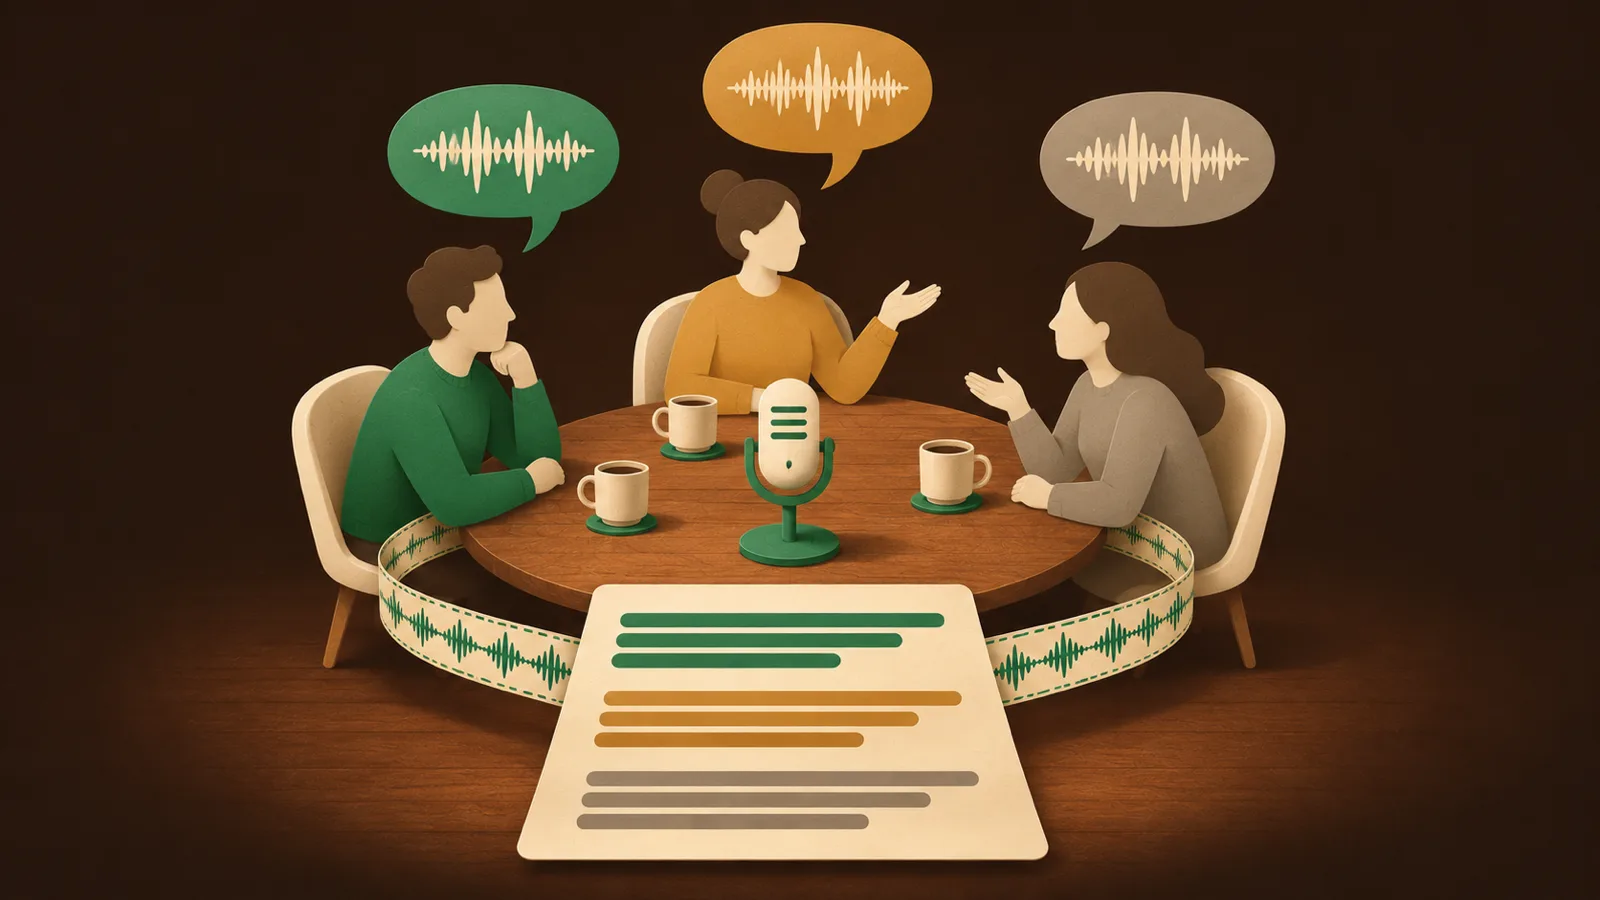
회의, 인터뷰, 팟캐스트의 전사문에 각 발언의 화자를 표시해 대화록으로 정리하기 쉽게 만듭니다. 화자 분리는 전사와 같은 요청에서 처리하며 대기 시간도 거의 늘어나지 않습니다. 111.7초 녹음에서 화자 표시에 추가로 걸리는 시간은 일반 전사보다 약 0.2초입니다. 자세한 내용은 화자 분리를 참고하세요.
번역
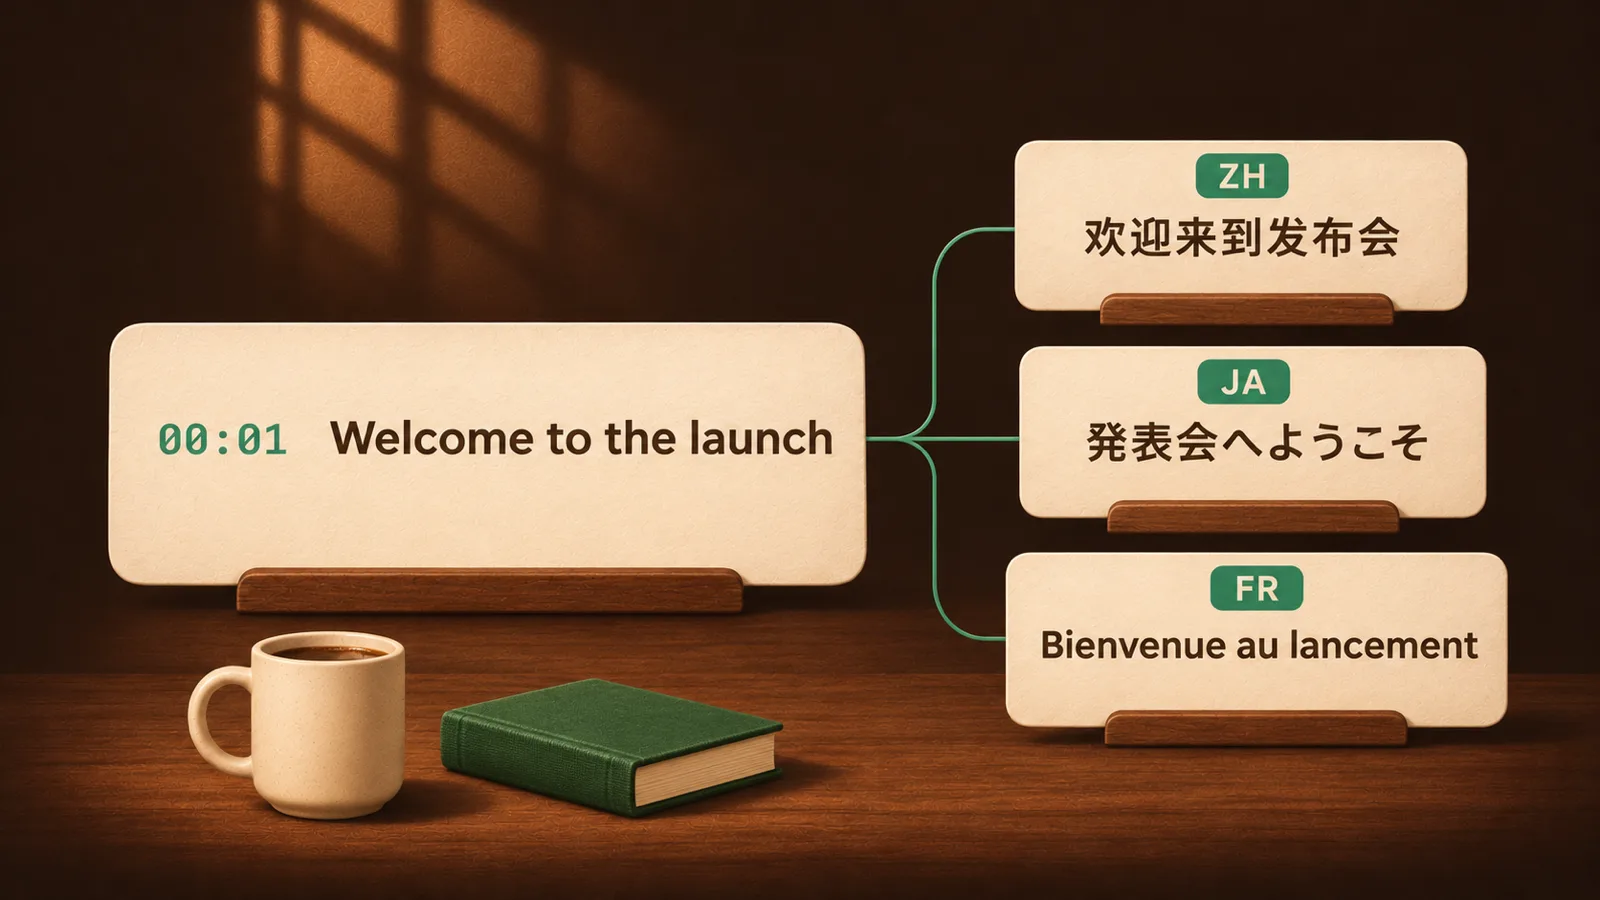
전사문과 정렬 결과를 내 컴퓨터에서 중국어 번체를 포함한 38개 목표 언어로 번역할 수 있습니다. 전용 온디바이스 번역 모델인 Lattice-2 Lite / Flash / Pro를 사용하며, 다운로드 후에는 오프라인으로 작동합니다. 이 모델은 번역만 수행하며 내용을 다시 쓰거나 요약하지 않습니다. 번역문은 원문의 타임라인을 유지합니다. 원문, 대조, 번역문 보기 사이를 전환하고 내보낼 때 원문과 번역문의 배치를 선택할 수 있습니다. 외국어 영상이나 강의에 중국어·영어·이중 언어 자막을 만들거나, 회의·인터뷰 전사문을 다른 언어를 쓰는 동료에게 전달하거나, 외국어 팟캐스트와 발표 행사를 모국어로 읽는 데 활용할 수 있습니다. 번역 전에 녹음 내용을 한두 문장으로 설명하고 자연스러운 문체, 구어체, 원문에 충실한 문체 중에서 고를 수 있습니다. 사전에 등록한 이름과 제품명은 지정한 표기에 맞춰 번역합니다. 교정이나 문장 다듬기가 필요하면 직접 설정한 상용 모델 서비스로 전환할 수도 있습니다. 로컬에서 전사문 번역하기와 번역 요구사항 작성하기를 참고하세요.
로컬 게이트웨이는 번역 API도 제공합니다. Chat Completions 또는 Responses 요청에 목표 언어와 문체를 담은 translation 매개변수를 추가하면 온디바이스 번역 모델이 처리합니다. MCP 도구와 Realtime 동시통역도 같은 형식을 사용합니다. 자세한 내용은 번역 API 문서를 참고하세요.
{
  "model": "EdgeSpeak/Lattice-2-Flash",
  "input": "오늘 발표 행사에 오신 것을 환영합니다.",
  "translation": { "target_language": "ja", "style": "natural" }
}
음성 이해와 대화
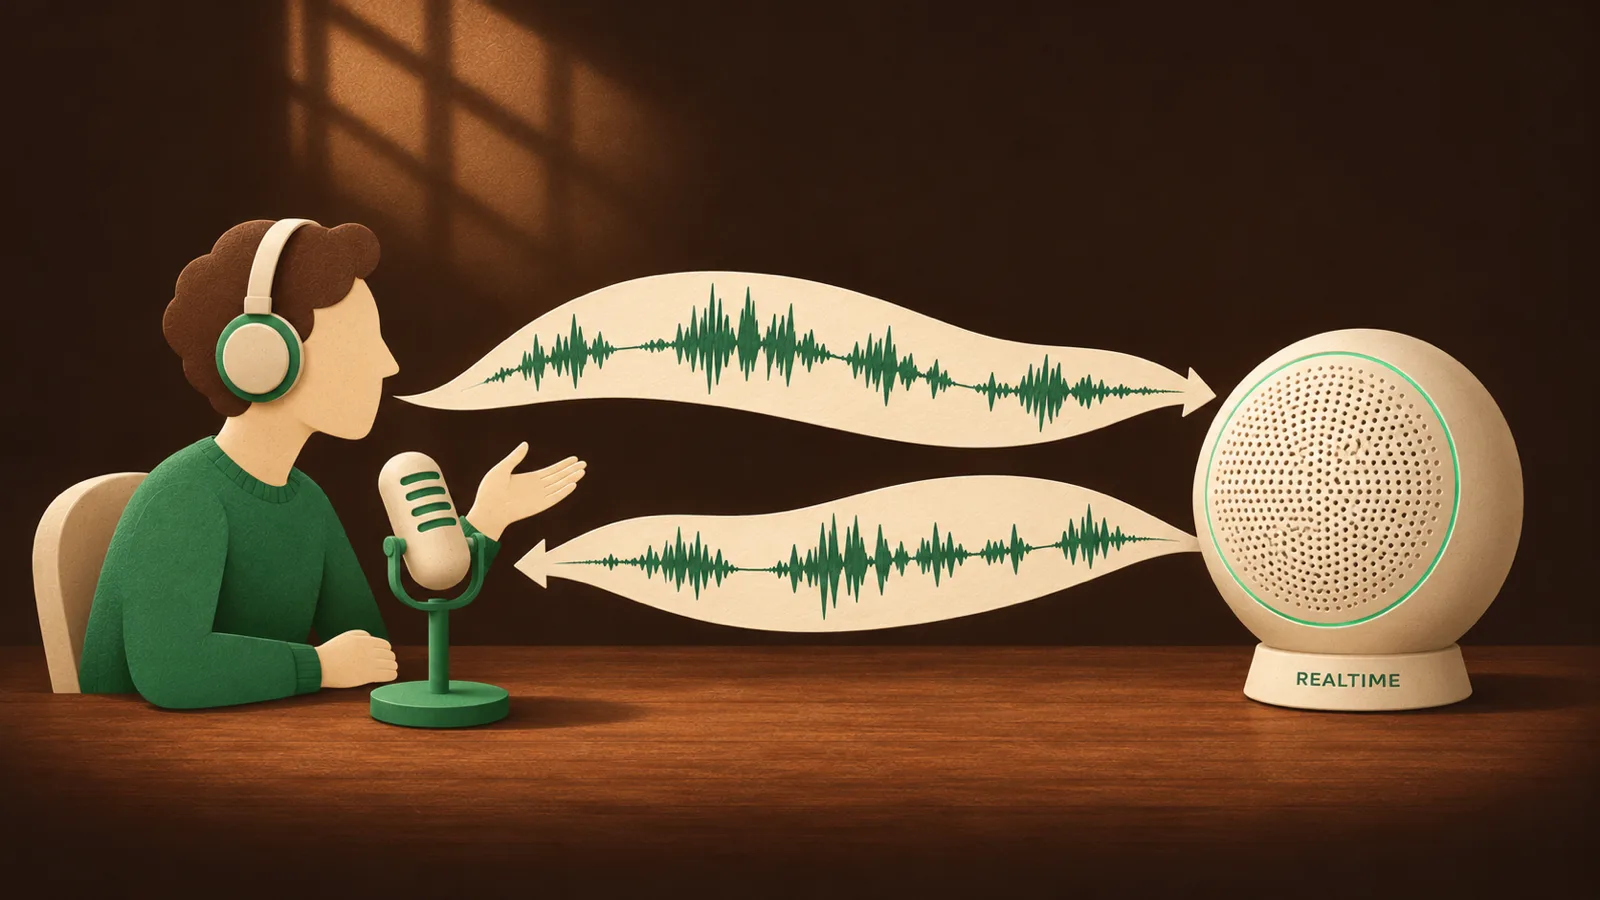
마이크에 대고 말하면 AI 모델이 내용을 이해하고 음성으로 답합니다. 언어 연습 파트너나 역할극 같은 페르소나를 선택할 수 있습니다. 언어 연습 파트너에게는 이렇게 요청할 수 있습니다. “카페 바리스타 역할을 맡아서 스페인어로 주문하는 연습을 도와줘.” 동시통역으로 전환하면 한 언어로 말하고 다른 언어로 들을 수 있습니다.
개발자도 같은 기능으로 자신만의 음성 앱을 만들 수 있습니다. 로컬 게이트웨이는 실시간 음성 대화와 응답 중 끼어들기를 지원하는 Realtime API(WebSocket)를 제공하며, 실시간 전사만 따로 사용할 수도 있습니다. 대화에 쓰는 언어 모델은 컴퓨터 사양에 맞춰 0.6B부터 27B까지 선택할 수 있습니다. Windows의 RTX 3060에서 Vulkan으로 실행할 때 생성 속도는 초당 약 173 token입니다. 음성 대화와 Realtime API 문서를 참고하세요.
음성 출력(TTS)과 음악 생성
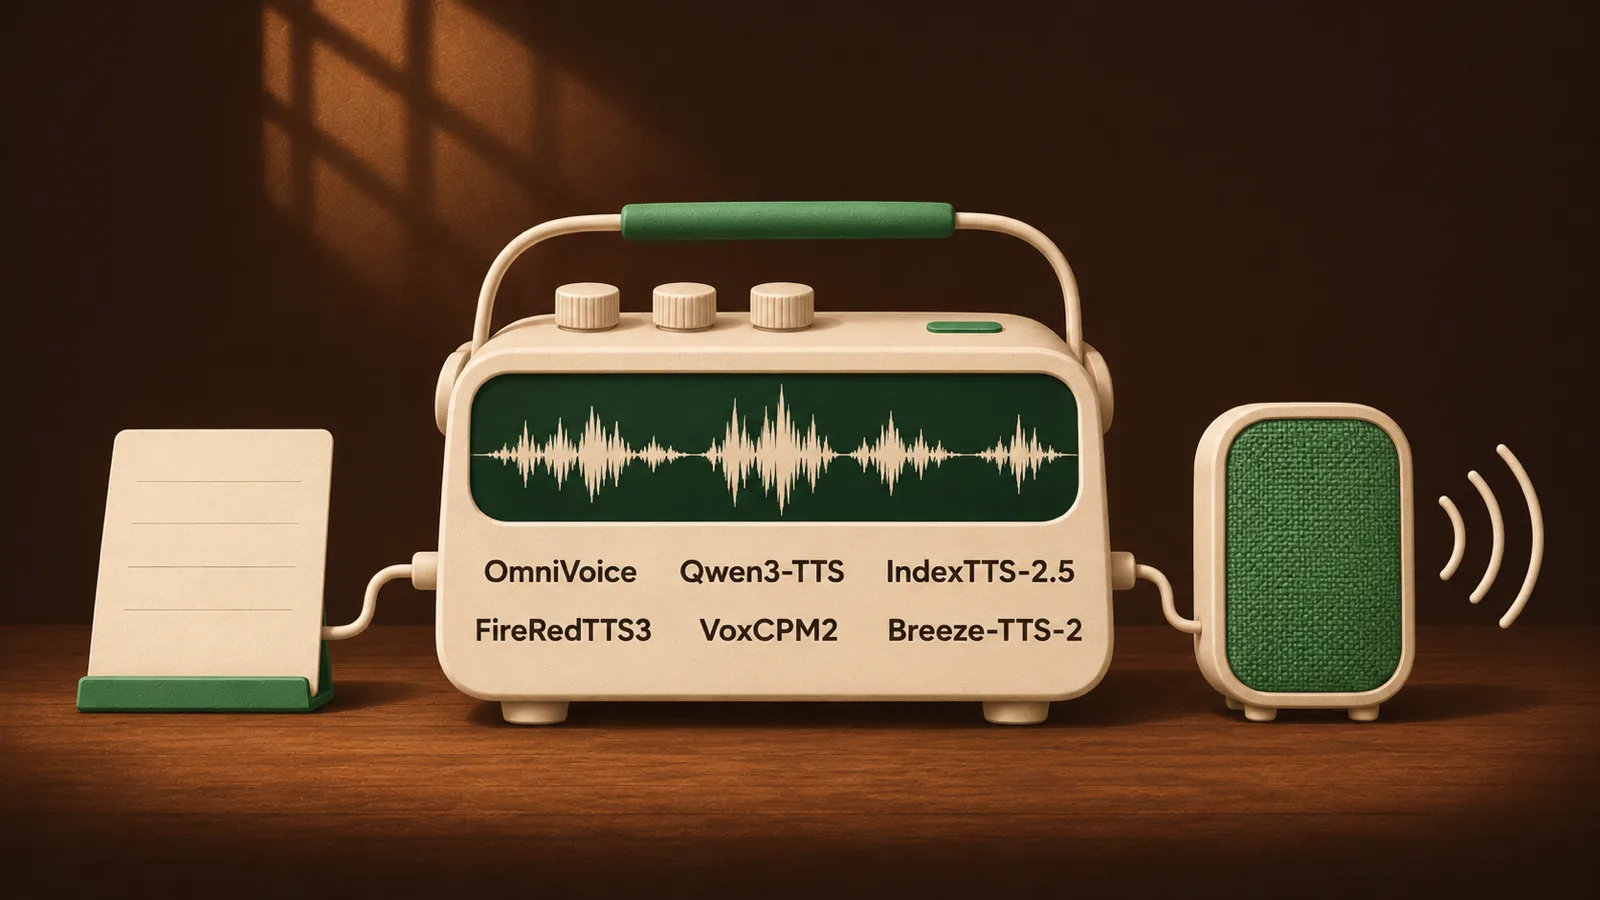
텍스트를 입력하면 음성을 생성하면서 바로 재생하거나 WAV로 내보낼 수 있습니다. EdgeSpeak는 Qwen3-TTS, FireRedTTS3, OmniVoice, IndexTTS-2.5, VoxCPM2, Breeze-TTS-2의 여섯 계열에 속하는 최신 오픈 소스 음성 모델 11개를 지원합니다. 모델마다 강점이 달라 언어, 음색, 속도에 따라 선택할 수 있으며, 우수한 새 모델이 나오면 계속 추가하고 있습니다. 내장 음성 외에도 해당 기능을 지원하는 모델에서는 선명한 참고 녹음으로 나만의 음성을 만들거나 텍스트 설명으로 음성을 디자인할 수 있습니다.
음성 생성에도 스트리밍과 가속 최적화를 적용했습니다. Apple M5 Ultra에서 Qwen3-TTS 0.6B로 31단어의 영어 문장을 합성하면 약 60~90밀리초 만에 소리가 나오기 시작하고, 약 11초 분량의 오디오를 약 2.1초 만에 완성합니다. NVIDIA GPU에서 FireRedTTS3의 생성 시간은 오디오 길이의 약 0.26×입니다. 자세한 내용은 음성 출력(TTS)을 참고하세요.
가사로 노래 만들기
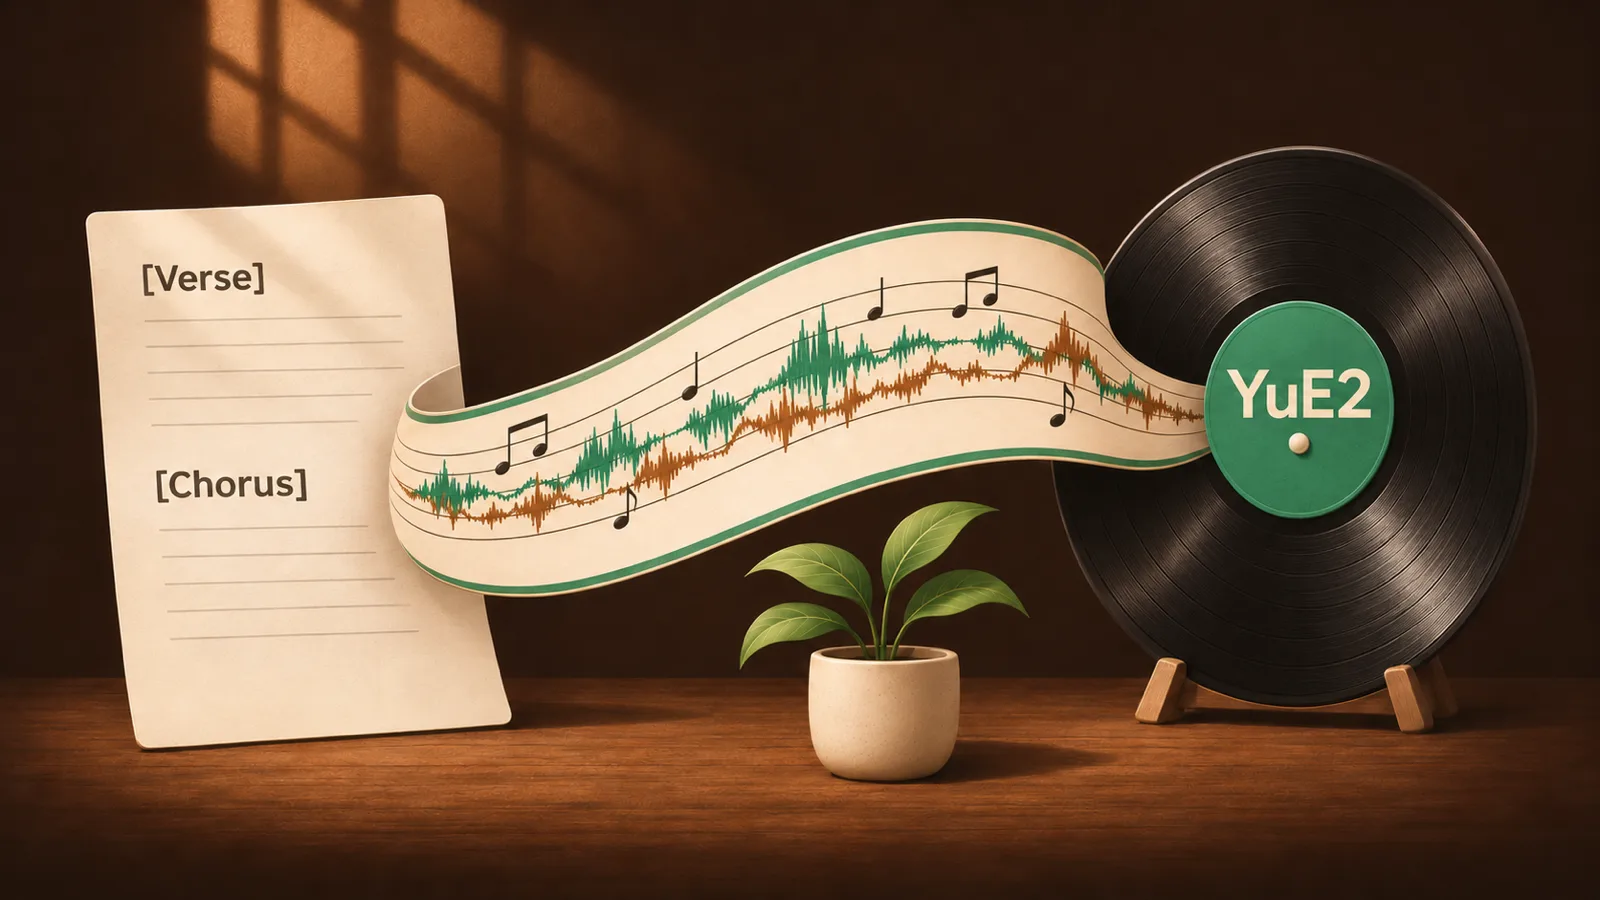
음성 출력 페이지에는 음악 모델 YuE2도 내장되어 있습니다. [Verse], [Chorus] 같은 구간 태그를 넣어 가사를 쓰고 장르, 보컬, 악기 구성을 한 문장으로 설명하면 내 컴퓨터에서 보컬과 반주가 있는 완성곡을 48 kHz 스테레오 오디오로 생성합니다. 먼저 모델이 악보를 구상하게 한 뒤 검토·수정하고 생성할 수도 있고, 직접 작성한 ABC 악보를 붙여 넣을 수도 있습니다. YuE2로 노래를 만드는 것은 무료이며 사용량 한도를 차감하지 않습니다.
YuE2에는 새로운 샘플링 방법인 AB3를 적용했습니다. 기본 14단계, 모델 연산 15회만으로 32단계 기준 결과와 거의 같은 오디오를 생성합니다(SNR 약 29 dB). Apple Silicon에서는 음원 생성과 디코딩 단계의 소요 시간이 곡 길이의 약 1.5×에서 약 0.67×로 줄어 실시간에 가까워졌습니다. 초기 멜로디 구상과 모델 로딩 시간은 제외한 수치입니다. NVIDIA RTX 4090에서는 22.3초 분량의 곡을 약 9.1초 만에 생성합니다. YuE2 가중치는 원저자의 CC BY-NC 4.0 라이선스를 유지하며 비상업적 용도로만 사용할 수 있습니다.
아래 곡은 로컬 컴퓨터에서 YuE2로 생성했습니다. 이후 EdgeSpeak의 강제 정렬로 가사를 보컬에 맞춰 각 단어의 시작·종료 시간을 얻고, 단어별 노래방 자막으로 내보내 영상에 입혔습니다. 화면의 스펙트럼과 파형은 음악에 맞춰 움직이며, 제목 영역에는 이번 생성에 사용한 모델 설정이 표시되어 있습니다. 생성부터 정렬, 자막까지 모두 같은 컴퓨터에서 처리했습니다.
로컬 게이트웨이: 음성과 텍스트 기능을 한곳에
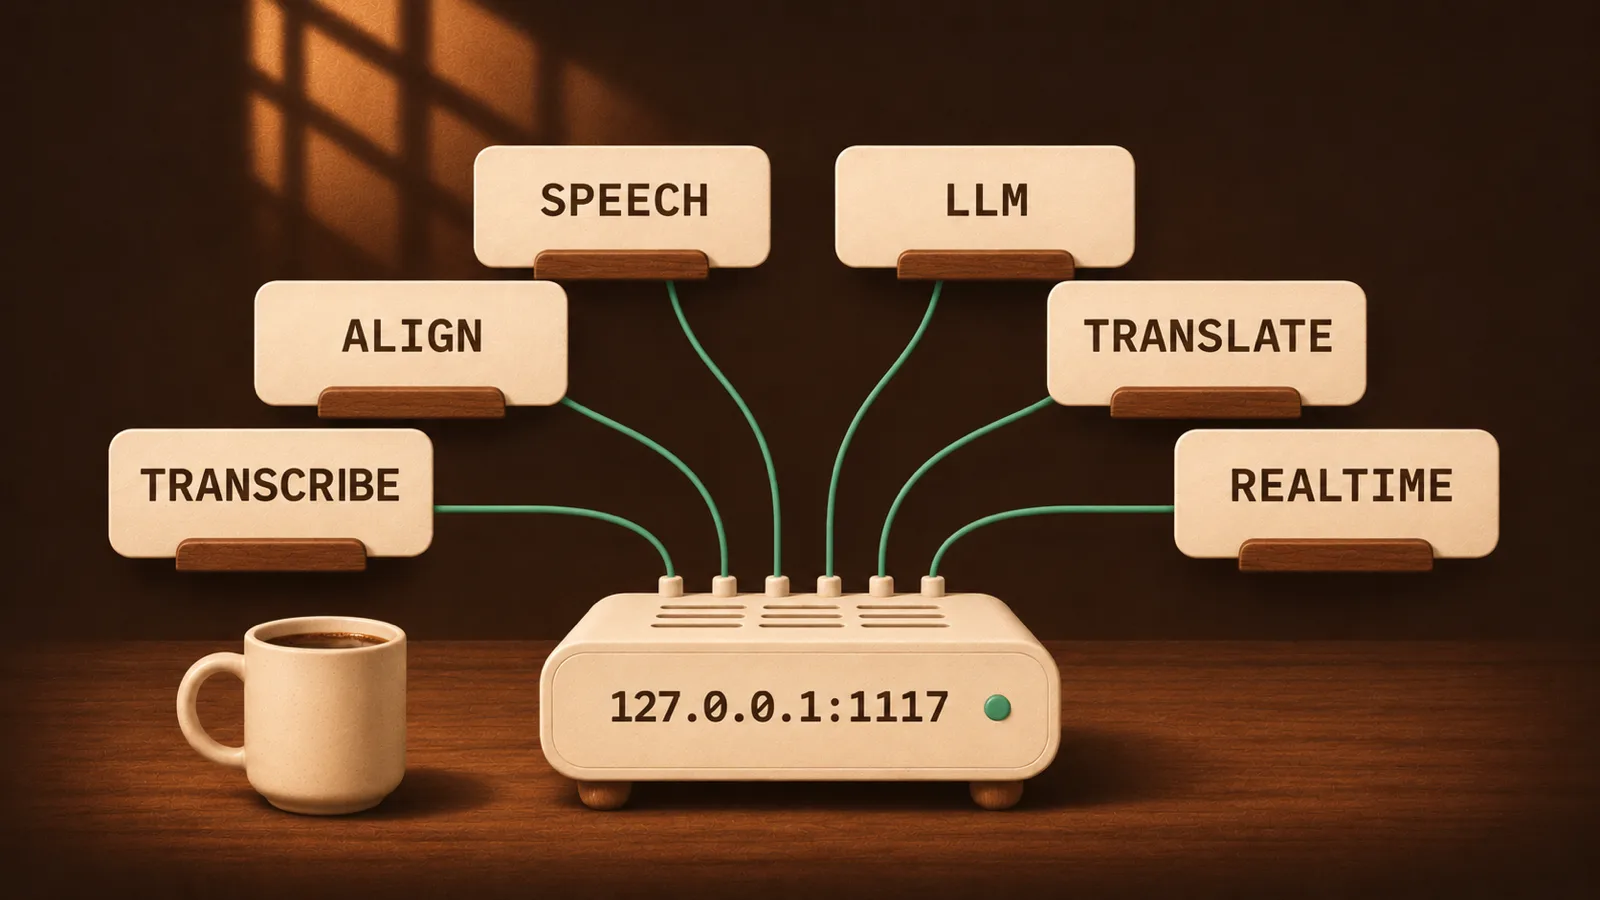
데스크톱 앱을 열면 로컬 게이트웨이가 http://127.0.0.1:1117/v1에서 실행됩니다. 데스크톱 앱 없이 edgespeak-cli serve로 따로 실행할 수도 있습니다. 게이트웨이는 OpenAI API 규약을 따르며, 전사, 정렬, 음성 출력(TTS), LLM, 번역, 실시간 음성을 하나의 주소에서 제공합니다.
| 기능 | 엔드포인트 |
|---|---|
| 전사, 화자 분리 | /v1/audio/transcriptions, /v1/speaker/diarizations |
| 강제 정렬 | /v1/audio/alignments |
| 음성 출력(TTS), 음성 생성 | /v1/audio/speech, /v1/audio/voices |
| LLM 대화, 번역, 이미지 이해 | /v1/responses, /v1/chat/completions, /v1/messages |
| 실시간 음성 대화 | /v1/realtime (WebSocket) |
| 에이전트 도구 | /mcp |
이런 기능을 사용하려면 보통 여러 클라우드 서비스에 가입하고 각각 비용을 내야 합니다. 로컬 게이트웨이를 사용하면 기본 음성 기능과 LLM 기능을 내 컴퓨터에서 실행하므로 별도의 API 서비스를 구매할 필요가 없습니다. 기존 OpenAI SDK 코드도 기본 URL을 내 컴퓨터로 바꾸면 사용할 수 있습니다. 네트워크에 있는 다른 신뢰할 수 있는 컴퓨터에 서비스를 제공하려면 헤드리스 서비스를 실행하면 됩니다. 게이트웨이 전체 구성과 두 가지 실행 방식은 로컬 음성 게이트웨이 소개를, 엔드포인트 세부 사항은 API 문서를 참고하세요.
AI 에이전트와 함께 사용하기
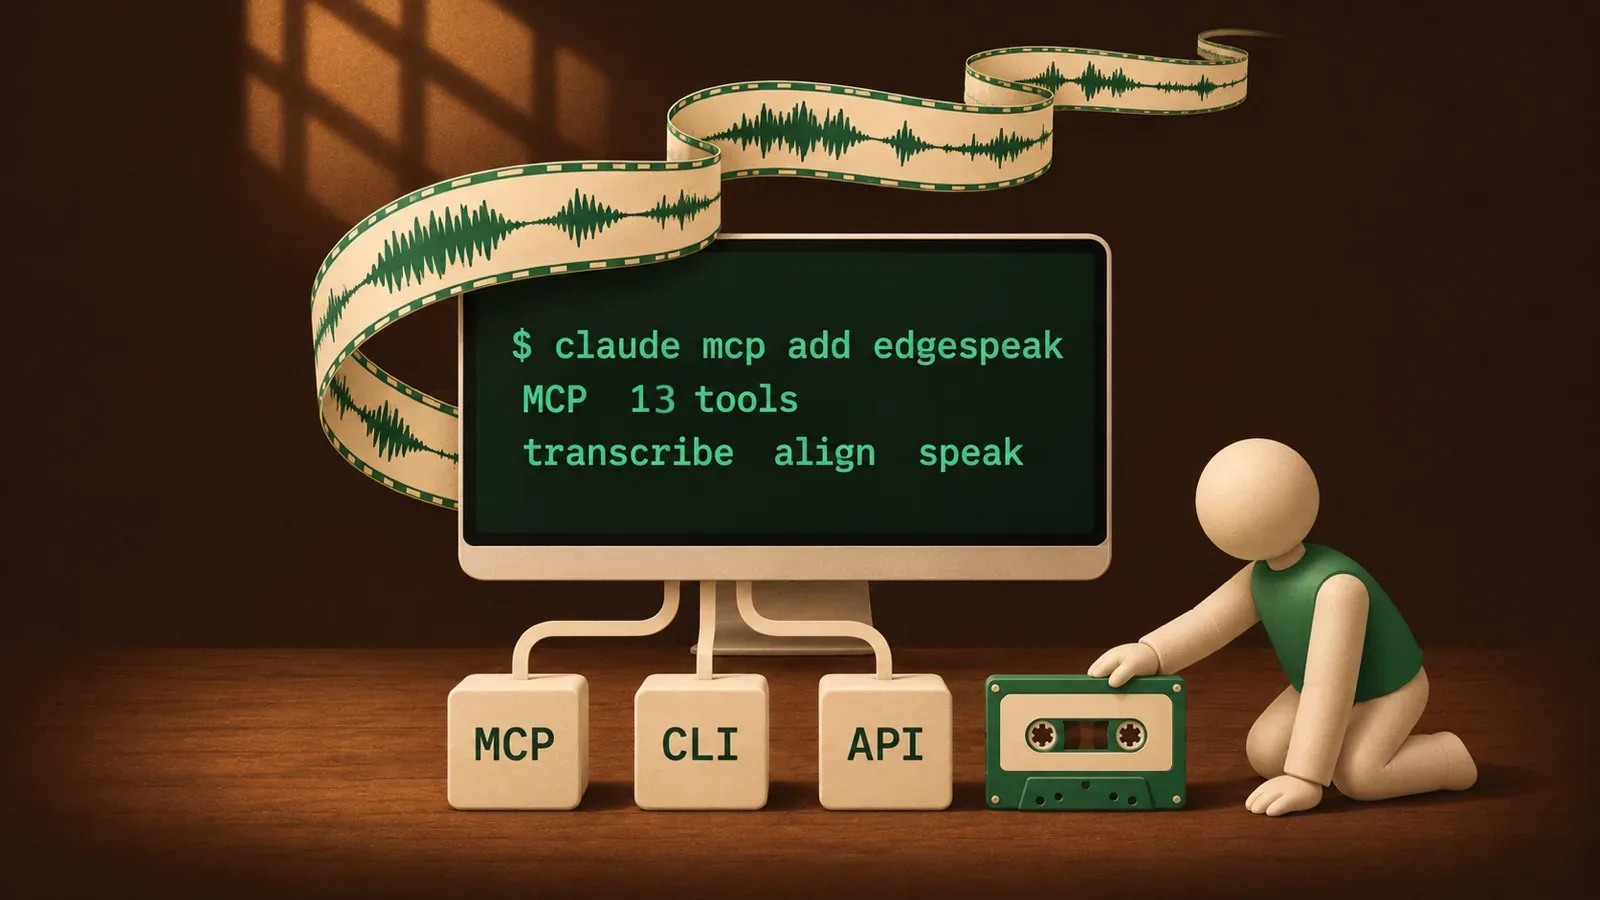
EdgeSpeak는 전사, 정렬, 화자 분리, 음성 출력(TTS), 로컬 언어 모델을 다루는 MCP 도구 13개를 제공합니다. Claude Code나 MCP를 지원하는 에이전트에 한 번 등록하면 자연어로 요청할 수 있습니다. “이 폴더의 회의 녹음을 모두 전사하고 화자별 회의록으로 정리해 줘”, “이 영상에 단어별 자막을 만들어 줘”처럼 말하면 됩니다. EdgeSpeak Agent Skill을 설치하면 에이전트가 전사, 문장 분리, 정렬, 자막 내보내기까지 전체 과정을 처리할 수 있습니다.
Claude Code와 EdgeSpeak는 영상 편집에도 함께 활용하기 좋습니다. Claude Code는 이미 FFmpeg로 영상을 처리할 수 있고, EdgeSpeak는 말의 내용을 파악하고 단어마다 시작·종료 시간을 제공하는 역할을 더합니다. “이 인터뷰에서 말실수와 2초 넘는 침묵을 잘라 줘”, “가격에 관한 부분을 짧은 클립으로 뽑고 단어별 자막을 넣어 줘”라고 요청하면 에이전트가 EdgeSpeak로 전사·정렬한 뒤 타임스탬프에 맞춰 편집하고 자막을 입힙니다. 모든 과정은 내 컴퓨터에서 이루어집니다.
claude mcp add edgespeak -- edgespeak-cli mcp자세한 내용은 MCP 문서를 참고하세요.
개인정보 보호
전사, 정렬, 화자 분리, 음성 출력(TTS)은 모두 로컬 모델로 실행합니다. 오디오, 비디오, 전사문, 사전은 기기에만 저장하며 서버에 업로드하지 않아 고객 녹음, 내부 회의, 인터뷰 등 민감한 자료를 다루기에 적합합니다. 네트워크는 로그인, 라이선스 활성화, 모델 다운로드에만 사용합니다. 음성 대화에서 클라우드 모델을 선택하면 해당 부분은 그 서비스가 처리합니다. 자세한 내용은 개인정보 처리방침을 참고하세요.
시작하기
다운로드 페이지에서 데스크톱 앱을 설치하고 로그인한 뒤, 앱 안에서 필요한 모델을 내려받으세요. 무료 요금제로 바로 체험할 수 있습니다. 일회성 라이선스를 구매하면 최대 4대의 기기에서 영구적으로 사용할 수 있으며, 향후 모델과 음성 기능 업데이트도 포함됩니다. 요금제별 사용량 한도와 가격은 요금 안내에서 확인할 수 있습니다.