強制アライメントの評価:短文、長時間音声、中国語の単語タイムスタンプを実測
強制アライメント(forced alignment)は、既存の原稿を録音に合わせ、各単語の開始・終了時刻を取得する処理です。改めて文字起こしをする必要はありません。次のような用途に使えます。
- 講演原稿や校正済みの字幕原稿から SRT / VTT / ASS 字幕を作成する
- 歌詞を歌声に合わせ、単語ごとにハイライトするカラオケ字幕を作成する
- オーディオブック、講座、語学学習教材の原文を単語ごとにハイライトし、クリックした単語から再生する
- テキストから音声や動画の該当箇所を見つけて編集する
- 音声認識、音声生成、全二重モデルの学習データに単語単位のタイムスタンプを付ける
アライメントの評価では、数秒の英語の短文だけを扱うことがよくあります。一方、実際の字幕やオーディオブックは数十分に及ぶことが多く、複数の言語が混在するテキストも使われます。今回は TIMIT と標貝の手動アノテーションを使い、英語の短文、10〜60 分の長時間音声、中国語、英語と中国語が切り替わる音声で、EdgeSpeak、Montreal Forced Aligner(MFA)、ElevenLabs Forced Alignment、Qwen3-ForcedAligner を比較しました。
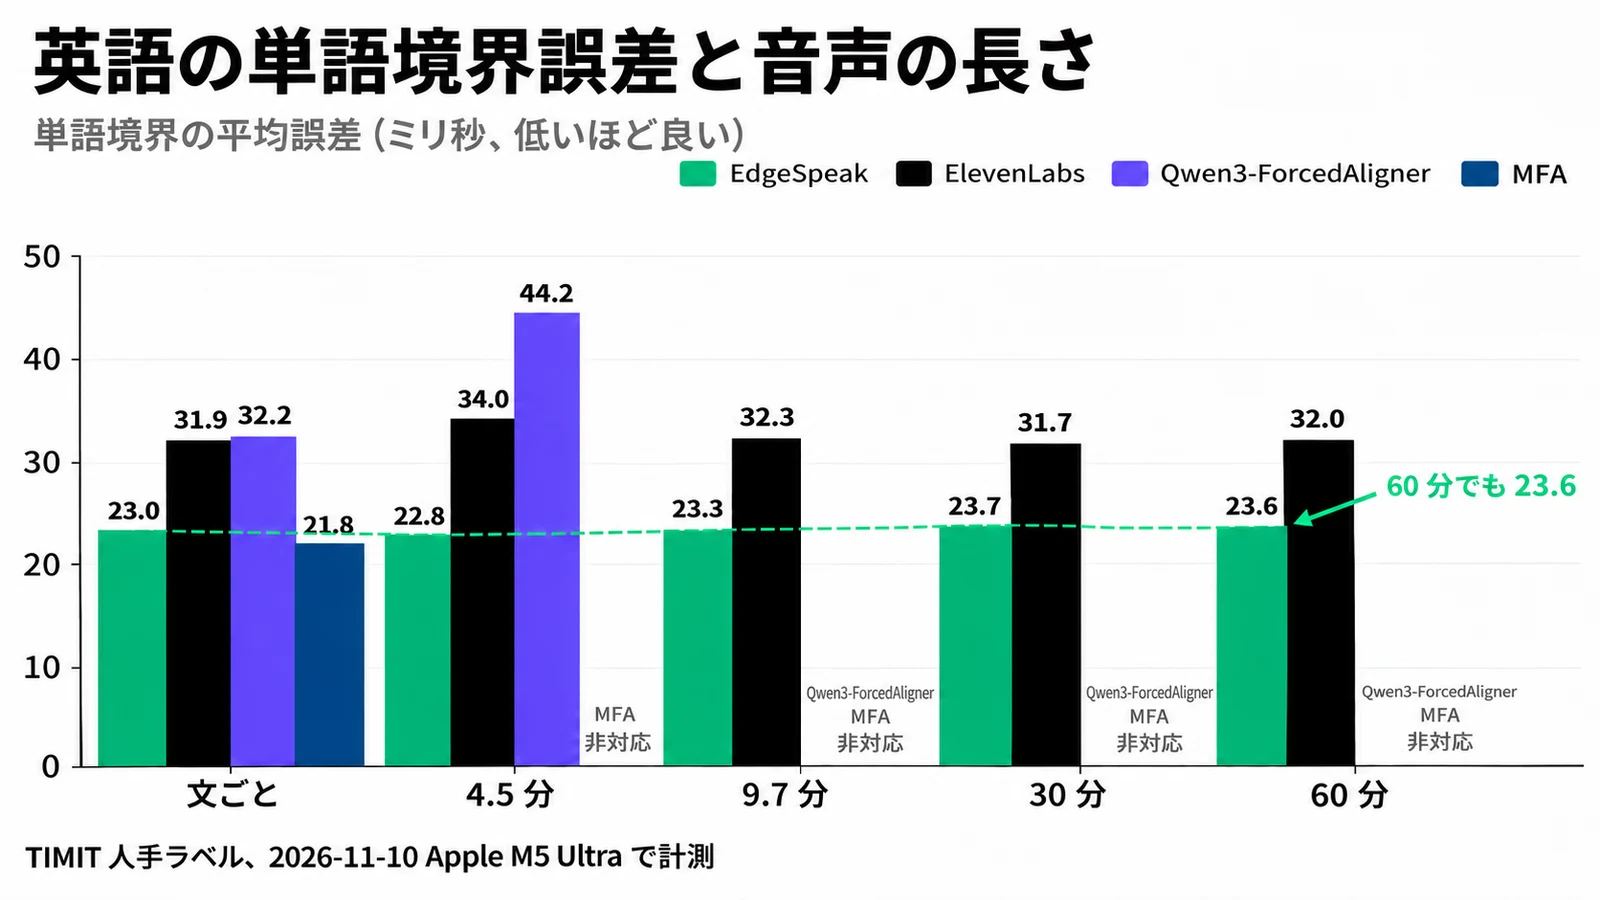
英語の短文では、EdgeSpeak の誤差は 23.0 ミリ秒でした。短文を 60 分に連結してまとめてアライメントすると、EdgeSpeak は 23.6 ミリ秒、ElevenLabs は 32.0 ミリ秒でした。37 分の中国語では、EdgeSpeak は 13.4 ミリ秒、ElevenLabs は 54.7 ミリ秒でした。EdgeSpeak はダウンロードページから、または pip install edgespeak でインストールできます。
下の 4 つは、EdgeSpeak でローカル合成したサンプル音声です。枠の 1 つ 1 つが EdgeSpeak でアライメントした単語で、枠の左右の端がその単語の開始・終了時刻です。単語をクリックすると、そこから再生します。
データセット:
- TIMIT(LDC93S1):630 人の話者によるアメリカ英語の朗読音声で、各単語の開始・終了時刻が手作業で付与されています。
- 標貝中国語標準女性音声コーパス(BZNSYP):スタジオで収録された普通話の 1 万文で、声母・韻母の境界が手作業で区切られています。中国語と英中切り替えの評価に使用し、文字単位で採点します。
単語タイムスタンプの境界誤差と対応言語
英語は TIMIT を使い、単語単位で評価します。
| ツール | 短文の誤差 | 短文 F1@20 | 短文 F1@40 | 連結 9.7 分 | 連結 60 分 |
|---|---|---|---|---|---|
| MFA 3.4.1 | 21.8 ミリ秒 | 0.65 | 0.88 | 対象外 | 対象外 |
| EdgeSpeak | 23.0 ミリ秒 | 0.62 | 0.86 | 23.3 ミリ秒 | 23.6 ミリ秒 |
| ElevenLabs | 31.9 ミリ秒 | 0.17 | 0.38 | 32.3 ミリ秒 | 32.0 ミリ秒 |
| Qwen3-ForcedAligner | 32.2 ミリ秒 | 0.40 | 0.73 | 非対応 | 非対応 |
誤差は単語境界と手動アノテーションのずれの平均で、小さいほどよい値です。F1@20 は境界が手動アノテーションから 20 ミリ秒以内にあるかを評価し、F1@40 は許容幅を 40 ミリ秒に広げた指標です。いずれも高いほどよい値で、定義は評価方法をご覧ください。24 fps の動画では、1 フレームが約 42 ミリ秒です。EdgeSpeak のアライメントモデルの時間分解能は 20 ミリ秒のため、許容幅も 20 ミリ秒の F1@20 では有利になりません。40 ミリ秒に広げると、MFA に近い値になります。
中国語は標貝のテストセットの 487 文を使い、連結すると約 37 分になります。中国語は文字単位、英語は単語単位の評価なので、両者の表を直接比較することはできません。
| ツール | 文ごとの誤差 | 37 分に連結した場合の誤差 |
|---|---|---|
| EdgeSpeak | 13.3 ミリ秒 | 13.4 ミリ秒 |
| ElevenLabs | 61.1 ミリ秒 | 54.7 ミリ秒 |
| Qwen3-ForcedAligner | 34.2 ミリ秒 | 非対応 |
MFA は音声を文ごとに分割する必要があり、長時間音声をまとめて入力することはできません。Qwen3-ForcedAligner は最大 5 分の音声に対応しています。
対応言語(各社・各プロジェクトの公式ドキュメントに基づく):
| ツール | 対応言語 |
|---|---|
| EdgeSpeak | 346 言語。中国語と英語など、複数の言語が混在するテキストもアライメント可能 |
| ElevenLabs | 29 言語 |
| Qwen3-ForcedAligner | 11 言語 |
| MFA | 使用する事前学習済みモデルによる |
英語の短文:TIMIT core test
TIMIT core test の 192 文を使います。ノイズの少ない朗読音声です。
| MFA 3.4.1 | 21.8 ミリ秒 |
|---|---|
| EdgeSpeak | 23.0 ミリ秒 |
| ElevenLabs | 31.9 ミリ秒 |
| Qwen3-ForcedAligner | 32.2 ミリ秒 |
F1 の許容幅を段階的に広げた結果です。
| ツール | F1@20 | F1@40 | F1@50 |
|---|---|---|---|
| MFA 3.4.1 | 0.65 | 0.88 | 0.92 |
| EdgeSpeak | 0.62 | 0.86 | 0.90 |
| Qwen3-ForcedAligner | 0.40 | 0.73 | 0.82 |
| ElevenLabs | 0.17 | 0.38 | 0.47 |
10〜60 分の長時間音声
EdgeSpeak で 60 分の音声をまとめてアライメントした場合の誤差は 23.6 ミリ秒で、同じ文を 1 文ずつ処理した場合は 23.4 ミリ秒でした。60 分を 10 区間に分けると、各区間の単語開始時刻の平均誤差はすべて 18〜22 ミリ秒に収まり、後半ほどずれが大きくなる傾向は見られませんでした。60 分は今回評価した中で最も長い条件です。EdgeSpeak は数時間に及ぶ音声にも対応しているため、会議全体やオーディオブック 1 冊分をまとめてアライメントできます。
9.7 分の条件には core test の 192 文、30 分と 60 分には train の文を使い、決められた順序で隙間なく連結しました。音声全体を一度に入力し、結果を単語の順序に沿って元の文に分けてから採点します。
| ツール | 長さ | 誤差 | F1@20 | F1@40 | F1@50 |
|---|---|---|---|---|---|
| EdgeSpeak | 9.7 分 | 23.3 ミリ秒 | 0.62 | 0.86 | 0.90 |
| EdgeSpeak | 30 分 | 23.7 ミリ秒 | 0.62 | 0.84 | 0.89 |
| EdgeSpeak | 60 分 | 23.6 ミリ秒 | 0.62 | 0.85 | 0.89 |
| ElevenLabs | 9.7 分 | 32.3 ミリ秒 | 0.19 | 0.38 | 0.48 |
| ElevenLabs | 30 分 | 31.7 ミリ秒 | 0.20 | 0.40 | 0.48 |
| ElevenLabs | 60 分 | 32.0 ミリ秒 | 0.19 | 0.40 | 0.49 |
Qwen3-ForcedAligner の上限は 5 分のため、4.5 分の条件でも比較しました。英語は core test の先頭 90 文、中国語は標貝のテストセットの先頭 55 文を使います。
| ツール | 英語 4.5 分 | 中国語 4.5 分 |
|---|---|---|
| EdgeSpeak | 22.8 ミリ秒 / 0.62 | 14.3 ミリ秒 / 0.79 |
| ElevenLabs | 34.0 ミリ秒 / 0.19 | 54.9 ミリ秒 / 0.15 |
| Qwen3-ForcedAligner | 44.2 ミリ秒 / 0.41 | 44.3 ミリ秒 / 0.36 |
各セルは誤差 / F1@20 です。Qwen3-ForcedAligner の誤差は、文ごとに処理した場合は英語が 32.2、中国語が 34.2 ミリ秒で、4.5 分に連結すると、それぞれ 44.2、44.3 ミリ秒になりました。
別途、4 人が発言する 26 分の英語の発表会録音も評価しました。374 文に手作業でアノテーションを付け、複数人が同時に話す 28 文を除いたところ、EdgeSpeak の文開始時刻の誤差の中央値は 30 ミリ秒で、92.2% の文は開始・終了時刻の誤差がともに 0.2 秒以内でした。
中国語の文字単位アライメント:短文と 37 分の長時間音声
標貝のテストセットの末尾 500 文を使い、手作業で確認された声母・韻母の境界を基準に、文字単位で採点します。各文字の区間は声母の開始から韻母の終了までとし、声母のない文字は韻母の開始から数えます。文字数と音節数が一致しない児化音を含む 13 文を除き、487 文が残りました。
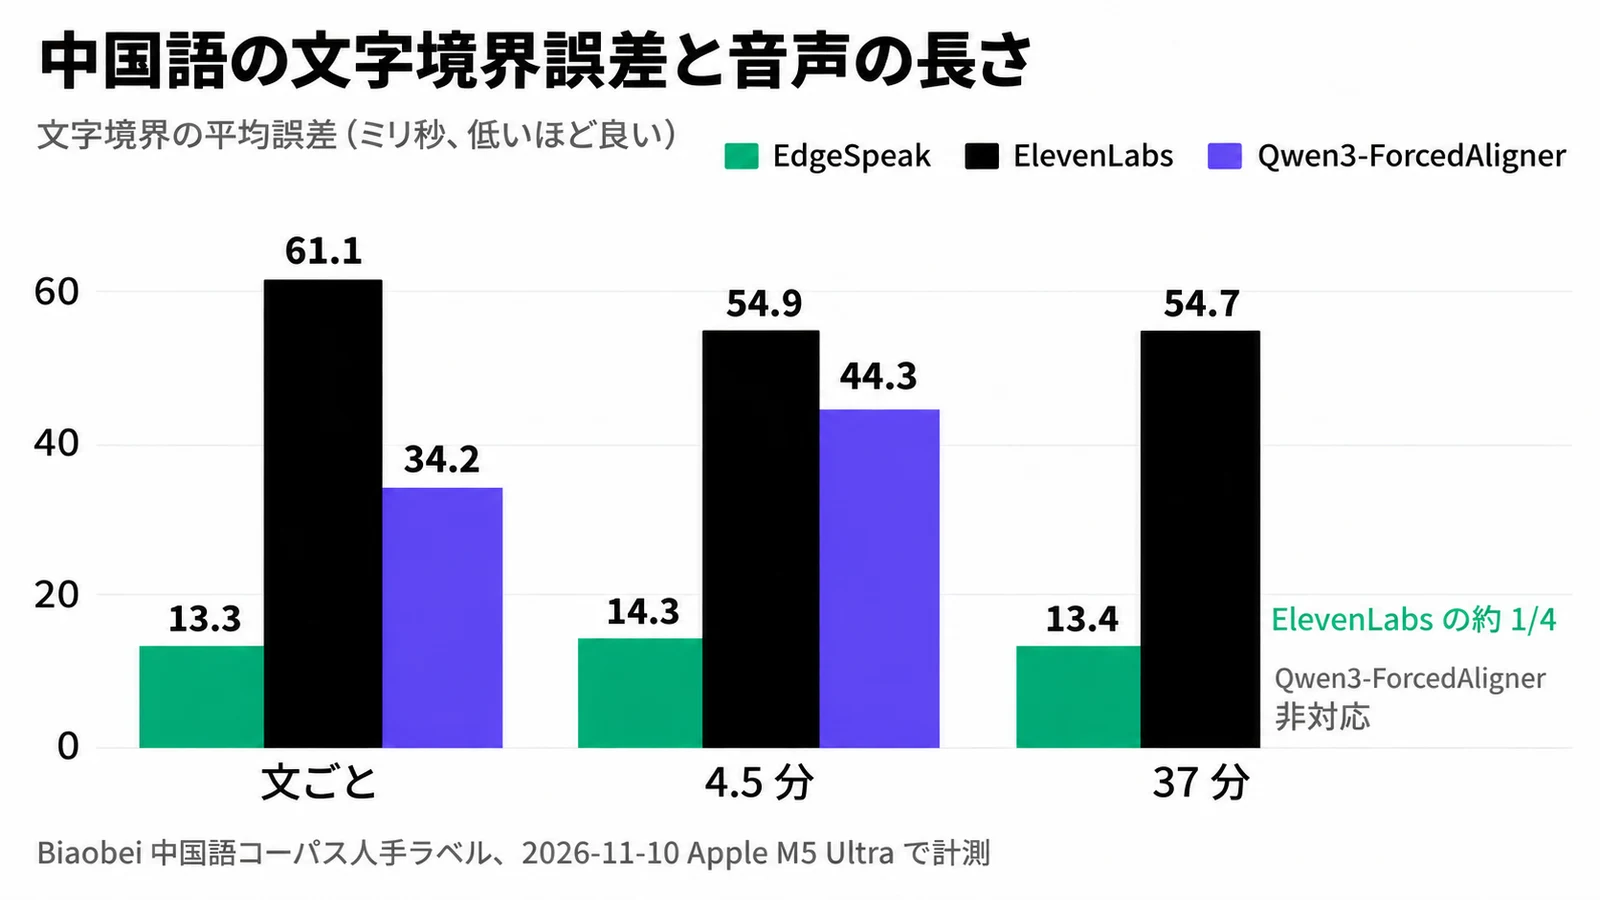
| ツール | 文ごと | 37 分に連結 | 37 分の処理時間 |
|---|---|---|---|
| EdgeSpeak | 13.3 ミリ秒 / 0.80 | 13.4 ミリ秒 / 0.80 | 10.2 秒 |
| ElevenLabs | 61.1 ミリ秒 / 0.13 | 54.7 ミリ秒 / 0.17 | 16.9 秒 |
| Qwen3-ForcedAligner | 34.2 ミリ秒 / 0.34 | 非対応 | — |
各セルは文字単位の誤差 / F1@20 です。ElevenLabs は、文ごとに処理するよりも連結したほうがややよい結果でした。
文ごとに英語と中国語を切り替え:60 分
英語の文(TIMIT)と中国語の文(標貝)を 1 文ずつ交互に連結して 60 分にし、言語を指定せずに処理します。EdgeSpeak の中国語の誤差は文ごとの処理とほぼ同じ(19.7 ミリ秒と 18.9 ミリ秒)で、英語は約 5 ミリ秒増えました。
| ツール | 音声 | 英語(単語単位) | 中国語(文字単位) |
|---|---|---|---|
| EdgeSpeak | 文ごと(比較用) | 23.6 ミリ秒 / 0.60 | 18.9 ミリ秒 / 0.72 |
| EdgeSpeak | 60 分に連結 | 28.2 ミリ秒 / 0.60 | 19.7 ミリ秒 / 0.72 |
| ElevenLabs | 60 分に連結 | 32.3 ミリ秒 / 0.24 | 124.8 ミリ秒 / 0.20 |
| Qwen3-ForcedAligner | 60 分に連結 | 非対応(上限 5 分) | 非対応 |
歌詞のアライメントとカラオケ字幕
EdgeSpeak のアライメントモデルは歌声にも対応しています。歌詞を伴奏付きの歌声に合わせ、単語ごとにハイライトするカラオケ字幕を書き出せます。[Verse] や [Chorus] のマーカーが付いた歌詞は、実際の歌唱に合わせて、繰り返す箇所や歌われない箇所を反映した順序に展開します。詳しくは対応する入力をご覧ください。
料金と 60 分の音声の実測処理時間
EdgeSpeak の料金は料金ページをご覧ください。処理時間は、60 分の英語音声を送信してから結果を受け取るまでの時間です。
| ツール | 料金 | 60 分の処理時間 |
|---|---|---|
| EdgeSpeak | プランにより 1 時間あたり 0.07〜0.20 ドル。無料プランは月に約 53 分(下表参照) | 20.5 秒 |
| ElevenLabs | 文字起こしと同額の 1 時間あたり 0.22 ドル。無音区間も課金対象 | 163 秒 |
EdgeSpeak は入力音声の長さに応じて課金し、1 時間の音声を 45,000 token として計算します。
| プラン | 料金 | 処理できる音声 | 1 時間あたり |
|---|---|---|---|
| Free | 0 | 月に約 53 分 | — |
| Basic・月払い | 月額 9 ドル | 月に約 44 時間 | 約 0.20 ドル |
| Basic・年払い | 年額 59 ドル | 年に約 533 時間 | 約 0.11 ドル |
| Pro・月払い | 月額 29 ドル | 月に約 222 時間 | 約 0.13 ドル |
| Pro・年払い | 年額 179 ドル | 年に約 2,666 時間 | 約 0.07 ドル |
| EdgeSpeak Pro・年払い | 0.07 ドル |
|---|---|
| EdgeSpeak Basic・月払い | 0.20 ドル |
| ElevenLabs | 0.22 ドル |
オンデバイス処理とプライバシー
EdgeSpeak のアライメントはデバイス上で実行され、音声、原稿、結果はパソコン内に保存されます。プライバシーポリシーをご覧ください。
EdgeSpeak、MFA、Qwen3-ForcedAligner はパソコン上で動作します。ElevenLabs は音声と原稿をクラウドにアップロードする必要があります。
評価方法と指標の定義
| ツール | バージョンと呼び出し方法 | 実行場所 |
|---|---|---|
| EdgeSpeak | edgespeak-cli、Python SDK align()、標準アライメントモデル Lattice-2 | ローカル |
| MFA | 3.4.1、english_us_arpa v3.0.0 | ローカル |
| ElevenLabs | Forced Alignment API | クラウド |
| Qwen3-ForcedAligner | 0.6B、qwen-asr 0.0.6 | ローカル |
すべてのツールで同じ手動アノテーションと採点プログラムを使い、各設定で 1 回ずつ実行しました。まず文ごとに採点し、その後、すべての境界をまとめて集計します。出力のない文や一致しない単語も評価に含めます。
- 誤差:手動で付与した各単語境界とシステムが出力した境界の差の絶対値を平均したものです。単位はミリ秒です。前の単語の終了と次の単語の開始は同じ境界として数え、文頭・文末の境界も含めます。
- F1@20:境界が手動アノテーションから 20 ミリ秒以内にあり、その両側の単語も一致すれば正解とします。F1 は境界の適合率と再現率の調和平均で、文頭・文末の境界も含めます。
長時間音声の結果は、単語の順序に沿って元の文に分けてから、同じ採点プログラムに渡します。手動アノテーションをシステムの出力として採点プログラムに通すと、誤差は 0、F1 は 1.0 になります。また、短文の結果を分割処理に通してから採点しても、直接採点した場合と数値は完全に一致します。
TIMIT と標貝はいずれもノイズの少ない朗読音声で、歌声は採点に含めていません。
対応する音声・動画、字幕原稿、歌詞
| 入力 | 詳細 |
|---|---|
| 音声・動画ファイル | パソコン上で処理し、数時間に及ぶ録音にも対応。Python SDK はメモリ上の音声バイト列や NumPy 配列も受け付けます |
| 原稿 | テキストを直接渡すか、.txt、.json、.srt、.ass、.ssa ファイルを指定。字幕ファイルの既存の時刻は無視し、再計算します |
| 歌詞 | [Verse]、[Chorus] などのセクションマーカー付きの歌詞は、実際の歌唱順序を検出し、繰り返し、歌われない箇所、順序の入れ替わりを反映して展開してからアライメントします。この処理は無効にできます(CLI ドキュメントを参照) |
| 言語 | 標準アライメントモデルは 346 言語に対応。zh、en-US、haw などの言語コードで指定するか、省略して原稿のテキストから自動判定できます。中国語と英語が混在する原稿には und を渡します |
AI エージェントとの連携:MCP、Skill、CLI、SDK
エージェントから EdgeSpeak を呼び出す場合も、音声はパソコン上で処理します。
| インターフェース | 用途 | 使い方 |
|---|---|---|
| MCP | Claude Code、Cursor などの MCP 対応クライアント | claude mcp add edgespeak -- edgespeak-cli mcp で登録。edgespeak_align など 13 個のローカルツールを提供 |
| Skill | Claude Code、Codex、Cursor | npx skills add lattifai/EdgeSpeak で追加。アライメント、カラオケ字幕、文字起こし、文の区切り、翻訳、話者の名前付けなどの Skill を利用可能 |
| CLI | コマンドを実行できるエージェント、スクリプト、バッチ処理 | edgespeak-cli align … で呼び出し、JSON、SRT、プレーンテキストを出力 |
| Python SDK | 独自のエージェントやデータパイプライン | pip install edgespeak でインストールし、EdgeSpeak().align(...) で呼び出し。今回の評価もこの方法を使用 |
インストール後は、エージェントに「EdgeSpeak で talk.mp4 と talk.txt をアライメントして、SRT を書き出して」「この曲にカラオケ字幕を付けて」と依頼できます。
ダウンロードと使い始め方
ダウンロードページからデスクトップアプリをインストールし、「アライメント」ページで音声と原稿を読み込むと、SRT / VTT / ASS 字幕やカラオケ字幕を書き出せます。
CLI はデスクトップアプリと一緒にインストールされるほか、単独でもインストールできます。詳しくは CLI ドキュメントをご覧ください。
Python SDK は pip install edgespeak でインストールできます。使い方は Python SDK ドキュメントをご覧ください。
Python SDK の EdgeSpeak() は、パソコン上で edgespeak-cli サービスを起動します。結果の時刻は秒単位で、エラー時には EdgeSpeakError を送出します。
from edgespeak import EdgeSpeak

with EdgeSpeak() as client:
    # 言語を指定
    a = client.align("speech.wav", text="His captain was thin and haggard and his beautiful boots were worn and shabby.", language="en")

    # 言語を省略:原稿のテキストから自動判定
    b = client.align("lecture.mp4", text="今天我们讲强制对齐。")

    # 字幕ファイルを原稿として使用。既存の時刻は再計算
    c = client.align("episode.m4a", text_file="episode.srt")

for segment in a["segments"]:
    for w in segment["words"]:
print(w["start"], w["end"], w["word"])返される結果です。時刻は秒単位で、score は信頼度スコア、source_start_byte と source_end_byte は原稿内での単語のバイト位置を表します。
{
  "task": "align",
  "duration": 4.9728125,
  "language": "en",
  "language_candidates": ["en"],
  "text": "His captain was thin and haggard and his beautiful boots were worn and shabby.",
  "segments": [
    {
      "id": 0,
      "start": 0.33,
      "end": 4.973,
      "text": "His captain was thin and haggard and his beautiful boots were worn and shabby.",
      "words": [
        { "word": "His", "start": 0.53, "end": 0.77, "score": 1.0, "source_start_byte": 0, "source_end_byte": 3 },
        { "word": "captain", "start": 0.77, "end": 1.27, "score": 1.0, "source_start_byte": 4, "source_end_byte": 11 },
        { "word": "was", "start": 1.27, "end": 1.49, "score": 1.0, "source_start_byte": 12, "source_end_byte": 15 },
        { "word": "thin", "start": 1.49, "end": 1.75, "score": 0.9742, "source_start_byte": 16, "source_end_byte": 20 },
        { "word": "and", "start": 1.75, "end": 1.85, "score": 0.7779, "source_start_byte": 21, "source_end_byte": 24 },
        { "word": "haggard", "start": 1.85, "end": 2.39, "score": 1.0, "source_start_byte": 25, "source_end_byte": 32 },
        { "word": "and", "start": 2.39, "end": 2.51, "score": 0.6644, "source_start_byte": 33, "source_end_byte": 36 },
        { "word": "his", "start": 2.51, "end": 2.73, "score": 0.9867, "source_start_byte": 37, "source_end_byte": 40 },
        { "word": "beautiful", "start": 2.73, "end": 3.19, "score": 0.9679, "source_start_byte": 41, "source_end_byte": 50 },
        { "word": "boots", "start": 3.19, "end": 3.65, "score": 0.9939, "source_start_byte": 51, "source_end_byte": 56 },
        { "word": "were", "start": 3.65, "end": 3.79, "score": 1.0, "source_start_byte": 57, "source_end_byte": 61 },
        { "word": "worn", "start": 3.79, "end": 4.19, "score": 1.0, "source_start_byte": 62, "source_end_byte": 66 },
        { "word": "and", "start": 4.19, "end": 4.33, "score": 0.67, "source_start_byte": 67, "source_end_byte": 70 },
        { "word": "shabby.", "start": 4.33, "end": 4.87, "score": 0.8857, "source_start_byte": 71, "source_end_byte": 78 }
      ]
    }
  ],
  "search_effort_used": "standard",
  "usage": { "type": "duration", "seconds": 4.9728125 }
}
CLI でも同様に実行でき、--language は省略可能です。
edgespeak-cli align speech.wav --text-file speech.txt --language en -o speech.srt
edgespeak-cli align lecture.mp4 --text-file lecture.txt -o lecture.json詳しい使い方は、CLI、Python SDK、アライメント API のドキュメントをご覧ください。