强制对齐评测:短句、长音频、中文,逐词边界实测
强制对齐(forced alignment)把已有的文稿对到录音上,给每个词标出起止时间,不需要重新转录。常见用法:
- 用讲稿或校对过的字幕稿生成 SRT / VTT / ASS 字幕
- 把歌词对到歌声上,做逐词高亮的卡拉 OK 字幕
- 有声书、课程和语言学习材料按原文逐词高亮,点词跳转播放
- 按文字定位、剪辑音视频
- 给语音识别、语音生成和全双工建模的训练数据标词级时间
常见的对齐评测只测几秒长的英文短句,实际的字幕和有声书常有几十分钟长,也常有多语言混合文本。我们用 TIMIT 和标贝的人工标注,测了英文短句、10 到 60 分钟的长音频、中文和中英切换,比较 EdgeSpeak、Montreal Forced Aligner(MFA)、ElevenLabs Forced Alignment 和 Qwen3-ForcedAligner。
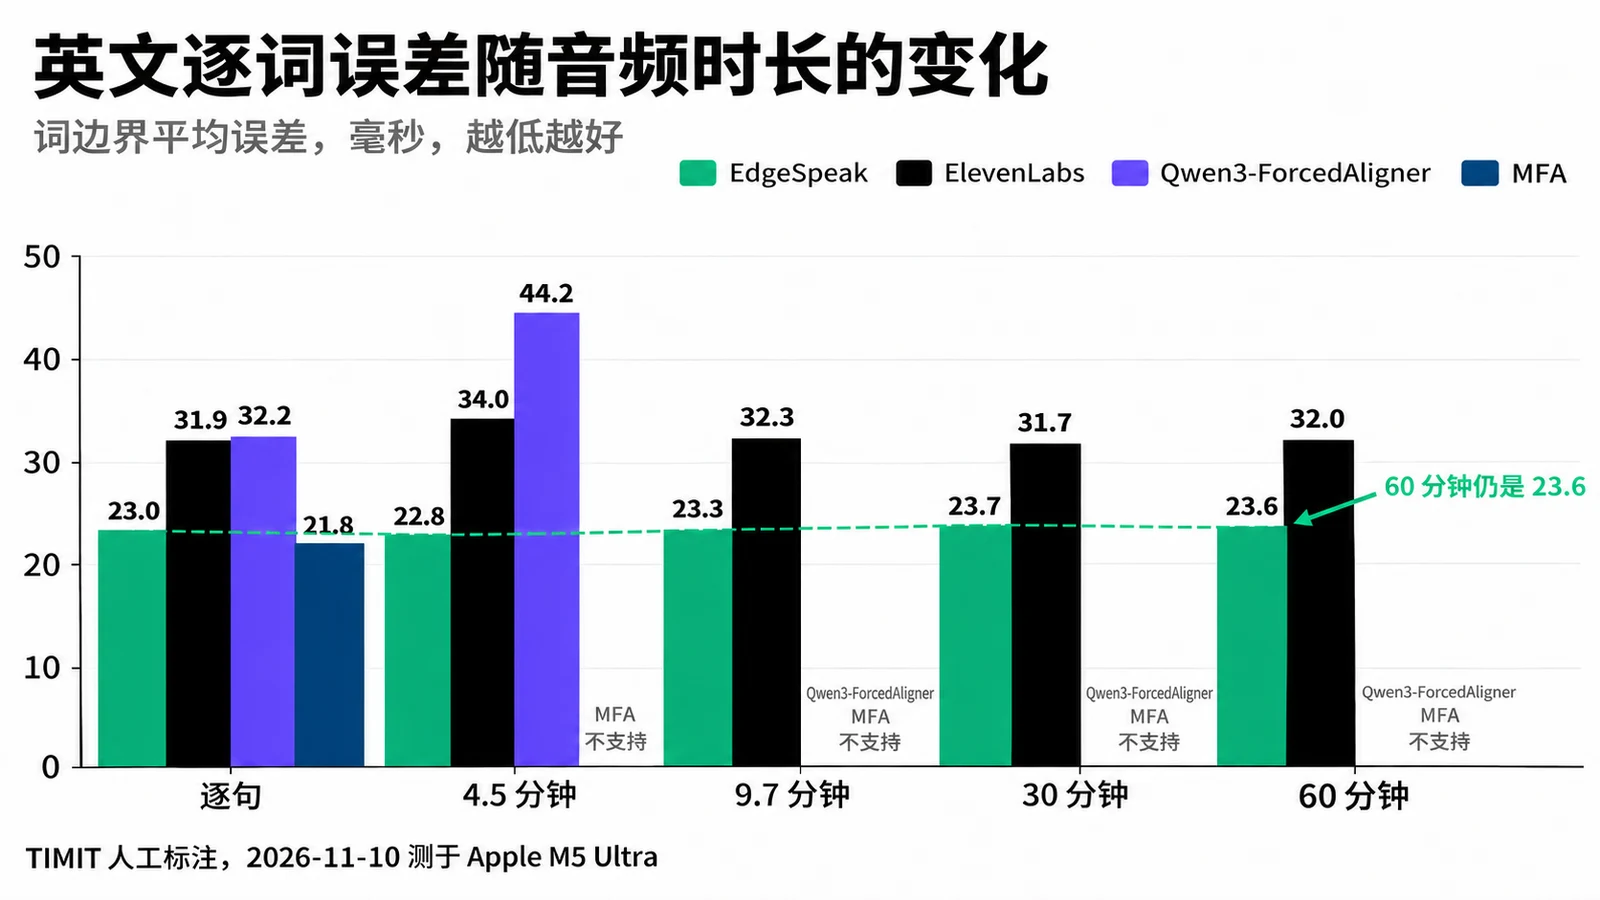
英文短句上,EdgeSpeak 的误差是 23.0 毫秒。将短句拼成 60 分钟进行对齐,EdgeSpeak 的误差是 23.6 毫秒,ElevenLabs 是 32.0 毫秒。中文 37 分钟,EdgeSpeak 13.4 毫秒,ElevenLabs 54.7 毫秒。EdgeSpeak 可以从下载页安装,也可以 pip install edgespeak。
下面四段是 EdgeSpeak 在本机合成的示例录音。每个框是 EdgeSpeak 对齐出的一个词,框的左右边就是这个词的起止时间。点任意一个词,从那里开始播放:
数据集:
- TIMIT(LDC93S1):630 位说话人朗读的美式英语,每个词都有人工标注的起止时间。
- 标贝中文标准女声音库(BZNSYP):1 万句普通话、录音棚录制,带人工切分的声母、韵母边界。中文和中英切换用它,按字评分。
逐词误差与语言覆盖
英文,按词计,TIMIT:
| 方案 | 短句误差 | 短句 F1@20 | 短句 F1@40 | 拼接 9.7 分钟 | 拼接 60 分钟 |
|---|---|---|---|---|---|
| MFA 3.4.1 | 21.8 毫秒 | 0.65 | 0.88 | 不适用 | 不适用 |
| EdgeSpeak | 23.0 毫秒 | 0.62 | 0.86 | 23.3 毫秒 | 23.6 毫秒 |
| ElevenLabs | 31.9 毫秒 | 0.17 | 0.38 | 32.3 毫秒 | 32.0 毫秒 |
| Qwen3-ForcedAligner | 32.2 毫秒 | 0.40 | 0.73 | 不支持 | 不支持 |
误差是词边界和人工标注的平均偏差,越低越好;F1@20 看边界是否落在人工标注 20 毫秒以内,F1@40 放宽到 40 毫秒,越高越好,定义见评测方法。24 帧视频的一帧约 42 毫秒。EdgeSpeak 对齐模型的时间分辨率是 20 毫秒,所以在容差同为 20 毫秒的 F1@20 上不占优势,放宽到 40 毫秒后和 MFA 接近。
中文用标贝 test 的 487 句,拼起来约 37 分钟。中文按字、英文按词,两张表不能横比:
| 方案 | 逐句误差 | 拼成 37 分钟误差 |
|---|---|---|
| EdgeSpeak | 13.3 毫秒 | 13.4 毫秒 |
| ElevenLabs | 61.1 毫秒 | 54.7 毫秒 |
| Qwen3-ForcedAligner | 34.2 毫秒 | 不支持 |
MFA 要先把音频切成句,不接收整段长音频;Qwen3-ForcedAligner 最长支持 5 分钟。
语言覆盖(以各家官方文档为准):
英文短句:TIMIT core test
TIMIT core test 192 句,干净的朗读录音:
| MFA 3.4.1 | 21.8 毫秒 |
|---|---|
| EdgeSpeak | 23.0 毫秒 |
| ElevenLabs | 31.9 毫秒 |
| Qwen3-ForcedAligner | 32.2 毫秒 |
把 F1 的容差逐档放宽:
| 方案 | F1@20 | F1@40 | F1@50 |
|---|---|---|---|
| MFA 3.4.1 | 0.65 | 0.88 | 0.92 |
| EdgeSpeak | 0.62 | 0.86 | 0.90 |
| Qwen3-ForcedAligner | 0.40 | 0.73 | 0.82 |
| ElevenLabs | 0.17 | 0.38 | 0.47 |
10 到 60 分钟长音频
EdgeSpeak 一次对齐 60 分钟,误差 23.6 毫秒,同一批句子逐句对齐是 23.4 毫秒。把 60 分钟切成 10 段,每段的平均词起点误差都在 18 到 22 毫秒,没有越往后越偏。60 分钟是这次评测最长的一档,EdgeSpeak 支持数小时长的音频,整场会议、整本有声书都可以一次对齐。
9.7 分钟用 core test 的 192 句,30 和 60 分钟用 train 的句子,按固定顺序首尾相接。整段一次送进去,结果按词序拆回原句再评分。
| 方案 | 时长 | 误差 | F1@20 | F1@40 | F1@50 |
|---|---|---|---|---|---|
| EdgeSpeak | 9.7 分钟 | 23.3 毫秒 | 0.62 | 0.86 | 0.90 |
| EdgeSpeak | 30 分钟 | 23.7 毫秒 | 0.62 | 0.84 | 0.89 |
| EdgeSpeak | 60 分钟 | 23.6 毫秒 | 0.62 | 0.85 | 0.89 |
| ElevenLabs | 9.7 分钟 | 32.3 毫秒 | 0.19 | 0.38 | 0.48 |
| ElevenLabs | 30 分钟 | 31.7 毫秒 | 0.20 | 0.40 | 0.48 |
| ElevenLabs | 60 分钟 | 32.0 毫秒 | 0.19 | 0.40 | 0.49 |
Qwen3-ForcedAligner 最长支持 5 分钟音频,所以另比了一组 4.5 分钟:英文取 core test 前 90 句,中文取标贝 test 前 55 句。
| 方案 | 英文 4.5 分钟 | 中文 4.5 分钟 |
|---|---|---|
| EdgeSpeak | 22.8 毫秒 / 0.62 | 14.3 毫秒 / 0.79 |
| ElevenLabs | 34.0 毫秒 / 0.19 | 54.9 毫秒 / 0.15 |
| Qwen3-ForcedAligner | 44.2 毫秒 / 0.41 | 44.3 毫秒 / 0.36 |
每格是误差 / F1@20。Qwen3-ForcedAligner 逐句时英文 32.2、中文 34.2 毫秒,拼成 4.5 分钟后升到 44.2 和 44.3 毫秒。
我们另外测了一场 26 分钟、4 人发言的英文发布会录音,人工标注 374 句。去掉 28 句多人同时说话的句子后,EdgeSpeak 的句首误差中位数为 30 毫秒,92.2% 的句子句首和句尾误差都在 0.2 秒以内。
中文逐字对齐:短句与 37 分钟长音频
标贝 test 取最后 500 句,用人工校对的声母、韵母边界按字评分。每个字从声母起点算到韵母终点,零声母字从韵母起点算起。去掉 13 句字数和音节数对不上的儿化音句子,剩 487 句。
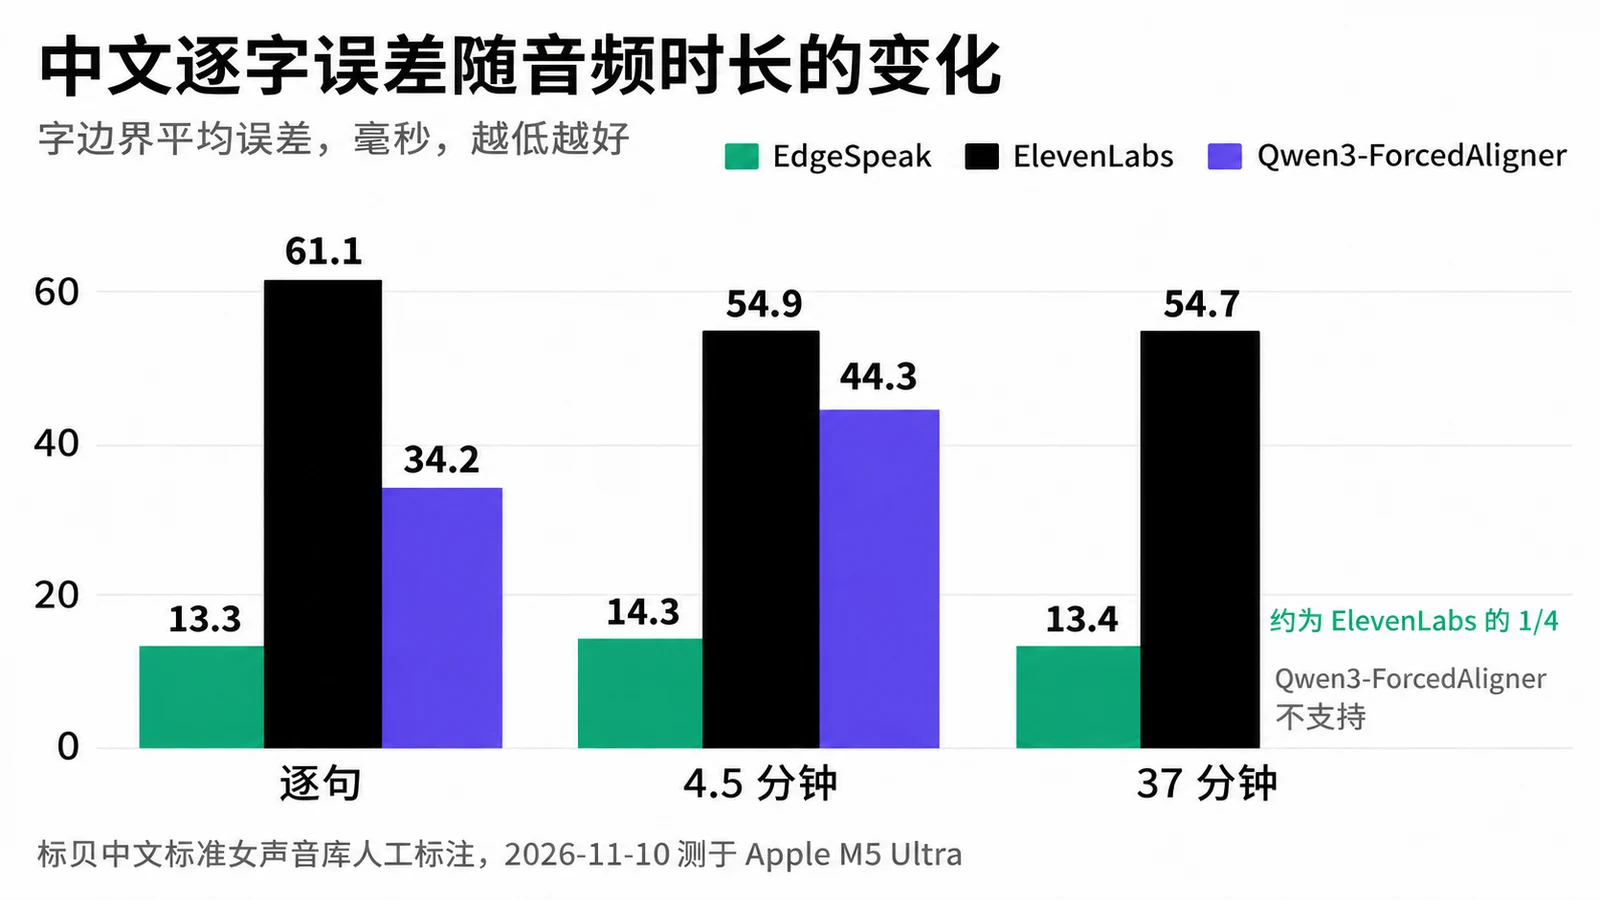
| 方案 | 逐句 | 拼成 37 分钟 | 37 分钟用时 |
|---|---|---|---|
| EdgeSpeak | 13.3 毫秒 / 0.80 | 13.4 毫秒 / 0.80 | 10.2 秒 |
| ElevenLabs | 61.1 毫秒 / 0.13 | 54.7 毫秒 / 0.17 | 16.9 秒 |
| Qwen3-ForcedAligner | 34.2 毫秒 / 0.34 | 不支持 | — |
每格是误差 / F1@20,按字计。ElevenLabs 拼接后反而比逐句好一些。
中英句间切换:60 分钟
英文句(TIMIT)和中文句(标贝)一句一句交替,拼成 60 分钟,不指定语言。EdgeSpeak 的中文和逐句差不多(19.7 对 18.9 毫秒),英文多约 5 毫秒。
| 方案 | 音频 | 英文(按词) | 中文(按字) |
|---|---|---|---|
| EdgeSpeak | 逐句对照 | 23.6 毫秒 / 0.60 | 18.9 毫秒 / 0.72 |
| EdgeSpeak | 拼接 60 分钟 | 28.2 毫秒 / 0.60 | 19.7 毫秒 / 0.72 |
| ElevenLabs | 拼接 60 分钟 | 32.3 毫秒 / 0.24 | 124.8 毫秒 / 0.20 |
| Qwen3-ForcedAligner | 拼接 60 分钟 | 不支持(上限 5 分钟) | 不支持 |
歌词对齐与卡拉 OK 字幕
EdgeSpeak 的对齐模型也支持歌声:把歌词对到带伴奏的演唱上,导出逐词高亮的卡拉 OK 字幕。带 [Verse]、[Chorus] 标记的歌词,会按实际演唱展开重唱和漏唱的段落,见支持的输入。
价格与 60 分钟实际用时
EdgeSpeak 见定价。用时是 60 分钟英文从提交到拿到结果的时间。
| 方案 | 价格 | 60 分钟用时 |
|---|---|---|
| EdgeSpeak | 按档位折合每小时 0.07–0.20 美元,免费版每月约 53 分钟(见下表) | 20.5 秒 |
| ElevenLabs | 与转录同价,每小时 0.22 美元,静音计入时长 | 163 秒 |
EdgeSpeak 按输入音频时长计费,1 小时音频记 45,000 token。
| 档位 | 价格 | 可处理音频 | 折合每小时 |
|---|---|---|---|
| 免费版 | 0 | 每月约 53 分钟 | — |
| 基础版·月付 | 每月 9 美元 | 每月约 44 小时 | 约 0.20 美元 |
| 基础版·年付 | 每年 59 美元 | 每年约 533 小时 | 约 0.11 美元 |
| 专业版·月付 | 每月 29 美元 | 每月约 222 小时 | 约 0.13 美元 |
| 专业版·年付 | 每年 179 美元 | 每年约 2,666 小时 | 约 0.07 美元 |
| EdgeSpeak 专业版·年付 | 0.07 美元 |
|---|---|
| EdgeSpeak 基础版·月付 | 0.20 美元 |
| ElevenLabs | 0.22 美元 |
本机运行与隐私
EdgeSpeak 的对齐在端侧完成,音频、文稿和结果都在本机。见隐私说明。
EdgeSpeak、MFA 和 Qwen3-ForcedAligner 在本机运行,ElevenLabs 需要把音频和文稿传到云端。
评测方法与指标定义
| 方案 | 版本与调用方式 | 运行位置 |
|---|---|---|
| EdgeSpeak | edgespeak-cli,Python SDK align(),默认对齐模型 Lattice-2 | 本机 |
| MFA | 3.4.1,english_us_arpa v3.0.0 | 本机 |
| ElevenLabs | Forced Alignment 接口 | 云端 |
| Qwen3-ForcedAligner | 0.6B,qwen-asr 0.0.6 | 本机 |
所有方案用同一套人工标注和同一个评分器,每个配置跑一次。先逐句评分,再按全部边界汇总;没有输出的句子和对不上的词也计入评分。
- 误差:每条人工词边界与系统边界之差的绝对值,取平均,单位毫秒;前一个词的终点和后一个词的起点算同一条边界,句首和句尾边界也算在内。
- F1@20:边界落在人工边界 20 毫秒以内、且两侧的词都对得上,算一次命中;F1 是命中边界的精确率和召回率的调和平均,句首尾边界也算在内。
长音频的结果先按词序拆回逐句,再交给同一个评分器。把人工标注当作输出跑一遍,误差为 0,F1 为 1.0;短句结果经过拆分再评分,分数和直接评分逐位相同。
TIMIT 和标贝都是干净的朗读录音,歌声没有放进评分。
支持的音视频、字幕稿与歌词
| 输入 | 说明 |
|---|---|
| 音频或视频文件 | 音视频在本机处理,支持数小时长的录音;Python SDK 也接受内存里的音频字节和 NumPy 数组 |
| 文稿 | 直接传文本,或文稿文件 .txt、.json、.srt、.ass、.ssa;字幕文件原有的时间会被忽略、重新计算 |
| 歌词 | 带段落标记(如 [Verse]、[Chorus])的歌词会先检测实际演唱顺序,按实际演唱的重唱、漏唱和换序展开后再对齐,可以关闭(见 CLI 文档) |
| 语言 | 默认对齐模型覆盖 346 种语言。可以用语言代码指定,如 zh、en-US、haw;也可以不指定,按文稿文字自动判定;中英混合的文稿传 und |
接入 AI Agent:MCP、Skill、CLI、SDK
Agent 调用 EdgeSpeak 时,音频都在本机处理。
| 方式 | 适合 | 怎么接 |
|---|---|---|
| MCP | Claude Code、Cursor 等支持 MCP 的客户端 | claude mcp add edgespeak -- edgespeak-cli mcp,提供 edgespeak_align 等 13 个本机工具 |
| Skill | Claude Code、Codex、Cursor | npx skills add lattifai/EdgeSpeak,包含对齐、卡拉 OK 字幕、转录、分句、翻译、说话人命名等 Skill |
| CLI | 能执行命令的 Agent、脚本和批处理 | edgespeak-cli align …,输出 JSON、SRT 或纯文本 |
| Python SDK | 自己写的 Agent 和数据流水线 | pip install edgespeak,EdgeSpeak().align(...),本文的评测就是这样调用的 |
装好后对 Agent 说「用 EdgeSpeak 把 talk.mp4 和 talk.txt 对齐,导出 SRT」,或者「给这首歌做卡拉 OK 字幕」就行。
下载与开始使用
从下载页安装桌面版,在「对齐」页导入音频和文稿,再导出 SRT / VTT / ASS 字幕或卡拉 OK 字幕。
CLI 随桌面版安装,也可以单独装,见 CLI 文档。
用 pip install edgespeak 安装 Python SDK,用法见 Python SDK 文档。
Python SDK 的 EdgeSpeak() 会在本机启动 edgespeak-cli 服务。结果中的时间以秒为单位,出错时抛出 EdgeSpeakError:
from edgespeak import EdgeSpeak

with EdgeSpeak() as client:
    # 指定语言
    a = client.align("speech.wav", text="His captain was thin and haggard and his beautiful boots were worn and shabby.", language="en")

    # 不指定语言:按文稿文字自动判定
    b = client.align("lecture.mp4", text="今天我们讲强制对齐。")

    # 用字幕文件当文稿,原有时间会重新计算
    c = client.align("episode.m4a", text_file="episode.srt")

for segment in a["segments"]:
    for w in segment["words"]:
print(w["start"], w["end"], w["word"])返回结果(时间单位为秒;score 是置信分数;source_start_byte 和 source_end_byte 是这个词在文稿里的字节位置):
{
  "task": "align",
  "duration": 4.9728125,
  "language": "en",
  "language_candidates": ["en"],
  "text": "His captain was thin and haggard and his beautiful boots were worn and shabby.",
  "segments": [
    {
      "id": 0,
      "start": 0.33,
      "end": 4.973,
      "text": "His captain was thin and haggard and his beautiful boots were worn and shabby.",
      "words": [
        { "word": "His", "start": 0.53, "end": 0.77, "score": 1.0, "source_start_byte": 0, "source_end_byte": 3 },
        { "word": "captain", "start": 0.77, "end": 1.27, "score": 1.0, "source_start_byte": 4, "source_end_byte": 11 },
        { "word": "was", "start": 1.27, "end": 1.49, "score": 1.0, "source_start_byte": 12, "source_end_byte": 15 },
        { "word": "thin", "start": 1.49, "end": 1.75, "score": 0.9742, "source_start_byte": 16, "source_end_byte": 20 },
        { "word": "and", "start": 1.75, "end": 1.85, "score": 0.7779, "source_start_byte": 21, "source_end_byte": 24 },
        { "word": "haggard", "start": 1.85, "end": 2.39, "score": 1.0, "source_start_byte": 25, "source_end_byte": 32 },
        { "word": "and", "start": 2.39, "end": 2.51, "score": 0.6644, "source_start_byte": 33, "source_end_byte": 36 },
        { "word": "his", "start": 2.51, "end": 2.73, "score": 0.9867, "source_start_byte": 37, "source_end_byte": 40 },
        { "word": "beautiful", "start": 2.73, "end": 3.19, "score": 0.9679, "source_start_byte": 41, "source_end_byte": 50 },
        { "word": "boots", "start": 3.19, "end": 3.65, "score": 0.9939, "source_start_byte": 51, "source_end_byte": 56 },
        { "word": "were", "start": 3.65, "end": 3.79, "score": 1.0, "source_start_byte": 57, "source_end_byte": 61 },
        { "word": "worn", "start": 3.79, "end": 4.19, "score": 1.0, "source_start_byte": 62, "source_end_byte": 66 },
        { "word": "and", "start": 4.19, "end": 4.33, "score": 0.67, "source_start_byte": 67, "source_end_byte": 70 },
        { "word": "shabby.", "start": 4.33, "end": 4.87, "score": 0.8857, "source_start_byte": 71, "source_end_byte": 78 }
      ]
    }
  ],
  "search_effort_used": "standard",
  "usage": { "type": "duration", "seconds": 4.9728125 }
}命令行同理,--language 可选:
edgespeak-cli align speech.wav --text-file speech.txt --language en -o speech.srt
edgespeak-cli align lecture.mp4 --text-file lecture.txt -o lecture.json更多用法见文档:CLI、Python SDK、对齐 API。