本地网关 API
从本机或其他可信机器调用 EdgeSpeak API。
API 阅读路线
每篇指南都包含请求、输出示例、前置条件和返回索引的链接。
- 转录与说话人
- 文本处理
- 播报与声音库
- 强制对齐
- 语言与视觉
- Realtime 实时会话
- 模型与服务
- Agent 集成阅读 MCP 工具与 HTTP 传输,终端工作流阅读 CLI。
接收内容语言的接口共用一套语言代码,各接口的具体规则见语言代码。通过 API 更新日志 查看兼容性和迁移说明;日志按 API 的实际变更独立更新,不与桌面版本绑定。
快速开始
选择一种方式启动服务;客户端使用对应的基础地址。
| 启动方式 | 操作 | 默认基础地址 |
|---|---|---|
| 桌面 App | 打开 App,在「本地网关」确认服务已运行。 | http://127.0.0.1:1117/v1 |
| CLI | 安装 CLI 后,在终端运行 edgespeak-cli serve。无需桌面 App。 | http://127.0.0.1:1118/v1 |
- CLI:在前台运行;保留终端,在另一个终端调用 API,按
Ctrl-C停止。未设置EDGESPEAK_API_KEY时默认无需认证,设置非空值后启动即要求验证该密钥。认证配置命令。 - 桌面 App:全新安装默认关闭「本地认证」,需要时在 App 内开启。
- 推理准备:完成登录或激活,再下载并加载模型。
下例默认连接桌面网关。使用 CLI 服务时,请将基础地址的端口改为 1118。
export EDGESPEAK_BASE_URL=http://127.0.0.1:1117/v1  # CLI: http://127.0.0.1:1118/v1

curl "$EDGESPEAK_BASE_URL/models"
示例约定:
| 项目 | 说明 |
|---|---|
| 运行环境 | Bash / zsh(Windows 可用 WSL 或 Git Bash)和支持 --fail-with-body 的 curl;jq、Python 3 按需标注。后续命令沿用同一 shell 环境。 |
| 示例开关 | 在页面上方选择与服务一致的认证方式,自动显示或省略密钥配置和请求头。 |
| 基础地址 | EDGESPEAK_BASE_URL 包含 /v1,末尾不加斜杠。 |
| 请求头 | 支持 Authorization: Bearer,也可改用 x-api-key: $EDGESPEAK_API_KEY。 |
| 密钥来源 | 见 API Key 的保存与更换。 |
| 示例内容 | 请替换示例文件和模型 ID。返回结果用于说明结构,节选或经过处理的输出会单独标明。 |
先用 GET /health 验证连接,再查询目录并准备模型,然后从下方索引选择接口。
完整接口索引
网关提供以下 HTTP 接口、健康检查别名、Realtime WebSocket 与 MCP 传输。/mcp 位于服务根路径,不在 /v1 下。
模型与服务 · 文本处理 · 转录与说话人 · 强制对齐 · 播报与声音库 · 语言与视觉 · Realtime 实时会话 · MCP 工具
模型与服务
| 方法与路径 | 指南与示例 |
|---|---|
GET /health | 检查服务状态 |
GET /v1/health | 检查服务状态 |
GET /v1/usage | 查看用量 |
GET /v1/models | 发现模型与能力 |
POST /v1/models/download | 开始下载模型 |
GET /v1/models/downloads | 查询下载进度 |
POST /v1/models/download/cancel | 取消进行中的下载 |
POST /v1/models/load | 加载本机模型 |
GET /v1/models/running | 查看运行中的模型 |
POST /v1/models/unload | 卸载运行中的模型 |
文本处理
| 方法与路径 | 指南与示例 |
|---|---|
POST /v1/text/segmentations | 切分句子 |
POST /v1/text/normalizations | 文本归一化:TN 与 ITN |
转录与说话人
| 方法与路径 | 指南与示例 |
|---|---|
POST /v1/audio/transcriptions | 转录音频文件 |
POST /v1/speaker/diarizations | 获取说话人活动时间轴 |
POST /v1/speaker/embeddings | 提取说话人声纹向量 |
POST /v1/speaker/similarity | 比较两个声纹向量 |
强制对齐
| 方法与路径 | 指南与示例 |
|---|---|
POST /v1/audio/alignments | 把已知文本对齐到音频 |
播报与声音库
| 方法与路径 | 指南与示例 |
|---|---|
GET /v1/audio/voices | 列出音色并选择兼容组合 |
POST /v1/audio/speech | 生成 WAV 播报音频 |
GET /v1/audio/speech/examples | 查询模型专属播报示例 |
POST /v1/audio/voices | 创建可复用的用户音色 |
DELETE /v1/audio/voices/:voice_id | 删除用户音色 |
语言与视觉
| 方法与路径 | 指南与示例 |
|---|---|
POST /v1/responses | 使用 Responses 生成 |
POST /v1/chat/completions | 使用 Chat Completions 生成 |
POST /v1/messages | 使用 Messages 生成 |
POST /v1/tokenize | 文本分词 |
Realtime 实时会话
| 方法与路径 | 指南与示例 |
|---|---|
WS /v1/realtime | 完成一次文字会话 |
MCP 工具
| 方法与路径 | 指南与示例 |
|---|---|
POST /mcp | 初始化与工具调用 |
API Key 的保存与更换
API Key 用于接口认证,License Key 用于激活软件。两种密钥不能互相替代。
桌面 App。 首次启动时自动生成 sk-edgespeak- 后接 64 位十六进制字符的密钥,保存在 App 数据目录,macOS 位于 ~/Library/Application Support/EdgeSpeak/gateway_api_key。在「本地网关 → 本地认证」页开关认证、查看密钥或「重新生成」,改动立即生效,无需重启。
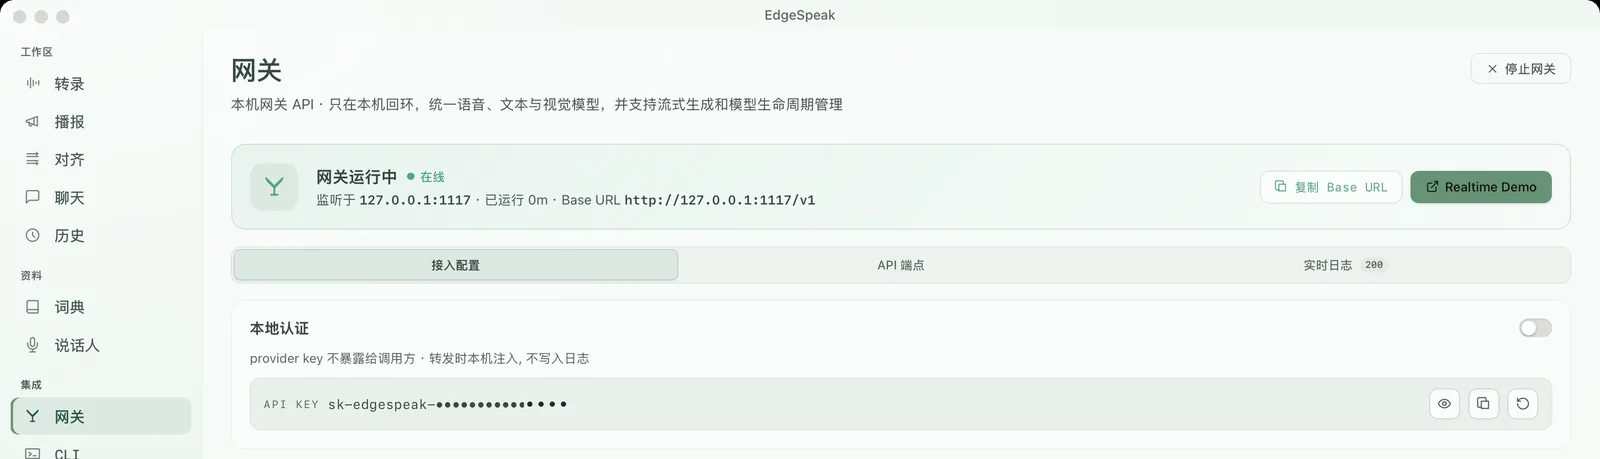
CLI。 transcribe、align、speech 等客户端命令按 --api-key、环境变量 EDGESPEAK_API_KEY、桌面 App 的 gateway_api_key 文件的顺序取密钥,因此 App 在运行时,CLI 命令无需配置即可通过认证。edgespeak-cli serve 只从 EDGESPEAK_API_KEY 读取密钥:它没有 --api-key 参数,也不会生成、保存或轮换密钥。默认回环监听 127.0.0.1:1118 时,不设该变量即为免认证;非回环监听必须设置该变量,或显式传 --allow-unauthenticated。启动时 stderr 打印 EdgeSpeak service authentication: … 告知当前认证方式,不会打印密钥本身。更换密钥即改环境变量后重启。
EDGESPEAK_API_KEY="your-long-random-secret" edgespeak-cli serve --host 0.0.0.0 --allow-remotesk-edgespeak-… 仅为示意,调用时请使用完整密钥。更换密钥不会追溯撤销已通过认证的请求或已建立的 WebSocket 会话;如需终止已有会话,需停止服务。CLI 的密钥处理。
从另一台机器调用 API
在具备所需 CPU / GPU 算力并已安装本机模型的机器上,可以直接启动 Headless 服务,无需安装或运行桌面 App。桌面网关仅供本机调用;如需允许其他机器访问,可让 edgespeak-cli serve 显式监听局域网或私有 VPN 地址。默认情况下,CLI 服务仅监听 http://127.0.0.1:1118/v1。
以下远程配置固定使用鉴权,不随示例开关省略密钥。
在服务端(运行服务的机器)上,先从受保护的密钥存储中读取一段足够长的随机密钥,再启动服务:
export EDGESPEAK_API_KEY="your-long-random-secret"
edgespeak-cli serve --host 0.0.0.0 --port 1118 --allow-remote
监听非回环地址时,若未传入 --allow-remote,服务会拒绝启动;同时必须设置非空的 EDGESPEAK_API_KEY(除非显式传入 --allow-unauthenticated)。仅在隔离的测试网络中才可关闭远程鉴权。
在调用端(发起调用的机器)上,将 192.168.1.50 替换为服务端实际使用的局域网或 VPN 地址,并使用同一个密钥:
export EDGESPEAK_BASE_URL=http://192.168.1.50:1118/v1
export EDGESPEAK_API_KEY="your-long-random-secret"

curl "$EDGESPEAK_BASE_URL/models" \
  -H "Authorization: Bearer $EDGESPEAK_API_KEY"
0.0.0.0 仅为服务端监听地址,不能写入客户端 URL。若 EdgeSpeak 能唯一识别可用网卡,启动日志会输出可直接复制的 EdgeSpeak service network URL。模型下载与管理、推理及 License 验证均由服务端负责;调用时的音频、文本、图片和响应数据将在两台机器间传输。
Headless 服务与桌面 App 采用同一套网关实现,接口路径与请求格式完全一致,差异在于基础地址和 API Key。两类输入仅支持桌面端:流式转录(stream=true)在 Headless 服务上调用返回 400;本机文件路径同样不支持。Headless 服务只接收上传的数据字节,因此对齐接口请传 text 而非 text_path,分句接口请传 segments[] 而非 file。
Headless 服务只提供 HTTP,不内置 HTTPS。请仅在可信的局域网或私有 VPN 中使用,并通过服务端防火墙将 TCP 1118 端口限制在可信来源范围内。也可以继续监听默认回环地址,再通过 SSH 隧道从另一台机器访问:
ssh -L 1118:127.0.0.1:1118 user@edgespeak-host若客户端运行在浏览器中,需通过 --allow-origin https://your-app.example 添加页面来源。若 HTTPS 反向代理把 Host 请求头改为域名,请通过 --allow-host gateway.example 将该域名加入允许列表;直接使用 IP 地址调用时无需配置 --allow-host。安装和启动方式见 CLI 服务说明。
音频与文本
支持转录上传媒体、对齐已知文稿、语义分句、播报,以及管理可复用的本机声音。转录支持 json、verbose_json、text、diarized_json,以及 JSON 模式的 SSE 流;verbose_json 与说话人输出支持时间戳粒度。接口路径见完整接口索引。
音频请求参数
参数直接命名:JSON 与 multipart 使用 snake_case,HTTP 请求头使用连字符名称,不加产品前缀或包装对象。响应元数据扩展保持原格式。
| 参数 | 说明 |
|---|---|
| Speech JSON | language、seed、sample_rate 及模型支持的采样参数放在顶层。 |
sample_rate | 省略时使用模型原生采样率。HTTP 默认流式输出;桌面端只接受与原生率一致的显式值,流式重采样返回 400;Headless 服务或独立 Host 拒绝显式值。 |
| Realtime | 使用 session.input_audio_mode 与 session.reasoning_effort。 |
转录与对齐共用以下 multipart 字段。省略时继承服务设置;传入句长或边距字段会请求语义处理。
| 参数 | 说明 |
|---|---|
semantic_sentence_enabled | 控制语义处理;显式设为 false 时不能与句长或边距字段同用,否则返回 400。 |
min_chars / max_chars | 单句字符数限制,出厂值分别为 12 与 42。长度约束默认关闭,传入任一长度字段即开启。 |
start_margin / end_margin | 单位为秒;前后边距出厂值均为 0.2 秒。 |
| 参数 | 说明 |
|---|---|
audio_track | 仅对齐:从 0 开始的可解码音轨序号。 |
audio_channel | 仅对齐:mix 或从 0 开始的声道序号。 |
candidates | 仅转录,需服务支持 N-best。1 为普通结果;2–8 要求非流式 verbose_json,且不请求词级时间戳。 |
上述三个参数重复传入不同值时返回 400。
转录可通过 word_timestamp_enabled 控制词级时间戳。旧的带产品前缀请求字段已下线。独立分句接口 /v1/text/segmentations 始终执行切分,不接收 semantic_sentence_enabled;具体输入与段落模式见下文。
对齐与文本归一化
POST /v1/audio/alignments · multipart
| 参数 | 说明 |
|---|---|
file | 上传音频文件。 |
text / text_path | 提供待对齐文本 text。桌面网关与 Headless 服务的输入差异见从另一台机器调用 API。 |
model | 对齐模型,可省略。默认配置与语言覆盖见对齐请求。传入转录或播报模型返回 400 model_capability_unsupported;传入不存在的模型 ID 返回 404 model_not_found;两者都带 param: "model"。 |
language | 语言提示,可省略。省略、具体语言代码与 und 的三态语义见对齐请求;代码写法与各模型覆盖范围见语言代码。 |
start / end | 裁剪区间,需同时提供,单位为秒,满足 0 ≤ start < end 且位于音频时长范围内。 |
search_effort | 搜索范围:standard(默认)、extended(范围更大,更慢,更耗内存)或 auto(服务建议重试时自动用 extended 再跑一次)。其他取值返回 400,param 为 "search_effort"。见处理对齐失败。 |
返回时间戳相对于原始音频;duration 为完整媒体时长,usage.seconds 为实际处理窗口。
protected_terms[] 可重复传入,也可传入 protected_terms JSON 数组。text_normalization 在 multipart 中为 JSON 字符串:
curl "$EDGESPEAK_BASE_URL/audio/alignments" \
  -F model=EdgeSpeak/Lattice-2 \
  -F file=@meeting.m4a -F text="The total is 42 dollars." -F language=en \
-F 'text_normalization={"enabled":true,"top_k":8}'| 参数 | 说明 |
|---|---|
enabled | 省略整个 text_normalization 时默认开启;设为 {"enabled":false} 或空对象关闭。 |
top_k | 候选数,默认 8,范围 1–16。 |
classes | 限定归一化类别。 |
apply_dictionary / dictionary_ids | 前者默认 false;开启后应用词典,后者可限定词典 ID。 |
pins | 使用 {source_start_byte, source_end_byte, rank} 选择区域候选。范围相对于原始 UTF-8 文稿;rank:null 保留原文。 |
关闭文本归一化时不能传 top_k、classes 或非空 pins。响应中的 language、normalization_regions 与词级 provenance 见 JSON 契约。
需要对齐进度时发送 progress: 1 请求头,响应为 NDJSON 进度流;普通请求返回单个 JSON。
分句与段落切分
POST /v1/text/segmentations 使用 JSON。普通输入选择纯文本 text 或带时间戳的 segments[];桌面网关还支持通过 file 读取导出的 Transcript JSON 文件,Headless 服务请直接传入 JSON 内容。完整导出对象中的 task 与摘要 text 可以伴随 segments[] 一起传入。
默认分句阈值 threshold=0.35。传入 paragraph_threshold 即启用段落切分,每个 segments[] 元素代表一个段落,段内保留多个句子;顶层 text 用 \n\n(空行)连接段落。
curl "$EDGESPEAK_BASE_URL/text/segmentations" \
  -H "Content-Type: application/json" \
-d '{"text":"第一句话。第二句话。接下来讨论另一个话题。","threshold":0.35,"paragraph_threshold":0.5}'| 参数 | 说明 |
|---|---|
threshold | 分句阈值,默认 0.35;有限数,范围 0–1。 |
paragraph_threshold | 传入即启用模型原生段落边界;有限数,范围 0–1,且不小于 threshold。省略则分句。 |
| 段落输入 | 只接受纯文本 text;与 segments[]、Transcript file、句长或边距字段同用返回 400。 |
| 段落输出 | 关闭继承的句长与边距处理;不生成时间戳或说话人。 |
paragraph_threshold 与句长、边距字段也可放在 options 中,同名顶层字段优先。CLI 对应 segment --paragraph-threshold 0.5。
独立文本归一化
POST /v1/text/normalizations 将书面形式转换为读法(mode:"tn"),或将读法转换回书面形式(mode:"itn"),不需要音频。接口拒绝未知请求字段,文本归一化不消耗音频时长配额。
language 必填,支持列表与 und 的含义见语言代码。支持的语言与类别见 /v1/models 中 Skylark 条目的响应元数据 x_edgespeak.normalization.languages_by_mode 与 classes_by_language。
参数表、完整正文输入、TN / ITN 输出及 span 解释见文本处理示例。
播报与声音
POST /v1/audio/speech · JSON
| 参数 | 说明 |
|---|---|
model / voice | 必填;声音 ID 从 /v1/audio/voices 获取。 |
input / segments[] | 提供 input 或非空 segments[]。分段共用顶层模型,可单独配置 input、voice、instructions、disable_style、speed、language。 |
response_format | 使用 wav。 |
stream_format | 默认 audio,响应本身即为流式音频;sse 返回 speech.audio.delta 与 speech.audio.done。 |
以下控制项直接放在 JSON 顶层,按模型支持范围选用:
| 参数 | 说明 |
|---|---|
| 语言与随机性 | language、seed |
| 采样与生成 | guidance_scale、inference_steps、temperature、top_p、top_k、repetition_penalty |
| 风格、重试与克隆 | instructions、disable_style、clone_mode、retry_badcase、clone_recipe;前三项见风格指令、克隆档位与声音设计 |
| 发音与控制 | user_marks、phonetic_spans、control_policy |
所选模型不支持请求的语言时返回 HTTP 422 language_unsupported,应换用支持该语言的模型,各模型的语言见语言代码;参数组合不被模型接受时返回 HTTP 400 bad_request。两者都需要改请求,原样重试不会成功;HTTP 500 speech_failed 才表示本机合成失败。
GET /v1/audio/speech/examples 提供模型专属播报示例,可按 model、mode、language、id、recipe 筛选。模型目录中的 features、instruction 与 x_edgespeak.output_audio.sample_rate 描述能力和原生采样率。
POST /v1/audio/voices 的 multipart 参数、audio_sample 上限与 language 默认值见创建可复用的用户音色。
说话人
需要带说话人标签的文稿时使用 diarized_json;只需要说话人活动时间线时调用 POST /v1/speaker/diarizations。还支持提取说话人声纹向量并计算余弦相似度,用于本机匹配。num_speakers 只是可选的聚类提示,不代表真实身份;说话人标签是本次音频内的聚类编号。说话人端点接收上传的音频字节,不接受任意本机路径。
参数、请求与响应示例见获取说话人活动时间轴。CLI transcribe --diarize 与本组接口的对应关系见 API 复用。
Realtime API
通过 WebSocket 建立实时转录会话,或完整的转录 → 语言模型 → 播报会话。先发送 session.update,再持续追加 Base64 编码的 PCM16LE 单声道音频。服务端客户端可以使用普通鉴权 Header;开启网关鉴权时,浏览器 WebSocket 客户端在 realtime 之外增加 openai-insecure-api-key.<KEY> 子协议。上方开关也会切换此连接示例。本机语言模型用于 Realtime 前需要预先加载。
const ws = new WebSocket(
  "ws://127.0.0.1:1117/v1/realtime",
  ["realtime"]
);事件顺序、session.audio.input.format、session.input_audio_mode、音频输出采样率以及手动 / server_vad 提交方式见 Realtime 实时会话。
语言与视觉 API
根据客户端选择 OpenAI Responses、Chat Completions、Anthropic Messages 或分词接口。并非每个模型都支持全部端点;请从 /v1/models 读取 supported_endpoints,并检查 execution_location。本机模型的推理与数据都在端侧;已配置的远程模型会接收转发的请求。
路径清单见完整接口索引;四个接口的请求与响应示例见语言与视觉。
原生视频输入
macOS 和 Linux 的原生视频构建支持在 POST /v1/chat/completions 中向已安装的本机多模态模型传入 input_video。桌面网关与 Headless 服务使用同一套按模型区分的预处理。Realtime WebSocket 会话不接受 input_video;其中的图片事件是静态图片,不是连续视频流。
EdgeSpeak 根据当前模型的目录配置或导入仓库元数据自动选择采样率;它不是请求字段,也不是 Server 启动参数:
| 本机模型家族 | 采样率 | 参考预处理 |
|---|---|---|
| Qwen 3.5 / Qwen 3.6 | 2 FPS | Qwen 示例使用 fps=2.0 并启用抽帧 |
| Gemma 4 | 1 FPS | Gemma 按 1 FPS 说明视频容量 |
这些数值依据模型发布方的参考预处理,而不是源视频自身的帧率。切换模型家族时,本机 worker 会使用对应数值重启。参考 Qwen 3.5、Qwen 3.6 与 Gemma 4 模型文档。
桌面 App 从 Hugging Face 或 ModelScope 导入 GGUF 仓库时,会尽力读取仓库根目录的 config.json、tokenizer_config.json 与 processor_config.json。检测到的 video_processor.fps 会作为推荐值;缺少元数据时,已知 Qwen 与 Gemma 家族采用上表数值,其他包含 mmproj 文件的仓库默认使用 1 FPS。若 config.json 声明了视觉模块但缺少可用的 mmproj,界面会显示警告,不会误判为可运行的视觉模型。用户可以在「模型 → 生成设置」中改为 1、2、4 或 8 FPS。采样帧越多,通常时间覆盖越完整,但也会消耗更多视觉 token、上下文、内存和处理时间。
在 Chat Completions 内容项中传入视频文件字节的 Base64 编码:
{
  "model": "Qwen/Qwen3.5-4B",
  "messages": [
    {
      "role": "user",
      "content": [
        { "type": "text", "text": "请按时间顺序概括这段视频。" },
        { "type": "input_video", "input_video": { "data": "<base64 MP4 bytes>" } }
      ]
    }
  ]
}
视频解码要求服务所在机器同时提供 ffmpeg 和 ffprobe。EdgeSpeak 不内置这两个工具;macOS 可通过 Homebrew 安装 ffmpeg,Linux 可使用系统包管理器安装。完整 JSON 请求上限为 512 MiB,而 Base64 会使源文件体积增加约三分之一,因此请使用时长较短、尺寸适当的视频。
上下文窗口
文本输入、对话历史、图片或视频采样帧转换出的视觉 token,以及模型输出,共享同一份上下文预算。上下文越大,可容纳的历史或视频内容越多,但会占用更多内存或显存分配 KV 缓存;上下文越小,能给模型和其他任务留下更多内存,但请求会更早达到长度上限。
在桌面 App 中,打开本机模型卡片的「模型 → 生成设置 → 上下文长度」。默认自动值为 8K,也可以从 4K 开始选择,最高不超过模型支持的上限。目录模型使用目录声明的上限;从 Hugging Face 或 ModelScope 导入的模型会依次检查 max_position_embeddings(含嵌套的文本/语言配置)或 model_max_length、已知模型家族上限,全部缺失时再以 262K 作为可选上限兜底。设置按模型分别保存;保存后会卸载当前本机模型,下一次请求再按新的上下文长度加载 worker。
Headless 服务使用独立的启动配置,不读取桌面端偏好。启动时传入 --context-tokens;默认值为 8192 token,可接受范围为 512–262144,且不应超过当前模型支持的上限。修改后需重启对应的 Headless 服务进程。
edgespeak-cli serve --context-tokens 32768模型发现与生命周期
通过 /v1/models 获取规范模型 ID,查看正在运行的模型,并显式加载或卸载本机语言模型以控制下载状态和内存。模型下载可以发起、查询进度和取消。
路径清单见完整接口索引;目录字段、生命周期请求与响应示例见模型与服务。
MCP
Agent 场景推荐通过 edgespeak-cli mcp 使用 stdio;POST /mcp 位于服务根路径,不在 /v1 下。
通道对照、鉴权与 HTTP 调用示例见 MCP 设置。
几个工具与对应 HTTP 接口保持同一套写法:
| 工具 | 与 HTTP 接口一致的部分 |
|---|---|
edgespeak_align | result 带 task(恒为 align)、text(请求原文)、segments 与 usage,形状与 POST /v1/audio/alignments 相同,按分句偏好切段,分句关闭时是一段全文。顶层 words 保留,与 segments[].words 按顺序拼起来相同。 |
edgespeak_create_speech | 可选 instructions、disable_style(true 不能与非空 instructions 同给)和 clone_mode(quick / ultimate),voice 接受 builtin:design;规则见风格指令、克隆档位与声音设计。 |
edgespeak_create_response | 可选 translation,与 /v1/responses 顶层 translation 同形(target_language、language_pair、source_language、style),见指定翻译语向。 |
错误、浏览器访问与安全
License、配额、鉴权、模型就绪状态和运行时繁忙等失败均返回结构化错误响应。无 Origin 的非浏览器客户端可正常访问,但仍会检查 Host。浏览器请求默认只允许回环地址来源;若要接入可信的非回环来源和代理 Host,需要通过环境变量显式加入允许列表。切勿把长期有效的 API Key 写入公开前端代码。
401  invalid or missing API key
403  host or origin is not allowed
413  request body too large (JSON 512 MiB; transcription / alignment upload 16 GiB)
503  model_downloading              # honor Retry-After

EDGESPEAK_GATEWAY_PORT=1117
EDGESPEAK_GATEWAY_ALLOWED_ORIGINS=https://app.example.com
EDGESPEAK_GATEWAY_ALLOWED_HOSTS=proxy.example.com
读取并处理错误
服务已正常授权且就绪时,下列参数错误的请求返回 400。-i 同时展示 HTTP 状态与响应体。
curl -i "$EDGESPEAK_BASE_URL/text/segmentations" \
  -H "Content-Type: application/json" \
  -d '{"text":"Hello world.","threshold":2}'
响应体示例(HTTP 400):
{"error":{"message":"'threshold' must be within [0, 1]","type":"invalid_request_error","code":"bad_request","param":"threshold"}}程序逻辑依据 error.code,输入位置依据 error.param。400 表示参数要先改对再重试,401 表示 API Key 不对。403 可能是 Host / Origin 未在允许列表,也可能是授权被拒,读具体错误码判断。model_downloading 或服务繁忙返回 503 时按 Retry-After 重试,413 则要缩小上传内容。/v1/messages 使用 Anthropic 错误信封,远程模型错误可能保留提供方原生信封。SSE 和 WebSocket 需按对应协议处理错误事件;HTTP 200 本身不代表流已成功完成。